Transformer LLM 與 DiTs 誰的成本更昂貴?
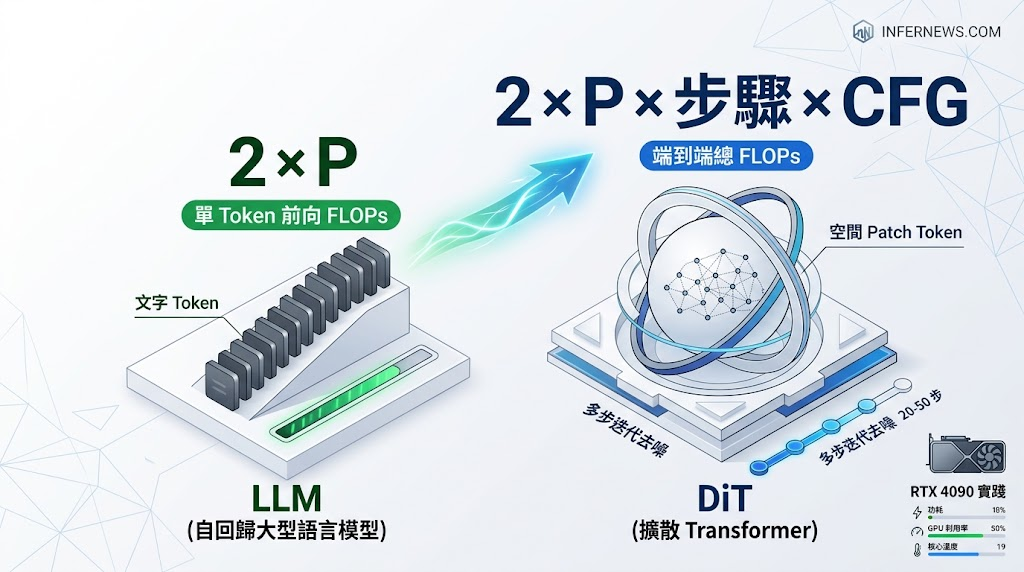
生成 1 個 Token 的代價:LLM 與 DiT 算力瓶頸剖析、RTX 4090 實踐與關鍵監控指標校正
在當前生成式 AI 架構中,自回歸大型語言模型(Autoregressive LLM)與擴散 Transformer(DiT)雖然底層皆基於注意力機制(Self-Attention),但在「產生 1 個 Token」的物理意涵、硬體資源瓶頸與產出代價上存在本質差異。本文除了深入剖析兩者的架構開銷,更提供一套可在消費級旗艦顯示卡(NVIDIA GeForce RTX 4090)上穩定運行的實體監控腳本,並特別針對業界最常誤讀的 utilization.memory 核心指標進行深度釐清。
1概念解構:離散文字 Token vs 空間 Patch Token
在評估運算成本前,必須先區分兩者對於「Token」定義上的根本歧異:
自回歸語言模型(Transformer LLM): 採用一維離散文字切分(如 BPE、WordPiece)。生成 1 個 Token 代表由模型在詞彙庫(Vocabulary)中預測下一個單字的機率分佈。此 Token 一旦完成採樣便永久固定,並直接寫入 KV 快取(KV Cache)供後續遞推使用,不需要再次重新計算。
擴散 Transformer(DiT): 借鑑 Vision Transformer(ViT)邏輯,將 VAE 編碼後的連續潛在特徵圖(Latent Feature Map)切分成多個固定尺寸的空間區塊(Patches,例如 2×2 或 4×4)。每個 Patch 即為 1 個視覺 Token。但不同於文字的是,該視覺 Token 並非一次生成完畢,而是在連續多步(如 20~50 個 Timesteps)去噪過程中,與全域 Token 共同在雙向注意力機制下持續被更新與覆寫。若啟用文生圖或文生影片常見的無分類器引導(Classifier-Free Guidance, CFG),每一步去噪還需同時執行條件(Conditional)與非條件(Unconditional)兩次完整前向傳播,使計算開銷直接翻倍。此外,在所有去噪步驟完成後,還必須經過 VAE 解碼器(VAE Decoder)將潛在特徵還原為像素影像,帶來額外的顯存峰值與運算延遲。
2硬體架構瓶頸:記憶體頻寬 vs 算力密集
不同的生成模式決定了兩者在 GPU 運算單元上的資源受限維度:
值得強調的是,在單並發或單請求(Batch Size = 1)的情境下,LLM 解碼極度受限於記憶體頻寬,因為 GPU 必須將數十億甚至百億規模的完整權重矩陣從 HBM/顯存載入至高速快取,卻僅為這單一 Token 計算長度為 1 的查詢向量,導致硬體算力利用率(MFU)通常低於 30%。只有透過連續批次處理(Continuous Batching)將 Batch Size 放大,LLM 才能逐步轉移為運算密集型;相對地,DiT 天然具備成百上千個空間 Patch Token 同步並行,即使在單張影像生成時也能輕鬆榨乾張量核心算力。
3成本對決:單 Token 到可用輸出的總量分析
我們將自回歸 LLM 與 DiT 在推論架構與成本維度進行橫向對比:
| 評估維度 | Transformer LLM (自回歸解碼) | Diffusion Transformer (DiT 去噪) |
|---|---|---|
| 生成機制 | 因果單向(Causal Auto-regressive)逐字遞推 | 雙向全注意力(Bidirectional)多步反覆迭代去噪 |
| Token 生命週期 | 一次生成,永久固定,快取至 KV Cache | 跨步驟迭代更新(通常歷經 20~50 次重算) |
| 硬體資源瓶頸 | 單請求(Batch = 1)下極度受限於記憶體頻寬 | 運算單元算力(FLOPs / Compute Bound) |
| 單 Token 前向 FLOPs | 約 $2 \times P$(*註:密集矩陣乘法估算) | 約 $2 \times P$(*註:密集矩陣乘法估算) |
| CFG 額外倍率 | 無(原生支援條件文字生成) | 通常啟用 CFG,單步前向次數 $\times 2$ |
| 硬體利用率 (MFU) | 單請求較低;依賴高批次(Large Batching)提升 | 單請求即具備高並行度,GPU 利用率較高 |
| 端到端交付代價 | 按生成 Token 數量計費,單 Token 絕對成本極低 | 單幅影像累積數千 Token $\times$ 多步驟 $\times$ CFG,加上 VAE Decode 顯存與算力開銷,總成本極高 |
4RTX 4090 實體監控腳本與指標定義校正
為了在伺服器端或工作站精準捕捉推論時的真實硬體開銷,工程師常調用 Shell 指令碼進行採樣。針對消費級旗艦 NVIDIA GeForce RTX 4090,雖然缺乏資料中心級的 ECC 錯誤統計與 DCGM 守護行程,但透過 NVML 的基礎查詢,依然能完整擷取核心算力、記憶體、功耗與散熱指標。
許多工程師容易將
utilization.memory 誤解為「顯示卡記憶體已使用的容量百分比(VRAM Usage %)」,這是一個非常嚴重的誤解!根據 NVIDIA NVML 官方技術規範:
•
utilization.memory(記憶體控制器利用率): 代表在過去的取樣週期內,GPU 記憶體控制器(Memory Controller)處於讀取或寫入活躍狀態的時間百分比。它反映的是記憶體存取頻寬的忙碌程度,而非容量。•
memory.used / memory.total(顯存空間使用率): 若要評估「目前 24GB 顯存被模型權重、KV 快取或去噪特徵佔用了多少空間」,必須由 memory.used 數值除以 memory.total 換算得出。
以下為針對 RTX 4090 最佳化編寫的實體監控腳本:
#!/usr/bin/env bash
# ==============================================================================
# NVIDIA RTX 4090 推論環境專用效能與熱能監控腳本
# 適用專案:vLLM, Ollama, ComfyUI, TensorRT-LLM 伺服器
# ==============================================================================

set -euo pipefail

LOG_FILE="rtx4090_profile_$(date +%Y%m%d_%H%M%S).csv"
INTERVAL=1

echo "[資訊] 正在初始化 RTX 4090 監控管線..."
echo "[資訊] 取樣數據將即時寫入: ${LOG_FILE}"

# 寫入 CSV 標題列(特別區分記憶體控制器頻寬與顯存容量)
# mem_ctrl_busy_pct = utilization.memory(記憶體匯流排忙碌百分比)
# mem_used_mb       = 實際顯存佔用容量 (MB)
echo "timestamp,gpu_util_pct,mem_ctrl_busy_pct,mem_used_mb,mem_free_mb,power_draw_w,temp_c,fan_speed_pct,sm_clock_mhz" > "${LOG_FILE}"

trap 'echo -e "\n[完成] 監控行程已中止,日誌完整儲存。"; exit 0' INT TERM

while true; do
    TIMESTAMP=$(date -u +"%Y-%m-%dT%H:%M:%SZ")

    # 透過 nvidia-smi 擷取專屬指標(排除企業級無效欄位)
    STATS=$(nvidia-smi --query-gpu=utilization.gpu,utilization.memory,memory.used,memory.free,power.draw,temperature.gpu,fan.speed,clocks.current.sm \
        --format=csv,noheader,nounits | tr -d ' ')

    echo "${TIMESTAMP},${STATS}" >> "${LOG_FILE}"
    sleep "${INTERVAL}"
done
5消費級環境關鍵注意事項與溫控陷阱
在 RTX 4090 上實測 LLM 與 DiT 推論時,需特別防範硬體邊界對實驗數據的干擾:
1. 散熱降頻(Thermal Throttling): 消費級顯示卡散熱多依賴風冷散熱片。在長時間運算 DiT 等計算密集型任務時,核心溫度若突破 83°C,顯示卡會主動壓低串流多處理器時脈(SM Clock),導致推論耗時被動拉長,產生非線性的效能誤差。
2. 24GB 顯存硬限制(OOM 崩潰風險): 相較於資料中心級加速卡(如 A100 80GB),RTX 4090 的顯存相當緊湊。在自回歸 LLM 單請求長上下文或高並行推理時,需嚴密監控 mem_used_mb,防範 KV 快取碎片化溢位;而在執行高解析度 DiT 生成時,最後階段的 VAE 解碼往往會產生突發性顯存峰值(VAE Spike),若顯存不足建議開啟分塊解碼(Tiled VAE Decode)以防程式崩潰。