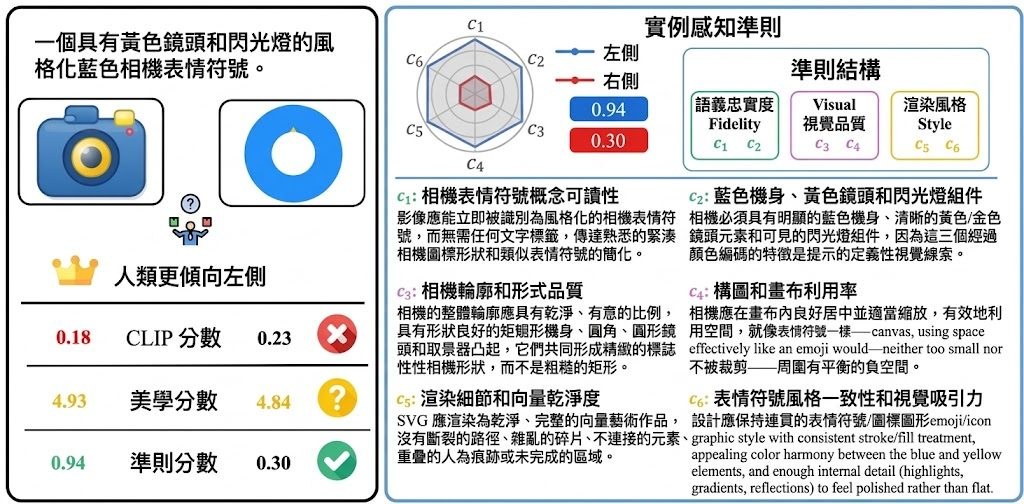
想把「畫一個指向東北的指南針」轉成SVG,模型要同時掌握主體、方向和風格;但這類開放式生成通常沒有唯一正確圖像,傳統分數未必能指出作品究竟錯在哪裏。RULER是一套用於SVG生成評估及強化學習訓練的方法,嘗試把籠統分數拆成可逐項檢查的要求。
它會只根據文字指令,為每個生成任務建立六項評分準則,涵蓋語意、視覺和風格,再由視覺語言模型評分渲染後的作品。各項得分按權重合成較細緻的獎勵,供 Group Relative Policy Optimization(GRPO)優化模型;整個流程不需要配對SVG標準答案或人工偏好標籤。
這種做法針對的是CLIP、Aesthetic等單一分數難以判斷SVG細節,也可能令強化學習模型迎合分數、產生 reward hacking 的問題。研究團隊表示,多軸評分比單一指標更貼近人類判斷;在MMSVG-Illustration和MMSVG-Icon上,rubric分數分別由0.432升至0.693,以及由0.395升至0.683,並超越專門SVG模型,表現可媲美規模大得多的DeepSeek-V3。
- 每條指令會生成專屬評分準則,而非所有作品共用一把分數尺。
- 評分同時檢查語意、視覺和風格,獎勵可用於GRPO訓練。
- 不需要標準SVG圖像或人工偏好標籤,適合缺少標註資料的生成項目。
- 評測結果顯示評分準則的設計是提升開放式SVG生成的重要因素。