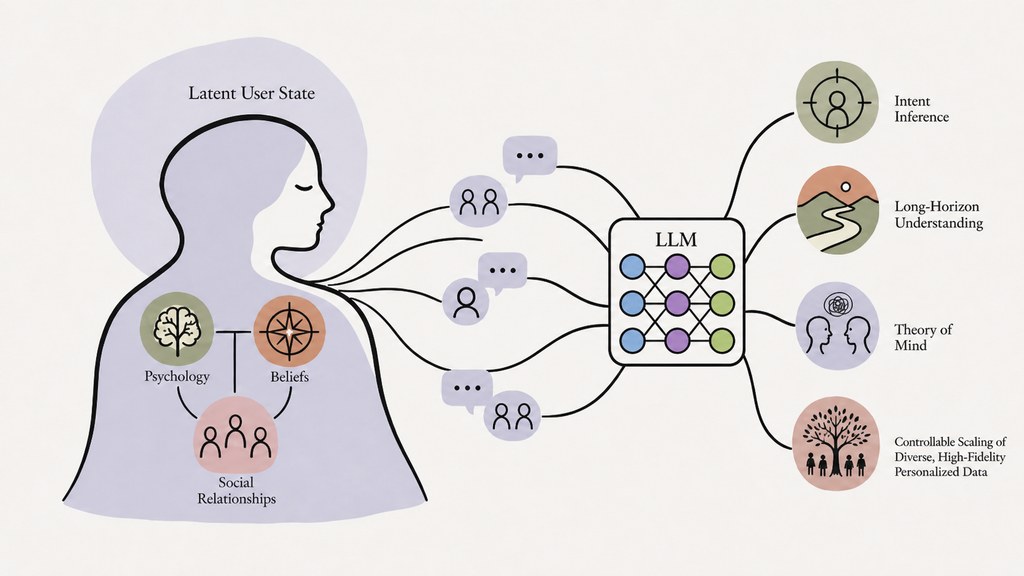
現時很多聊天模型在多輪對話中表現不錯,但一到「這個用戶其實想要什麼、心情如何、跟上一句話背後的脈絡」就容易失去線索。Mind2Dialogue 直接在訓練階段把這個缺口補上:模擬器跟一個 Oracle 助理共用同一個會隨對話演化的用戶狀態,Oracle 寫出的回覆就成為學生模型的訓練目標;學生模型在訓練時只看到 persona 與對話紀錄,要自行還原背後狀態。
整個流程由六個階段組成:規模化產生 persona 種子情境、批次生成對話、用 LLM 作評審過濾低質樣本、從對話抽取 QA 對、語料改寫增廣,最後做微調與評估。設計上刻意把模擬者、Oracle、評審分成不同模型端點,避免自我評分,也容許把較強模型放在 Oracle 位置。情境類型涵蓋終生關係、高頻互動、情緒事件與敏感議題,使訓練語料貼近真實長期陪伴的場景。
在 Qwen2.5-7B-Instruct 上,個人化指標 PrefEval-Gen 比基礎模型高 33.4 分,PersonaMem-v2 高 10.0 分,並在同骨架下壓過加記憶模組與其他個人化方法。Qwen 與 Llama-3.1-8B-Instruct 在 BigToM 等 Theory-of-Mind 基準上也同步進步,代表個人化與心智理論可能共享同一種「從觀察推回未觀察狀態」的能力。OLMo-3-8B-Instruct 則未見轉移,顯示效果仍受骨架預訓練影響。
隨訓練資料量由八分之一擴到全量,三個骨架的個人化分數都穩步上升,呼應「資料規模足夠,學生才能學會狀態還原」這個核心假設。對做對話系統、角色 AI、AI 陪伴或客服助手的研究團隊,這套管線可作為不需要逐句人工標註的個人化資料生成起點;對關心評測的研究者,內附 LLM-as-judge 與消融設定(full、no_privilege、no_state、latent 等)便於追溯不同監督訊號的貢獻。
重點摘要:
- 共享狀態模擬:模擬器與 Oracle 共用演化中的用戶狀態,Oracle 回覆成為學生訓練目標
- 零人工標註管線:六階段流程從 persona 種子到微調皆可批次執行
- 個人化與 ToM 同步提升:Qwen 與 Llama 在 PrefEval-Gen、PersonaMem-v2、BigToM 上均有明顯改善
- OLMo 未見轉移:效果依賴骨架預訓練特性,OLMo-3-8B-Instruct 在 ToM 上反而下跌
- 資料越多越好:從 1/8 到全量語料,三個骨架的個人化分數持續上升