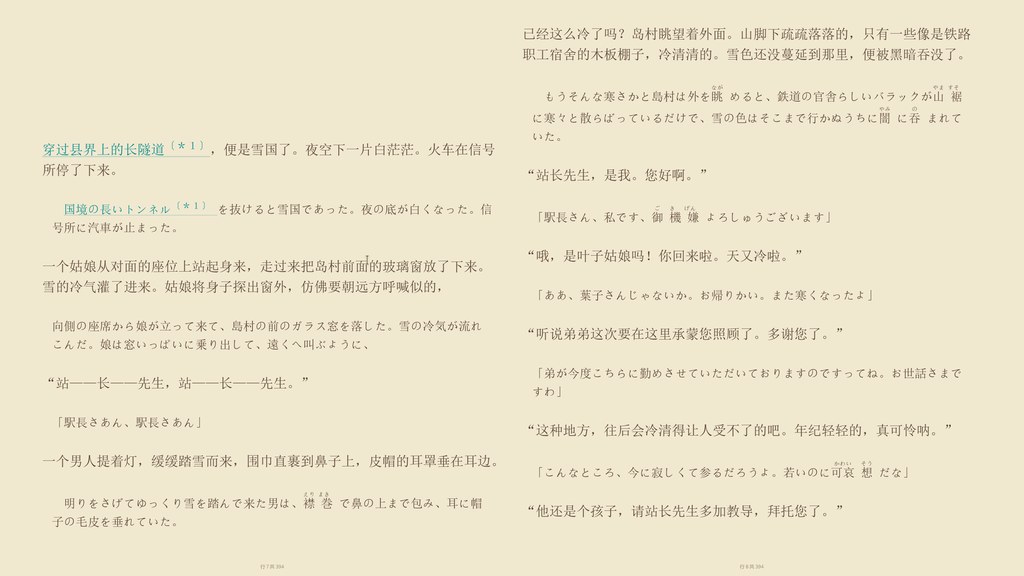
好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。
工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。
操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。
要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。
重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版