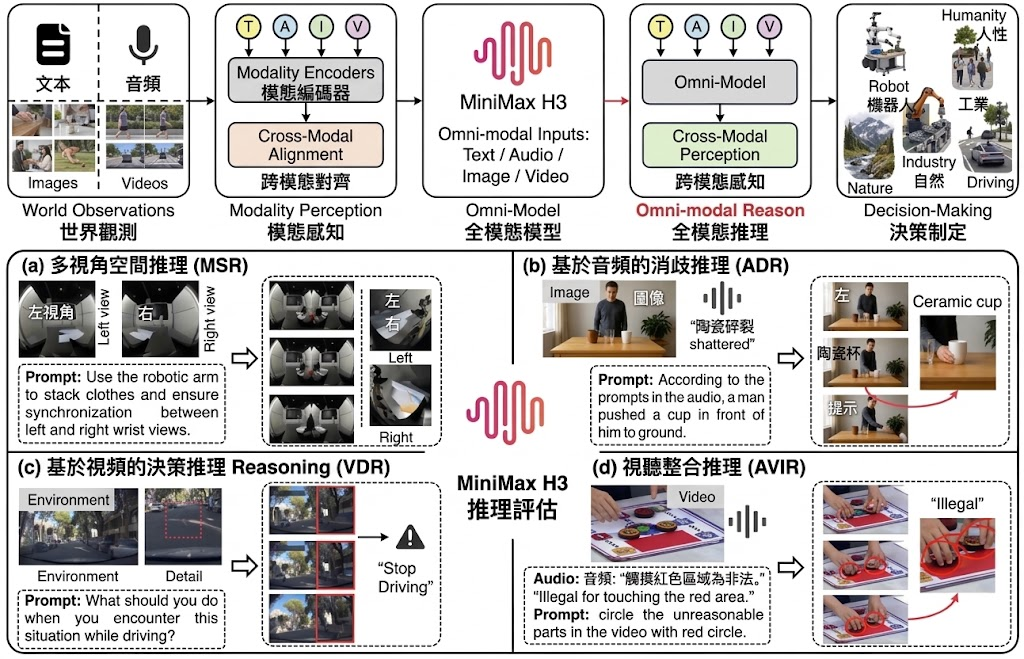
面對一段被刻意刪去關鍵資訊的指令,模型要靠圖像、聲音或前段影片這些「不在文字裡」的線索去補完事件,這正是這個評估項目想驗證的能力。它屬於研究類型的基準測試(Benchmark),專門設計來測 omni-modal 生成模型在物理世界推理上的表現,而不是單純比較畫質或動作流暢度。
整個框架圍繞四個場景展開:MSR 多視角空間推理、ADR 聲音消歧推理、VDR 影片決策推理,以及把聲音與影片約束結合的場景。每個場景都要求模型在 200 張圖、146 段聲音、影片前段等不完整輸入下,推斷出合理後續,並由專家判斷生成結果是否真的滿足語意要求,而非只追求像素相似。
MiniMax-H3 在這 517 個案例中整體成功率為 41.97%,差距明顯落在不同場景之間:影片決策推理最高,達 56.00%;聲音消歧推理最弱,只有 27.40%。這個落差直接說明,當聲音要承擔解開視覺模糊的責任時,模型很容易抓錯重點;反之,延續已觀察到的動態相對容易,因為線索更密集、更接近訓練分佈。
對做影片生成、世界模型或多模態整合的團隊來說,這套測試比起傳統 FID 或描述相似度更能反映真實瓶頸。它告訴我們,「支援多模態輸入」和「能可靠完成任務」之間仍有很大距離,尤其在聲音與畫面的細節對齊上。開發者可以用它找出弱項,研究者則能以此為基準,比較下一代模型是否真的在「聽懂並接住物理世界」這件事上有所進步。
重點摘要:
- 任務描述刻意不完整,逼模型從圖像、音訊或影片中補回缺失資訊
- 四個場景涵蓋空間、聲音、時間與音畫對齊四類物理推理
- MiniMax-H3 整體成功率 41.97%,影片延續最易、聲音消歧最難
- 由專家判斷生成結果是否滿足語意,而非僅看畫面或動作
- 對開發 omni-modal 影片生成與世界模型的團隊,是更貼近實戰的評估方式