在 SWE-Bench Verified、Terminal-Bench 2.1 呢類基準上,坊間討論往往直接以「Claude 用某個 harness 表現最好」作結,例如 Cao et al. (2026) 比較後發現 Claude-Opus-4.5 配 OpenHands 最強,而 Claude-Sonnet-4.5 則在 SWE-Agent 上表現較佳。問題係,當我哋直接比較兩個完整嘅 harness,所觀察到嘅差異其實係 plan、action space、context management 三個零件同時變化嘅結果——換句話講,「邊個 harness 比較好」呢條問題,根本答唔到「邊個零件有用」。作者指出,以往研究多把 harness 視為單一系統去比,結果令個別零件嘅效用難以釐清。
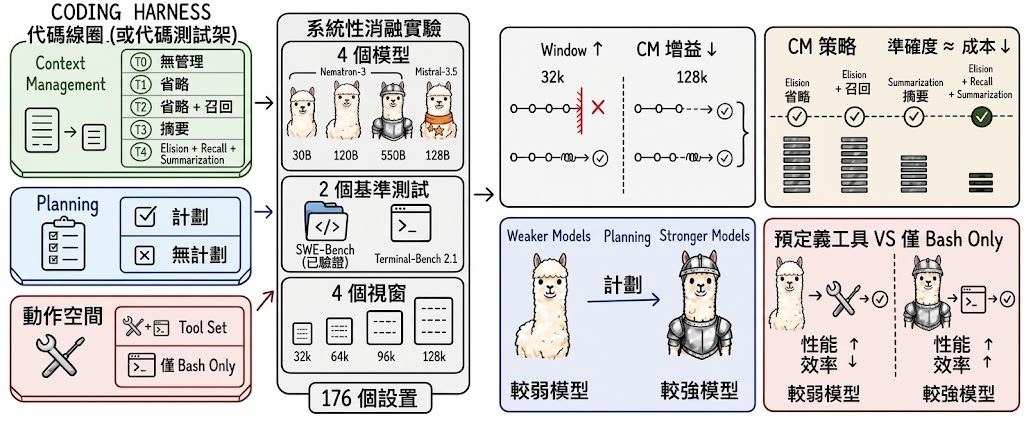
為咗拆開睇,呢篇論文用咗一個輕量級 coding harness,固定執行迴圈,只改動三個零件:規劃、動作空間、上下文管理。團隊用四個模型喺 SWE-Bench Verified 同 Terminal-Bench 2.1 上測試咗 176 個配對設定,涵蓋五種上下文管理策略、四種上下文視窗預算,再加規劃同動作空間嘅針對性消融。
研究發現幾個有趣嘅條件性效果。第一,context 管理喺視窗預算愈緊嘅時候愈有價值,大部分效益其實嚟自避免 context-overflow 失敗,而非提升行為質素。第二,在眾多策略中,「先做規則式 elision、再做 LLM 摘要」呢種分階段做法整體效率最高;允許被刪內容可恢復嘅機制,模型幾乎唔會用到,亦無帶嚟準確度提升。第三,規劃嘅角色會隨模型能力變:對弱模型係準確度嘅支柱,對強模型就變成慳成本嘅工具,準確度變化唔大。第四,預定義工具對 bash 能力弱嘅模型有幫助,但 bash 能力強嘅模型只需要 bash 介面就夠,而且喺命令行主導嘅任務上成本低好多。
軌跡分析進一步解釋:context 管理延長執行軌跡但唔大幅改變行為,規劃改變軌跡停止嘅位置,動作空間就改變程式碼被寫出嚟嘅粒度。換句話講,三個零件影響嘅其實係代理行為嘅唔同面向。對從事編程代理相關工作嘅人,呢套模組化框架提供咗一個可以繼續累積、比較新零件嘅方法,亦提示設計時要按模型能力同預算做取捨,而非盲目堆砌功能。
重點摘要:
- harness 唔應該當成單一系統去比,拆開 plan、action space、context management 三個零件先睇得清
- context 管理喺視窗愈緊愈有用,核心係防 overflow,而非提升行為質素
- 規則式 elision 配合 LLM 摘要嘅分階段策略,效率表現最好
- 規劃對弱模型係必需、對強模型只係慳錢
- bash 能力夠強嘅模型用純 bash 介面,喺 CLI 任務上可以大幅降低成本