Antigravity + OmniRoute: Get FREE Unlimited AI Access (Never Run Out of Credits Again)

想用 Claude Code、Codex 或 Cursor,又唔想被單一供應商限額綁死,OmniRoute 提供咗一條幾務實的路。它把免費模型池、備援切換同壓縮節省 token 放埋一齊。
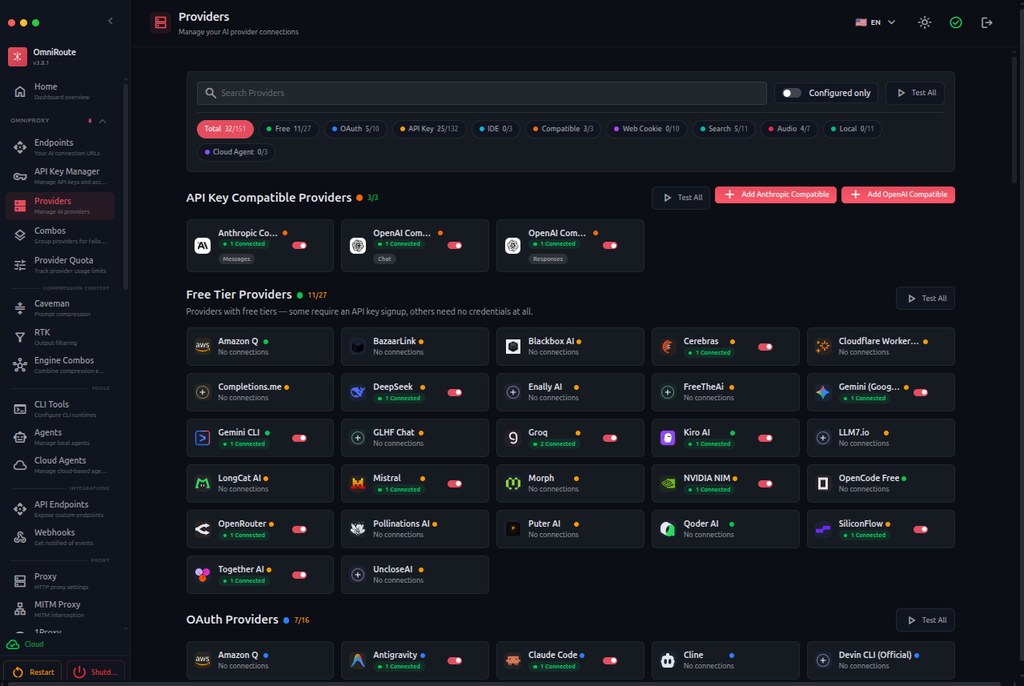
寫程式最怕做到一半先撞到配額上限,或者工具只綁死某一個模型。OmniRoute 把自己放在 AI gateway 呢個位置,直接處理多個 AI coding 工具同多個模型供應商之間的路由問題,重點唔係再造一個聊天介面,而係幫你維持請求可用、控制成本,並用 auto-fallback 減少中斷。
同類做法通常會主打單一 API 聚合,OmniRoute 的取向明顯更偏向「免費額度整合 + 路由策略 + 壓縮節流」。它聲稱可接到 237 個 providers,當中 90+ 提供 free tiers,並以 RTK + Caveman compression 把 token 消耗壓低 15% 至 95%。呢個方向的好處係對長提示、程式碼上下文同重複輸出較有幫助,但壓縮始終係取捨,所以它加咗 inflation guard,遇到壓縮後反而變長,就會送回原文。


你可以把它理解成放在 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity 後面的中介層。部署後,工具經同一個 endpoint 出請求,再由 OmniRoute 分配到 Claude、GPT、Gemini 及其他供應商;README 也提到每個模型會列出本月已用與剩餘額度,並標示 provider terms,這點對團隊控管比較有用。
幾個值得留意的重點:
– 定位屬於工具 / 閘道型軟件,解決的是多模型切換、免費額度整合同配額中斷
– 支援 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity,適合多工具並行的開發流程
– 以 documented free tokens/month 作招徠,現有資料提到穩定約 1.6B,首月可到 2.1B
– 內建 17 routing strategies,並加入 auto-fallback,減少單一 provider 失效帶來的停頓
– 壓縮模組已針對 German、French、Japanese、Chinese,以及 Gradle、.NET 輸出做過強化
受益最大的一般會係重度依賴 AI 編碼助手的個人開發者、細團隊,同想把成本壓到最低的實驗性項目。要留意的是,免費池本身受各 provider 條款影響,OmniRoute 雖然強調統計方式較透明,但效能與穩定性仍然建基於外部服務;它較像一個把資源調度做得更聰明的控制層,而唔係保證品質一致的模型平台。
想令 coding agent 越跑越準,呢個項目用聊天指令就可以反覆試錯、驗證同回滾。它不是再訓練模型,而是直接改進 skill 與 agent 流程。
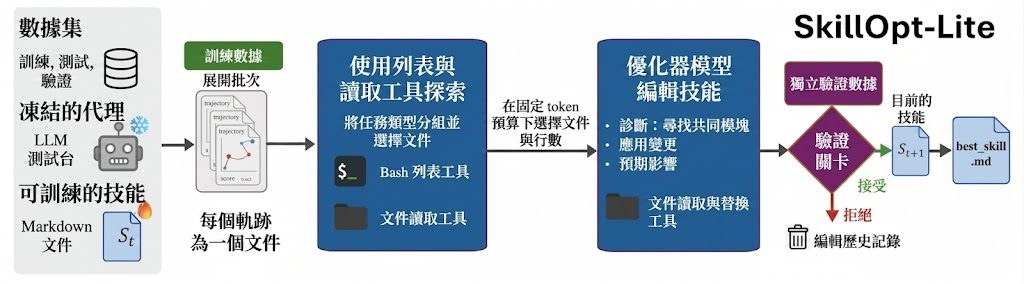
不少人用 coding agent 時,卡位不在模型本身,而在 prompt、skill 文件同執行流程點樣一路修正。SkillOpt-Lite 連同 HarnessOpt 就是針對這個位置而來的 Agentic 工具:把評測、修改、驗證同回滾包成兩個 slash command,讓 coding agent 在對話環境內自動迭代改善。
它反對一種常見範式:每次表現不好,就手動改 prompt、重跑少量樣本,再憑感覺決定有沒有進步。作者改用 looped improvements 配合 validation-gated rollback,先跑一批 scored rollouts,將失敗樣本交回 coding agent 修補,再用 val split 決定保留還是還原;焦點不是 fine-tuning,也不是增加 inference-time overhead,而是把現有 agent workflow 系統化地優化。
部署理解上,這個項目不是叫你在 shell 逐步砌環境,而是把 repo 資料夾直接開進支援 .github/prompts/*.prompt.md 的 coding agent,例如 VS Code Copilot Chat、Codex CLI、Claude Code。環境安裝、驗證、資料下載由 agent 協助處理;現成 benchmark 包括 LiveMath、SpreadsheetBench、ALFWorld、DocVQA、OfficeQA 同 SearchQA,亦支援帶入自家 repo 與資料格式。
skill.md,適合先驗證 prompt/skill 層面的改善跟同類做法相比,它的差異不在於推出新模型,而是把「由 agent 自己根據失敗紀錄修補自己」做成可重覆流程。公開內容提到在 6 個 benchmarks 有結果,亦展示過 GPT-5.4-nano 配合 HarnessOpt 可超過較高階模型配標準 harness 的情況;不過現時較依賴 coding agent 工作流,最適合做 agent 評測、提示工程、內部工具自動化的團隊,而不是單純想下載一個模型即用的人。相關模型與目標例子則包括 GPT-5.4-nano、GPT-5.5,以及各種可讀取 prompt 檔的 coding agents。
open-design 是一款本地優先的桌面應用,讓 AI 編碼代理直接生成設計稿、頁面與多媒體內容。
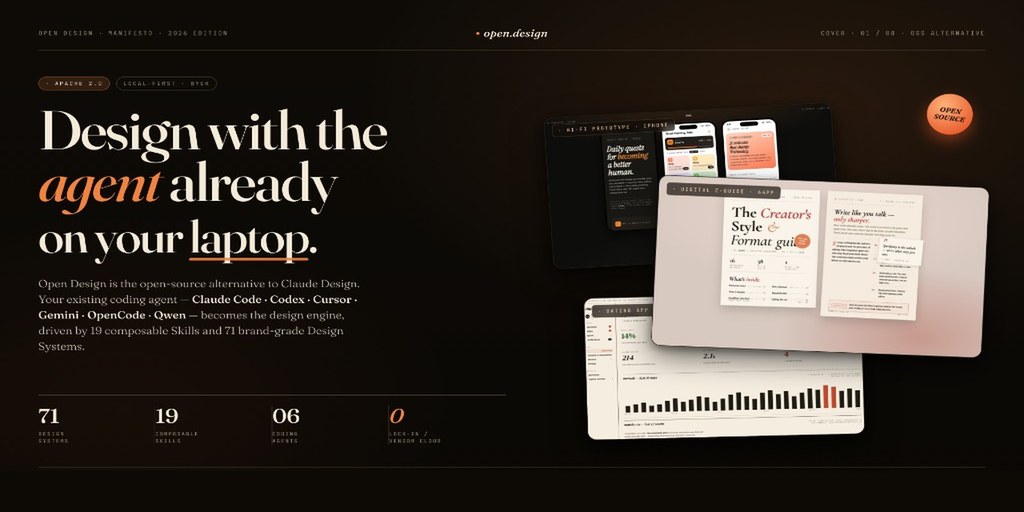
open-design 是一款本地優先(local-first)的開源桌面應用程式,主打讓 AI 編碼代理(coding agent)直接充當設計引擎,協助用戶快速產出原型設計(prototypes)、登陸頁面(landing pages)、儀表板(dashboards)、投影片、圖片甚至影片等各種多媒體素材,並輸出真實可用的檔案。這個項目的定位是 Claude Design 的開源替代方案,強調在桌面環境中本地執行,無需依賴雲端服務即可完成設計工作。
與傳統的設計工具相比,open-design 的最大差異在於將 AI 編碼代理作為核心驅動力,用戶可以透過自然語言指令讓代理直接生成設計內容,省去手動拖拽元件的繁瑣流程。從 GitHub 上的數據可見,該項目已獲得超過 7.5 萬顆星及 8 千多次 fork,社群關注度相當高,顯示開源社群對本地化 AI 設計工具的強烈需求。
這個項目最適合需要快速產出網頁原型或行銷素材的開發者、設計師及內容創作者。對於重視資料隱私、希望在本地環境完成設計工作的人來說,local-first 的架構尤為吸引。開發者亦可將其整合到現有的編碼工作流中,讓 AI 代理同時負責程式碼與設計兩個層面。
以下是這個項目的重點摘要:
由於該項目仍處於活躍開發階段,功能成熟度與跨平台支援等細節尚未完全明朗,建議有興趣的使用者持續關注其更新進度。
以下是該網頁主要內容(麻省理工學院電子工程與計算機科學系 MIT EECS 的訪談文章)的繁體中文翻譯:
(more…)這是個用世界座標模擬3D物體運動的擴散模型。它把剛體、彈性體與多物件互動放進同一個生成框架。
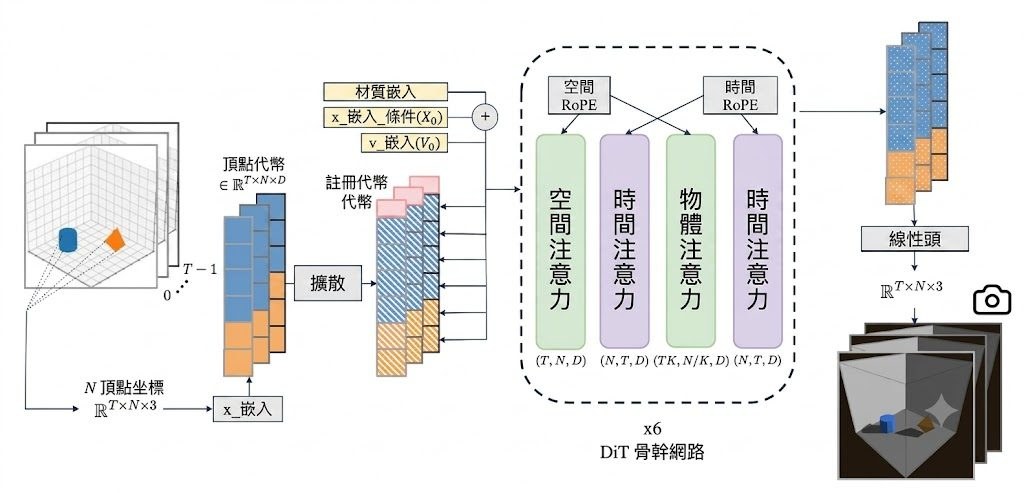
PhysiFormer 是一個 diffusion transformer 模型,用世界座標中的 3D mesh 直接模擬物體運動。它要處理的是在已知初始頂點位置、速度與材質條件下,生成之後一段時間內合理可信的 4D 動態軌跡。
它和常見 video world models 的分別,在於不是在視角相關的像素空間推測畫面變化,而是直接預測 world coordinates 裡的 vertex trajectories。論文指出,這個做法不依賴手動指定的模擬結構、shape latent,亦不需要明確加入 rigid-transform prediction 一類限制,改用單一步驟的去噪擴散過程學習完整時域軌跡。
模型同時支援 rigid 與 elastic 物件,亦能處理 mixed-material dynamics、碰撞,以及靜止與移動中的多個物件。為了提升效率,PhysiFormer 採用在時間、空間與物件三個維度分解的 attention,令多物件推理保留 permutation-invariant 特性,毋須額外手動編碼物件身份。
這類項目較適合 robotics、graphics、physical design,以及需要幾何感知 world modelling 的工作流。現有資料顯示它對未見過的真實幾何形狀、更大的物件數量,以及混合材質場景有一定泛化能力,但內容主要來自模擬資料與論文結果,真實部署表現仍要配合具體場景再驗證。
這段影片展示用 AI 工具整理敘事影片流程。重點在於把腳本、視覺與製作步驟串連起來。
現有資料主要來自 YouTube 標題與簡短描述,資訊不算完整,但仍可看出內容圍繞 HyperFrame 與 Claude Code 兩個工具,示範如何做出接近 Vox 風格的解說影片。讀者可先把它理解為一個 AI 輔助影片製作項目:由工具協助處理腳本、畫面規劃或製作流程,而不只是單一步驟生成。
這類項目想處理的問題,很可能是把資料整理、敘事結構、畫面設計與影片產出連成一條工作流。相比只用單一影片生成模型,這種做法更接近內容製作流程本身,重點不只是「出片」,而是如何把想法變成有節奏、有資訊層次的短片。
從標題判斷,Claude Code 可能負責文字、結構或流程協調,HyperFrame 則可能用於畫面或影片製作環節。不過頁面未提供更詳細技術內容、模型名稱或量化結果,因此未能確認兩者各自負責的步驟,也不能判斷成品質素是否穩定。
可先留意幾個重點:
– 這是一個偏向工作流整合的影片製作項目
– 目標風格是資訊密度較高的 Vox 式解說內容
– 適合內容創作者、營銷製作與短片腳本規劃
– 現有頁面缺少性能數據、成本與時間比較
如果想進一步測試,較可行的方法是先觀看原片,記錄它如何拆分腳本、旁白、畫面節奏與素材安排,再用同類工具重建其中一小段。以目前資料來看,這項內容較適合作為工作流觀察,而不是完整教學或技術評測。
ENPIRE 把真實機械人訓練變成可反覆優化流程,讓 coding agents 直接參與改良策略。
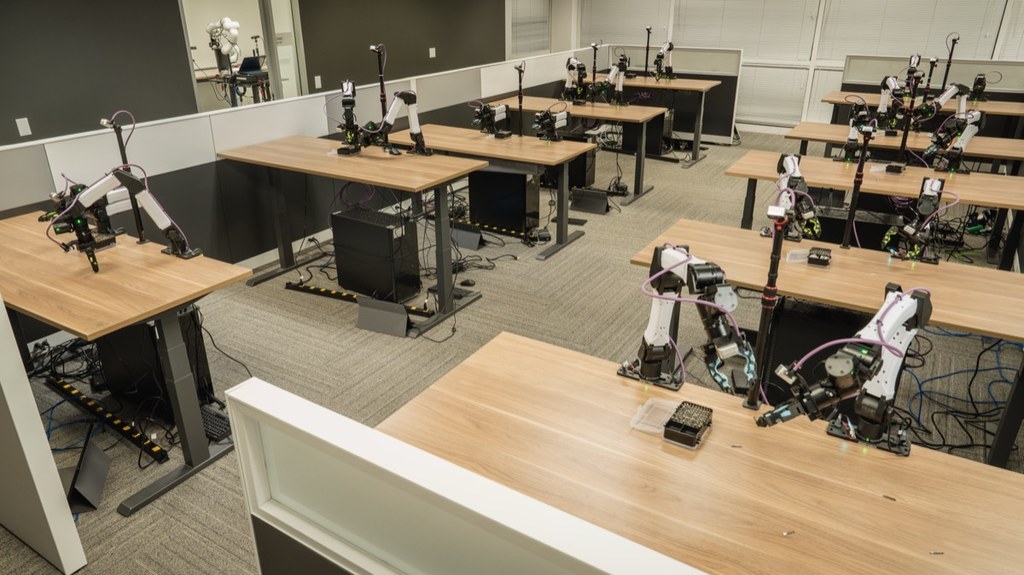
ENPIRE 是一個用於真實世界機械人策略自我改良的框架,重點不是單一模型,而是把「重設場景、執行策略、檢查結果、再改進」串成可重複閉環。它針對的問題很明確:靈巧操作任務一直很依賴人手監督與大量調參,令機械人研究難以擴展。
系統由四個模組組成:Environment(EN)負責自動重設與驗證、Policy Improvement(PI)負責發動策略改良、Rollout(R)負責在單機或多機械人上測試、Evolution(E)則讓 coding agents 分析紀錄、查閱文獻、調整訓練基建與演算法程式。與常見只在模擬器或純數碼環境做 agent 優化的方法相比,ENPIRE 把回饋迴路直接放到真實機械人上。
列出的案例包括 PushT、Pin Insertion、Tie Zip-tie 與 GPU Insertion,可見它瞄準的是需要精準操作的任務。按頁面描述,frontier coding agents 在這套流程下,可把部分真實操作任務推高至 99% 成功率,但不同任務、機械人配置與訓練設定之間仍可能有差異,閱讀時宜把它視為特定條件下的結果。
若想理解這個項目,可先從它的閉環結構入手,再看 Policy Improvement 支援哪些路線,例如 heuristic learning、tool calling、behavior cloning、offline RL 與 online RL。頁面亦提到 robot fleet scaling、simulation evaluation、auto evaluation 與 auto reset,反映這個項目不只關心模型表現,也在處理如何把測試與迭代流程自動化。
這項目較適合放在機械人學習、自主代理與真實世界實驗自動化的脈絡下理解。若你關心 Computer-use agents 或 coding agents 能否走出螢幕、直接管理物理系統的迭代流程,ENPIRE 提供了一個相當具體的方向。
一個聚焦多語言編程能力的公開評測平台,可比較不同模型在時間變化下的表現。
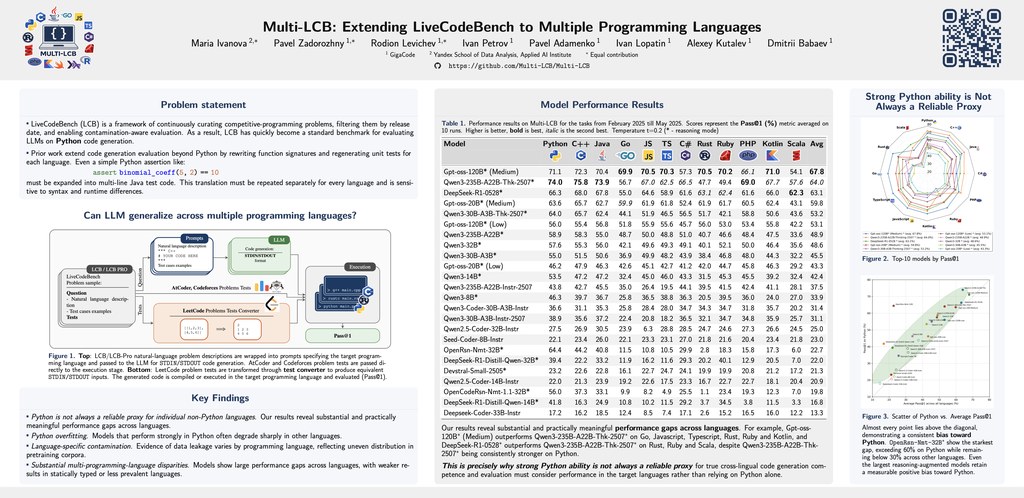
MultiLCB(Multi Live Code Bench)是一個公開的編程模型評測項目,重點是用動態榜單和比較工具,觀察不同模型在多種程式語言上的表現。網站提供 Main Leaderboard、Model Comparison,以及按月份查看 pass@1 變化,適合想快速了解模型編碼能力的人。
這個項目處理的問題很明確:不少編程模型成績只停留在單次發布,難以看出時間變化、語言差異和推理設定的影響。MultiLCB 把資料整理成可篩選的介面,支援語言、難度、平台,以及是否使用 CoT(Chain-of-Thought)等條件,方便直接比較。
使用時,讀者可先在 Leaderboard 選擇日期範圍,再按 Python、JavaScript、TypeScript、Java、C++、C#、Go、Rust、Ruby、PHP、Kotlin、Scala 等語言篩選。若想深入看兩個或多個模型差距,可打開 Compare 頁面,用 pass@1 與平均分數交叉檢視,也可留意每月走勢圖。
這類項目特別適合模型研究者、AI 工程師、技術媒體,以及需要挑選 coding model 的團隊。從頁面可見,它偏向基準測試與橫向比較工具;至於數據來源、題目構成和完整評測方法,仍要配合站內 Code、Hf、Submit 或相關說明頁面再作確認。
UniAR 針對多模態模型常見的雙 tokenizer 分裂問題,改用單一視覺 tokenizer。這個方向同時瞄準理解、生成與編輯三種影像任務。
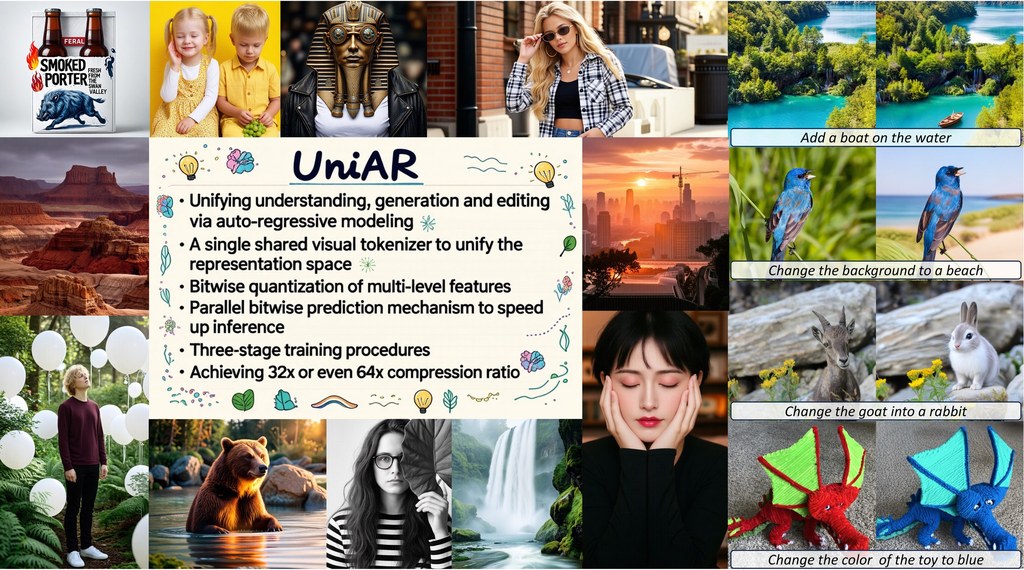
現有 Unified Multimodal Models(UMMs)多數會把影像理解和影像生成分開處理,常見做法是用兩套 visual tokenizers。作者認為這種 fixed paradigm 會把表示空間拆開,模型生成完圖片後,還要再重新編碼才能理解自己剛產生的內容,shared context 也就難以真正成立;UniAR 因此提出一個 unified autoregressive framework,用單一 discrete visual tokenizer 連接理解、生成與編輯。
項目屬於多模態模型,目標是用同一個 Transformer 解決 image understanding、image generation 和 image editing 之間來回切換的成本。它的核心判斷很直接:若模型看圖與作圖共用同一套視覺 token,流程就不需要額外 re-encoding,系統結構會更一致。
技術上,UniAR 有幾個辨識度很高的設計。Multi-level BSQ tokenizer 把高層語意與低層細節一併保留,並透過 Binary Spherical Quantization 擴大有效 vocabulary;parallel bitwise prediction 則把視覺碼以分組方式一齊預測,令 autoregressive 長序列壓短,論文提到 1024×1024 影像只需 256 個 AR tokens,對應 32x visual compression ratio。
如果你想試這個項目,較合理的切入點不是直接拿來當日常工具,而是先看它公開的模型權重與項目頁,分開測理解、生成、編輯三類輸出是否一致。它較適合研究多模態統一架構的人、關注 Qwen 生態的開發者,以及想比較 autoregressive 與 diffusion 混合路線的讀者。
性能方面,原文聲稱 UniAR 經 large-scale pre-training、supervised fine-tuning 和 reinforcement learning 後,在 image generation 與 image editing 達到 state-of-the-art,同時在多模態理解 benchmark 保持競爭力。不過目前公開資訊較像研究成果展示,visual decoder training code 仍未完整放出,因此更適合拿來理解方法論,而不是立即評估成成熟生產工具。
相關模型與組件包括 SD3-medium visual decoder、Qwen Team 背景下的多模態模型路線,以及論文聚焦的 Unified Multimodal Models(UMMs)。若你在意的不是單次生成效果,而是模型能否「理解自己生成的內容」,UniAR 的 shared context 設計確實提出了一個有意思而且相當具體的答案。
VisualClaw 不只是接駁模型的工具,還把記憶、技能與影片處理串成可持續改良的代理系統。

現時不少 vision-language agents 主要靠固定提示、整段影片送入模型,或者一次性工具調用去完成任務;作者認為這種 fixed scaffold 容易令延遲、成本同提示長度一齊上升,而且部署後幾乎唔會自己累積經驗。VisualClaw 因而提出一個 modular multimodal agent system,夾在 Claude Code、Codex、OpenClaw 同上游 LLM providers 之間,加入 retrieved memory、skill bank、self-evolution、video processing 同 evaluation hooks。
這個項目屬於框架兼工具型基建,重點唔係再訓練一個新模型,而係幫 Computer-use agents、tool-using vision-language agents 更有效處理影片、工作空間同多輪任務。配套的 VisualClawArena 則是獨立 benchmark/data release,收錄 200 個 scenario,要求代理真正在 workspace 內用影片證據、文件、動態更新與 executable checks 解題,補回一般 video-QA benchmark 對工具使用情境測試不足的缺口。
把它當成 gateway proxy,用熟悉的 OpenAI 或 Anthropic 相容介面接到現有 agent workflow,再逐步打開 skills、memory、video cascade 等模組。對已經在用 Claude Code 或 Codex 的團隊,這種接法尤其實用,因為毋須由零重寫整個代理流程。
在 4 個 video-QA benchmarks、2 個 VLMs(Gemini 3 Flash、GPT-5.2)上,VisualClaw 對 full-frame upload 的每題 API 成本平均可減 98%,相對 offline uniform 8 frame baseline 亦再降 25.9%,同時多數設定下準確率有提升。到 VisualClawArena,配合 Codex(GPT-5.5)與 Claude Code(Sonnet 4.6)等 backend,macro accuracy 分別提升 2.9% 同 3.2%;如果你關心的是可插拔代理基建、多模態工作流,或者想為 live vision 與影片任務加上可持續進化能力,這個項目比單純模型包裝器更有研究同落地價值。