WorldSonus 為影片補上可互動立體聲音

WorldSonus 將影片動態、文字指令和立體聲音同步起來,讓世界模型生成的畫面不再只有無聲場景。

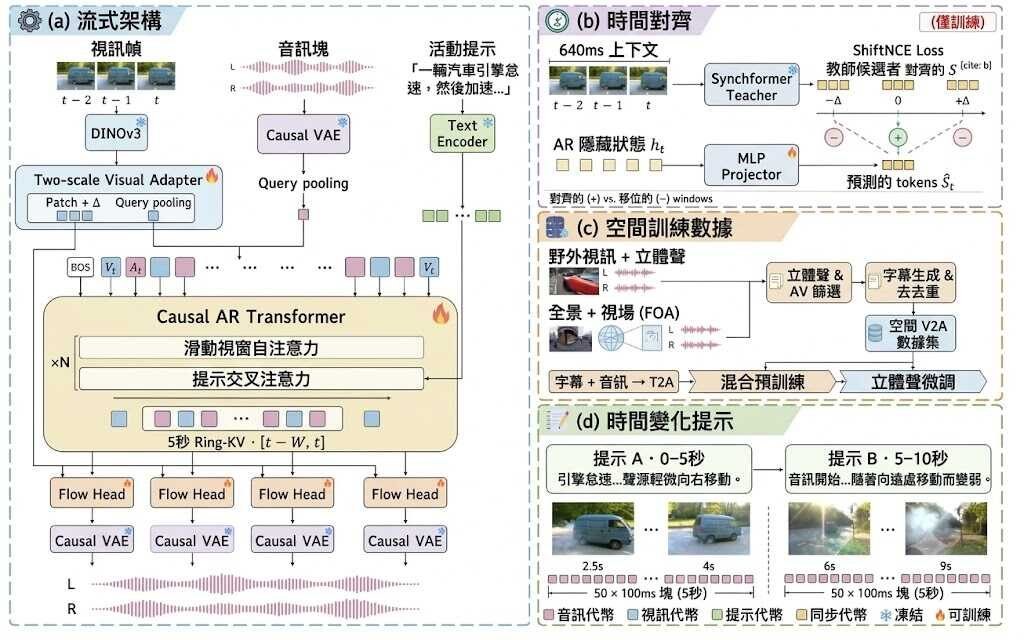
WorldSonus architecture

影片中的腳步、流水和列車聲可以隨畫面變化,甚至在生成途中接受新的文字指令。WorldSonus 是一個影片轉音訊模型,處理世界模型和互動影片缺少同步聲音的問題,並以每 100 毫秒一段的方式生成 48 kHz 立體聲。

它採用 streaming causal autoregressive diffusion 架構,讓影片畫面經過兩種時間尺度的視覺 token 後,交由 AR transformer 和 rectified-flow head 生成音訊。生成模型、audio decoder、normalization statistics,以及凍結的 DINOv3 和 T5Gemma 2 視覺/文字編碼器分工合作;文字提示可在 chunk 邊界更新,同時保留聲音連續性。

• 支援離線生成和 streaming generation,兩者使用同一條三幀生成路徑
• Visual temporal differences、Ring-KV 歷史狀態和 causal decoder convolution states 會跨 chunk 保留
• 可用影片加提示詞控制聲音,也可只用影片作條件
• 輸出為 stereo 48 kHz 音訊,片段長度會按 100 毫秒 chunk 向下取整

研究結果給出的 real-time factor (RTF) 是 0.41,並在開放領域 video-to-audio benchmark 中達到或超越部分雙向模型的聲學質素和空間對齊表現。不過參考實作沒有承諾固定延遲,模型和編碼器亦要在串流開始前載入,不能直接把 RTF 當成使用者必然取得的端到端延遲。

測試需要 Python 3.10 或以上、支援 CUDA 的 GPU、FFmpeg 和 ffprobe,GPU 驅動程式要預先安裝;設定程序會安裝 CUDA 12.4 的 PyTorch wheels。模型權重和編碼器可從 Hugging Face 下載,適合研究世界模型、影片生成、互動模擬或需要空間聲音的內容製作團隊,但硬件要求和上游模型的授權/存取條件仍需先核對。
項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, AI productions, 模型, 世界模型, NVIDIA, Gemini, Video, Audio, 提示詞, 香港, Python, Dataset 數據集

GRACE 以少八倍 Token 加速影片生成

GRACE 壓縮預訓練影片自編碼器,讓原有 DiT 用更少 latent tokens 生成影片,同時維持接近原模型的質素。

GRACE

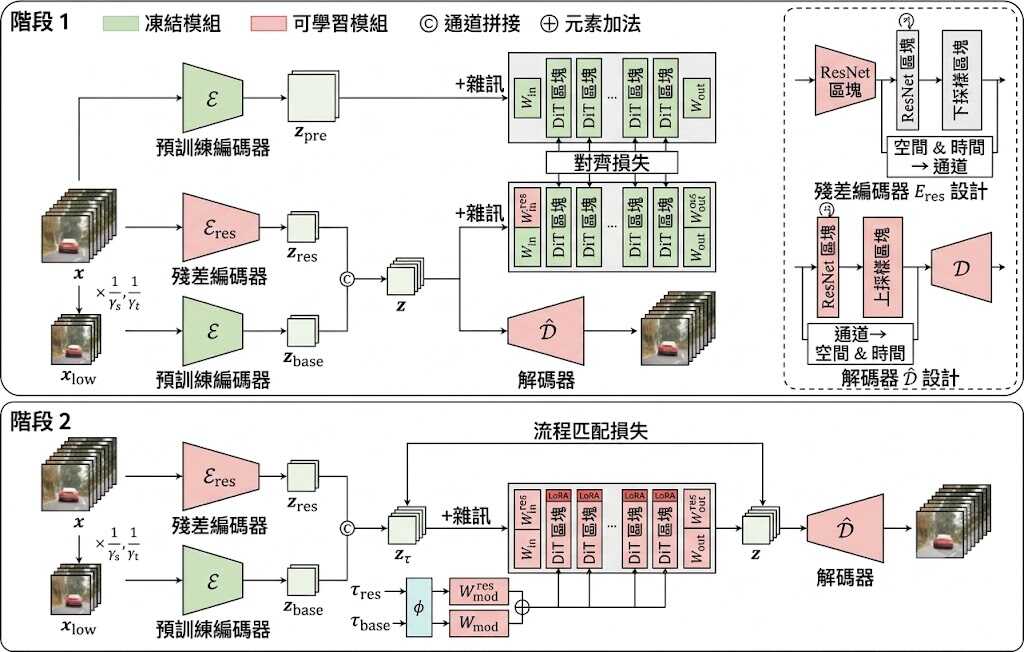
影片生成最難取捨的地方,是壓低 latent tokens 後往往連細節和生成質素一併犧牲。GRACE 以開源模型項目的形式處理這個問題:壓縮預訓練 video autoencoder,讓原本已訓練好的 DiT 在不重新訓練的情況下,從更短的 latent 表示生成影片。

它同時壓縮空間和時間軸,比例分別為 16× 和 8×。模型保留一個 frozen base latent,維持 DiT 熟悉的表示空間,再用 learned residual latent 補回高壓縮率造成的細節;訓練時更在 frozen DiT 的 feature space 對齊壓縮結果,避免只追求 reconstruction quality,卻令生成質素下降。

推理階段採用 asymmetric denoising,base 會比 residual 提前固定 δ=0.15 去噪,讓 residual 在內容穩定後補充細節。這套做法適合研究影片生成、影片模型加速,以及需要沿用既有 DiT 權重而不想從頭訓練的團隊。

  • latent tokens 減少 8×,VBench 分數接近未壓縮模型
  • 480×832×81 輸入的延遲降低 11.1×
  • 736×1280×81 輸入的延遲降低 15.5×
  • 需要按儲存庫提供的環境重現,樣本內容可一致,但不同環境不保證 byte-level 完全相同

安裝及測試時,應先依照項目提供的權重和依賴設定重現結果;提醒部分代理會阻擋指定 PyTorch wheel 來源,檢查 reproduction 時不應額外安裝 FlashAttention,因為 SDPA 已經使用 flash kernel。GRACE 的價值在於以較低推理成本延續既有 DiT 能力,但是否適合生產環境,仍要按硬件、影片尺寸和模型管線重新量度延遲與畫質。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Python, 庫

ArtCraft 以 Rust 重做七款 Adobe 創作工具

ArtCraft 把影像、影片、PDF、排版等工作整合到七款原生工具,檔案留在本機,亦方便接入自動化流程。

Og image

由影像編輯、向量繪圖到影片、PDF、動態圖像和頁面排版,ArtCraft 正以 Pure Rust 打造七款原生、開源及免費的創作應用,處理創作者需要在不同工具之間切換,以及雲端往返檔案的工作流程問題。項目涵蓋 PhotoCraft、VectorCraft、FilmCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft。

這套工具的差異不只在於功能範圍,而在於每款應用都直接編譯成 macOS、Windows 和 Linux 桌面程式,不依賴 Electron 或 web views。檔案在本機處理,介面、工具和快捷鍵則沿用專業創作軟件較熟悉的操作方式;PhotoCraft、VectorCraft、LightCraft、PdfCraft、EffectCraft 和 DesignCraft 亦可透過 WebAssembly 在瀏覽器執行。

目前 PhotoCraft 和 PdfCraft 屬於 Early alpha,其餘多數工具仍在 In development,不能視為已完成的商業級套裝。不同應用的安裝程式已涵蓋多個平台。

項目亦預留了自動化和 AI agents 的接入方式,可透過 CLI、JSON control channel 或 MCP server 操作應用,適合需要批量處理素材、建立創作流程,或希望自行檢視和修改程式碼的使用者。

  • 七款工具涵蓋影像、向量、影片、攝影、PDF、VFX 和排版
  • 以 Rust 從頭開發,採用原生桌面程式架構
  • 開源程式碼放在 GitHub,並使用 permissive licenses
  • 檔案留在本機,部分應用同時支援瀏覽器和 WebAssembly
  • 多數工具仍在早期開發階段,成熟度各有不同

項目主頁

Categories: 開源, Agentic, AI productions, MCP, 視頻模型, Video, Image, 影像模型, 教學, 軟件, 工具, Content Creator, Discord, Mac, Linux, 庫

Building Rome 單張相片重建完整 3D 場景

只用一張相片,Building Rome 便嘗試補全鏡頭外的建築與室內結構,生成可探索的 3D 場景網格。連看不見的空間也能生成。

Og image

只得一張相片,Building Rome 便嘗試補全鏡頭未拍到的空間,生成室內、戶外及大型環境的完整 3D scene mesh。這個單影像 3D 場景重建項目,處理的是照片只提供單一視角、遠近物件細節不一致,以及隱藏幾何無法直接觀察的問題。

方法把場景切成會隨距離變化的 adaptive chunks:近處使用較細區塊保留細節,遠處則用較大區塊涵蓋建築。影像特徵會投射到已觀察到的表面,而每個 voxel 亦會標示空置、可見或隱藏狀態;生成鄰近區塊時重用重疊 latent,令新加入的幾何結構較能保持連貫。

讀者可以透過互動檢視重建結果,透過拖曳旋轉、滾輪縮放及 WASD、Q、E 移動,亦可選取兩點量度距離。網頁展示用 mesh 為方便瀏覽而簡化至約 1.5M faces,論文圖像及影片則採用完整解析度,因此兩者的視覺細節不應直接視為相同。

  • 單張相片重建室內、戶外及大型場景
  • 以 adaptive chunks 處理不同距離的細節
  • 透過 2D&3D conditioning 推斷可見與隱藏幾何
  • 以 autoregressive generation 延續相鄰區塊的一致性
  • Code 標示為即將提供,現時可先透過互動網頁查看結果

項目由 Applied Intuition 聯同 Purdue University、UIUC 及 UC Berkeley 研究人員完成,並以 World Tracing、GenRecon、VolFill 及 Lyra 2.0 等方法作比較。對需要由照片建立可探索環境、進行空間分析或製作 3D 內容的人,這種由單一視角推算完整場景的做法提供了另一條工作流程,但隱藏區域屬於模型生成,不能當作相片直接觀察所得的精確測量。

項目主頁 · 項目

Categories: 開源, AI productions, 模型, 視覺模型, Video, Image, 3D, Anthropic

DistScene 從圖片生成可供導航模擬的 3D 場景

生成物件之外,DistScene 也建立周邊環境,讓圖片轉成的 3D 場景可直接匯入導航模擬器。

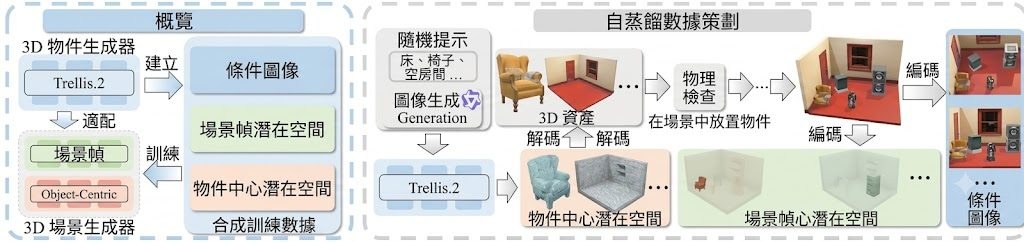
DistScene self-distilled data curation: Trellis.2 generates objects and environments, physics checks guide scene assembly, and rendering provides conditioning images.

把圖片轉成可供導航模擬的 3D 空間,需要同時建立物件與周邊環境。DistScene 這個 3D 場景生成研究項目,讓兩者在同一場景中生成,再逐件細化物件。

其 Object-to-Scene Distillation 方法以 Trellis.2 生成訓練素材:先由視覺語言模型(Vision-Language Model,VLM)描述物件與環境,再生成輸入圖片及 3D 資產,組合時加入物理檢查。

生成流程採用 Unified Scene Representation,先在共用 scene frame 內完成 sparse structure generation 與 geometry-latent generation,再把物件轉到 local voxel support,結合場景資訊細化後放回原位。

  • 同時生成環境及可分開處理的物件。
  • 場景可直接匯入導航模擬器。
  • 互動預覽經壓縮,約為原始結果的 10%。

導航模擬是已展示的用途,但程式碼、Checkpoint 及 Dataset 仍標示即將公開;目前未提供量化性能或對比結果,重現效果仍有待驗證。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 3D, Dataset 數據集

Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

Kandinsky 6.0 把同步聲畫生成帶入開源模型

Kandinsky 6.0 可由文字或圖片生成帶同步音效、口形的短片,並提供 3B 與 29B 兩款模型。

promo

由文字或圖片輸入,到畫面、音效和口形同步輸出的流程,Kandinsky 6.0 將短片生成由單純影像延伸至完整 audio-video 內容。這個項目屬於開源多模態視頻模型,實際處理的是聲音與畫面難以同步、創作者需要分開製作素材的問題。

Kandinsky 6.0 Video Lite 有 3B 參數,Kandinsky 6.0 Video Pro 則有 29B 參數,兩者都能生成 5 秒片段、44 kHz 音訊及 lip-sync,支援 text-to-audio-video(T2AV)和 image-to-audio-video(TI2AV)。額外的 super-resolution 模型可把輸出提升至 Full-HD 1920×1080,但這並不代表原生生成階段已經以 Full-HD 運作。

• 同一生成流程處理視頻、音效和口形同步
• Lite 較適合資源有限的測試,Pro 追求更高生成能力
• 支援文字生成及圖片延伸兩種模式
• 可透過 Hugging Face Space、Diffusers、ComfyUI 或 vLLM-omni 接入

測試需要 NVIDIA GPU,以及 Python 3.13 或 3.14;首次執行會下載 Kandinsky-6.0-Pro-distill-5s 權重,輸出會寫入項目指定的 MP4 路徑。對不想自行配置環境的創作者,Hugging Face Space 是較直接的試用入口;需要納入工作流的團隊則可考慮 Diffusers 或 ComfyUI。

在非精簡版顯示卡上處理 5 秒影片片段的工作時間(秒)。不包括負載載入和 MP4 編碼時間。 RTX PRO 6000 (96 GB)、A100 80 GB 和 H100 80 GB 使用模組卸載。消費級顯示卡使用區塊卸載。 RTX 4090、RTX 5060 Ti、RTX 5080、RTX 5090、RTX PRO 6000 和 A100 80 GB 使用 SageAttention2++ 進行視覺自註意力控制。 H100 使用 FlashAttention 3。

RTX 4090RTX 5060 TiRTX 5080RTX 5090RTX PRO 6000A100 80 GBH100
Lite SD4371310577309242532239
Lite HD4221328579296274472203
Lite Full HD5781774770406387664284
Pro SD93630801336754621972356
Pro HD119427161189638561791292
Pro Full HD1247353015468547651106402

Kandinsky 6.0 適合製作概念片、角色對白及需要同步聲畫的短內容,但 5 秒時長、NVIDIA GPU 依賴,以及高解像度要靠額外模型處理,仍限制了它作為長片生產工具的角色。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, 多模態模型, 視頻模型, NVIDIA, Video, Image, 影像處理, Audio, 工具, Content Creator, Python, Dataset 數據集

CANOPY 讓多模態 RAG 按證據壓縮上下文

CANOPY 會在文字、表格及影片內逐區域保留證據,減少干擾內容,同時避免剪走理解所需的上下文。

Og image

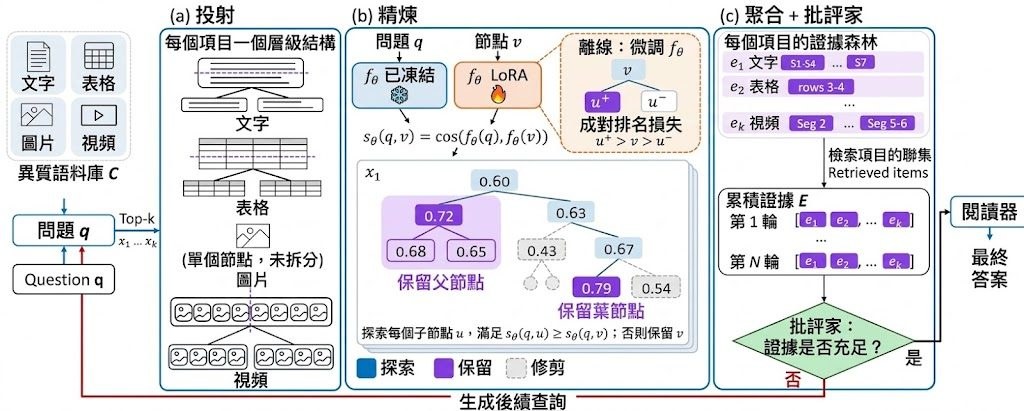
面對一段很長的文章、一張表格或一段影片,問題通常只需要其中一小部分證據,但過度保留會浪費讀者的上下文,剪得太細又可能失去理解線索。CANOPY(Canonical Projection over Hierarchy)是 POSTECH 提出的多模態 RAG 後檢索證據壓縮框架,按項目內不同區域決定保留範圍。

CANOPY 會把每個檢索項目整理成層級結構,再以經 gold evidence 微調的 node encoder,按照查詢評分不同區域。系統會比較子區域與父區域的相關程度,保留句子、表格列、關聯文字或影片片段等合適粒度,而非為整個項目套用單一截取規則。

保留的證據不足以回答問題時,critic 會要求針對性追加檢索;新找回的項目同樣先經壓縮,再加入讀者輸入,減少無關內容反覆累積。這個設計亦處理了壓縮本身無法補回「從未檢索到的證據」這項限制。

  • 在五個 QA benchmark、包含 3,300 萬個異質項目的語料庫上,平均答案準確率高於參與比較的檢索基線。
  • 消融結果顯示,多跳問答的準確率提升主要來自追加檢索。
  • 在未經路由的 Qwen3-VL-8B-Instruct 讀者設定中,證據 token 輸入量減少 14.2% 至 27.7%。
  • 壓縮後答案準確率保持相若,適合需要同時處理文字、表格及影片的 RAG 工作流。

CANOPY 的價值不在於單純縮短檢索結果,而在於讓每個項目內的保留範圍跟隨證據位置及上下文需要變化。它仍受初始檢索品質限制,但對多跳查詢和長內容閱讀,可在保留可解釋線索的同時降低 reader 的輸入負擔。

項目主頁

Categories: AI productions, RAG, 多模態模型, Qwen, Video, 框架, 庫, Dataset 數據集

Spatial Memory Intelligence:讓世界模型記住空間關係

長影片生成愈往後,舊畫面愈難整理,也容易出現空間前後不一致。SMI 以理解能力管理長期空間記憶,現時仍未公開程式碼與模型權重。

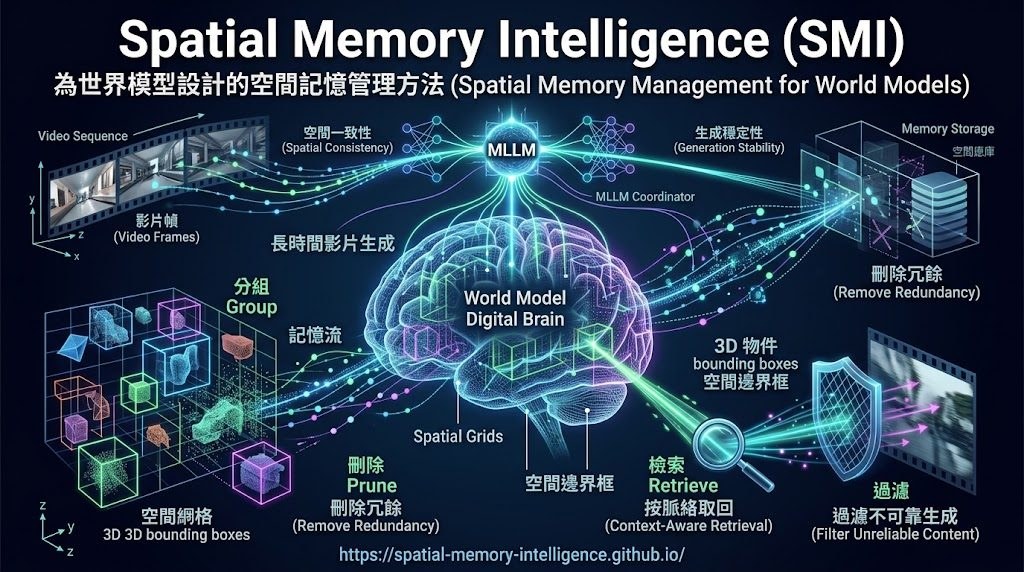
SMI overview: organizing spatial memory, retrieving relevant observations, and improving consistency and stability.

長影片生成要延續物件位置與場景結構,不能只靠不斷累積舊觀察;記憶太多會帶來冗餘,也可能把不可靠內容帶進後續生成。Spatial Memory Intelligence(SMI)是為世界模型設計的空間記憶管理方法,目標是改善記憶精簡度、空間一致性與生成穩定性。

SMI 以具語義與空間理解能力的多模態大型語言模型(MLLM)協調四項操作:把相關觀察分組、刪除群組內冗餘內容、按近期脈絡及下一步動作取回記憶,並過濾不可靠的生成觀察。它不只整理記憶,也會在生成過程中更新及提取資料,適合研究長時間影片生成與世界模型記憶管理的團隊。

項目網站提供 HY1.5 與 Wan2.2 的同步影片比較,主要對照 SMI 與 Base;部分案例亦列出 FramePack、Deep Forcing、MoC、VMem 及 MemFlow。紅框標示部分空間或結構不一致之處,方便檢視案例,但目前沒有公開可供核對的量化指標,不能單靠示範影片判斷改善幅度。

  • 記憶管理涵蓋分組、精簡、檢索與可靠性過濾。
  • 檢索會考慮近期上下文及下一個使用者動作。
  • 網站可觀看 HY1.5、Wan2.2 的影片比較。
  • 訓練、推理及評估程式碼、資料集與模型權重仍在準備發布。

目前 GitHub 儲存庫主要提供項目介紹與示意圖,尚未能據此安裝或自行重現結果。研究人員可以先查看網站示範及論文,待程式碼、資料集和權重公開後,再測試它能否在不同世界模型與長片段生成任務中維持空間一致性。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 南京大學, 阿里巴巴, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, 庫, Dataset 數據集

Page 12 of 55
1 … 10 11 12 13 14 … 55