Intro to RAG for AI (Retrieval Augmented Generation)

在 2017 年之前,序列建模長期被 RNN、LSTM 與 GRU 的遞迴時序鏈牢牢統治,但其循序計算本質帶來了無法並行的訓練天花板與長距離記憶衰減難題。Google 團隊在論文《Attention Is All You Need》中大膽提出了「完全捨棄循環與卷積結構,僅依靠注意力機制連結全局」的全新架構——Transformer。本篇教學為您拆解自注意力、多頭投影、位置編碼與 KV Cache 等核心奧秘。
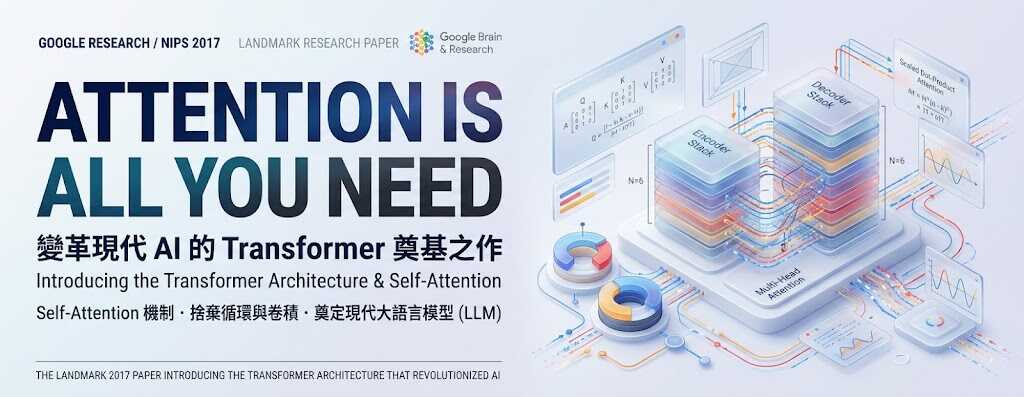
經典論文精讀 · Vaswani et al. (NeurIPS 2017) · 繁體中文深度精校 · 閱讀時間約 18 分鐘
在 2017 年之前,幾乎所有頂尖的自然語言處理(NLP)模型都是圍繞著循環神經網絡(RNN)構建。RNN 的核心設計是「按時間步長循序遞歸」:處理當前第 t 個詞時,必須仰賴前一個時間步的隱藏狀態 h_{t-1}。這種遞迴結構存在三大致命缺陷:
O(n),無法發揮現代 GPU 矩陣算力。正如論文標題所宣示的:「Attention Is All You Need」——捨棄循環與卷積,僅靠注意力機制實現一步到位全局直連!
原始 Transformer 由左側 6 層編碼器(Encoder Stack)與右側 6 層解碼器(Decoder Stack)協同組成。點擊下方互動方塊,即時查看各層張量形狀與數學運算:
自注意力機制公式:Attention(Q, K, V) = softmax( (Q · K^T) / √d_k ) · V
公式:MultiHead(Q, K, V) = Concat(head_1, ..., head_h) · W^O
在標準 Transformer 中,將總維度 d_model = 512 均分給 h = 8 個注意力頭,每個頭的維度為 d_k = 64。8 個頭各自在 64 維子空間獨立運算,計算量與單頭完全一致,卻獲得了 8 倍的特徵表徵多樣性!
公式:PE(pos, 2i) = sin(pos / 10000^{2i/d}),PE(pos, 2i+1) = cos(pos / 10000^{2i/d})
根據三角和角公式 sin(ω(pos+k)) = sin(ω·pos)cos(ω·k) + cos(ω·pos)sin(ω·k),相對位移 k 可由 2×2 線性旋轉矩陣推導,使網絡輕鬆掌握詞語相對距離!
公式:FFN(x) = max(0, xW_1 + b_1)W_2 + b_2。隱藏層先將維度放大 4 倍至 2048,經激活函數後降回 512。FFN 扮演大模型的事實記憶庫,第一層激發概念模式,第二層調用相關事實知識。
-1e9,強制未來權重為 0,防止自回歸生成時偷看答案。import math
import torch
import torch.nn as nn
class ScaledDotProductAttention(nn.Module):
def __init__(self, temperature: float = 1.0):
super().__init__()
self.temperature = temperature
self.softmax = nn.Softmax(dim=-1)
def forward(self, q, k, v, mask=None):
d_k = q.size(-1)
scores = torch.matmul(q, k.transpose(-2, -1)) / (math.sqrt(d_k) * self.temperature)
if mask is not None:
scores = scores.masked_fill(mask == 0, -1e9)
attn_weights = self.softmax(scores)
return torch.matmul(attn_weights, v), attn_weights
class MultiHeadAttention(nn.Module):
def __init__(self, d_model: int = 512, n_heads: int = 8):
super().__init__()
self.d_model = d_model
self.n_heads = n_heads
self.d_k = d_model // n_heads
self.w_q = nn.Linear(d_model, d_model, bias=False)
self.w_k = nn.Linear(d_model, d_model, bias=False)
self.w_v = nn.Linear(d_model, d_model, bias=False)
self.attention = ScaledDotProductAttention()
self.w_out = nn.Linear(d_model, d_model, bias=False)
def forward(self, q, k, v, mask=None):
B = q.size(0)
q_h = self.w_q(q).view(B, -1, self.n_heads, self.d_k).transpose(1, 2)
k_h = self.w_k(k).view(B, -1, self.n_heads, self.d_k).transpose(1, 2)
v_h = self.w_v(v).view(B, -1, self.n_heads, self.d_k).transpose(1, 2)
out, weights = self.attention(q_h, k_h, v_h, mask=mask)
concat = out.transpose(1, 2).contiguous().view(B, -1, self.d_model)
return self.w_out(concat), weightsQ: 為何推論時需要 KV Cache?
避免重複計算歷史 Key/Value,將每步生成複雜度從 O(n^2) 降為 O(n)。
Q: 什麼是 FlashAttention?
利用 GPU SRAM/HBM 分塊 Tiling 計算,不把巨大矩陣寫回顯存,大幅降低長文本記憶體開銷。