Agent Skill 的安全盲點:當三套掃描器互相矛盾時

研究團隊發佈逾六萬筆 AI 代理技能的安全掃描數據,發現不同掃描器極少達成共識,揭示單一掃描器難以判斷技能是否安全。

隨着 AI 代理(AI agents)愈來愈普及,一種稱為「代理技能」(agent skills)的新興軟件層亦隨之興起。技能可以包含指令、工具調用模式、可執行腳本等內容,屬於代理與外部工具之間的執行層,與傳統軟件包有明顯差異。技能即使不含惡意程式碼,仍可能因為授予過大權限、隱藏遠端控制路徑或不安全地儲存憑證而構成風險。

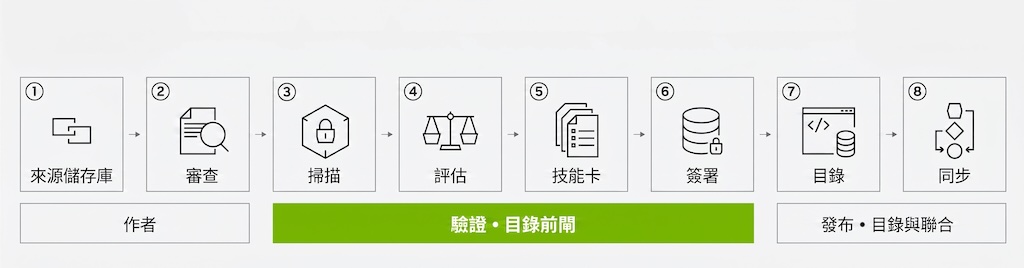
OpenClaw 基金會聯同 NVIDIA 發佈了名為 ClawHub Security Signals 的數據集,收錄了 67,453 個最新版本的公開 OpenClaw 技能。每筆紀錄包含已遮罩的 SKILL.md 內容、清理後的附帶檔案,以及三套掃描器的結果:VirusTotal、靜態啟發式分析,以及 NVIDIA 自行開發的 SkillSpector。研究團隊並非要估算惡意技能的普及率,而是聚焦於「掃描器之間的分歧」這個現象。

研究結果令人意外:三套掃描器極少對同一批技能發出警示。任何兩個掃描器的重疊率最高只有 10.4%,三者同時標記的技能僅佔 0.69%,而被單一掃描器標記的技能卻高達 81.9%。這種分歧並非隨機,而是呈現出明確的結構。SkillSpector 專門針對語意層面的代理風險,在 25,504 個可疑項目中有 75.3% 觸發警示,但在確認惡意的 206 個項目中只標記了 6.8%。相反地,在確認惡意的項目中,VirusTotal 標記了 72.8%,與附帶程式碼的惡意軟件證據吻合。

這項研究強調,AI 代理技能的安全審查需要多層次治理(layered governance),不能依賴單一掃描器作出封鎖或放行的決定。

以下是這項工作的重點摘要:

  • 規模龐大的安全數據集:收錄逾六萬個 OpenClaw 技能的最新版本,涵蓋三套不同掃描器的結果。
  • 聚焦於掃描器分歧:研究發現不同掃描器對同一批技能的判斷差異極大,重疊率偏低。
  • 不同掃描器各有所長:SkillSpector 擅長識別語意層面的代理風險,VirusTotal 則對附帶惡意程式碼的技能更敏感。
  • 支持分層治理理念:研究主張技能安全需要多層次、多工具的綜合判斷,而非單一指標。
  • 公開版本供社群使用:數據集以「銀標準」形式發佈,標籤來自自動判定而非人工標註,研究團隊歡迎社群在此基礎上開發更專門的技能安全分類模型。

這個項目最適合關注 AI 代理安全、軟件供應鏈防護及自動化安全掃描的研究人員與工程師。數據集已在 Hugging Face 上公開,研究團隊鼓勵社群進一步開發針對技能安全分類的模型。
Paper: https://arxiv.org/pdf/2606.01494

Categories: NVIDIA, OpenClaw, Dataset 數據集

TaskMem:教多模態智能體學會選擇性記憶

ByteDance Seed 與復旦大學提出 TaskMem,以強化學習訓練智能體的記憶策略,在三個串流基準上明顯提升多模態問答表現。

Og image

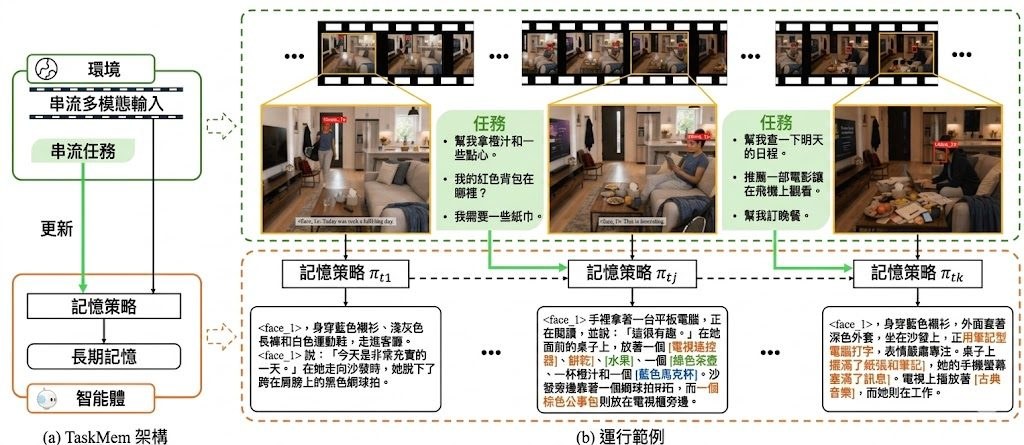
多模態智能體在持續觀察環境時,會接收海量且不斷累積的視覺與語言資訊。若把所有內容都存進長期記憶,既不實際也容易雜訊過多。Task-Focused Memorization for Multimodal Agents 這份研究,把焦點放在一個根本問題:智能體到底應該記住什麼?

來自 ByteDance Seed 與復旦大學的作者群提出名為 TaskMem(Task-focused Memorization Policy Learning) 的框架,把記憶生成視為一項可學習的策略。系統採用兩階段訓練:第一階段先學習怎樣記得準確,第二階段則在部署後,根據近期遇到的任務調整一個 adapter,使基礎多模態大型語言模型(MLLM)偏向記錄與任務相關的內容。整個過程以強化學習驅動,獎勵訊號來自真實任務的表現。

為了評估記憶品質,研究團隊將 VideoMME、EgoLife 與 EgoTempo 改造成串流基準,模擬智能體邊觀察邊回答的場景,且回答時只能依賴記憶,不能翻看原始影片。基於 Qwen3-VL-30B-A3B,TaskMem 在三個基準的 VQA 準確率分別提升 6.3%、7.0% 與 5.3%,並在多項指標上超越 Gemini-2.5-Pro、GPT-5.2 等大型模型。

這項工作對從事多模態智能體、機器人記錄系統或長期對話助手開發的研究者特別有參考價值,因為它把「該記什麼」變成可優化的決策,而非寫死規則。對於關注世界模型與持續學習(continual learning)的團隊,TaskMem 亦提供了一個結合任務回饋與記憶策略的可行路徑。

重點摘要:

  • 核心問題:多模態智能體面對資訊洪流,需要學會選擇性記憶。
  • 方法:以強化學習訓練記憶策略,分為基礎保真度與任務相關性兩階段。
  • 評估方式:將三個影片基準改造成串流設定,僅以記憶回答問題。
  • 成效:在 VideoMME、EgoLife、EgoTempo 上 VQA 準確率提升 5.3% 至 7.0%。
  • 適用對象:研究多模態智能體、機器人記憶與持續學習的開發者與學者。

項目: https://taskmem.github.io/

Categories: 開源, 字節跳動, Agentic, 框架, OpenClaw

GUI 智能體總是自己犯錯?RoTS 用樹狀軌跡合成教它如何自救

阿里雲發布的 RoTS 項目,為 GUI 智能體補上「犯錯後恢復」的能力短板,並在 OSWorld 基準上刷新開源模型表現。

Repository image for AlibabaResearch/RoTS

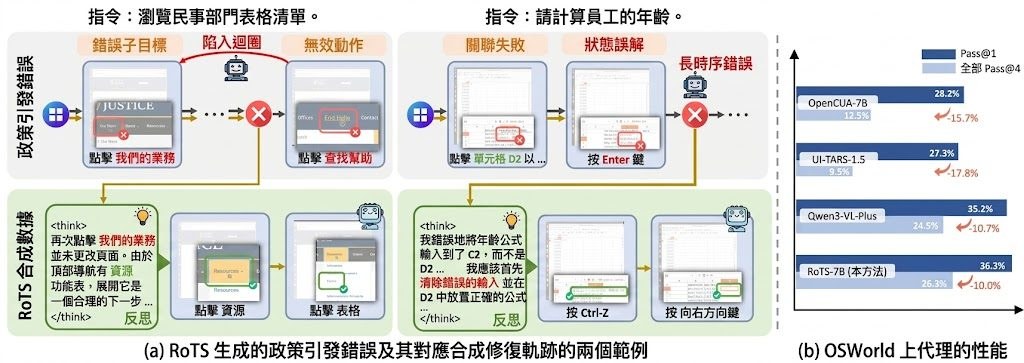
近年 GUI agents(圖形介面智能體)雖然進步神速,但只要自己點錯一個按鈕、誤判畫面狀態,往往就會卡住無法完成任務。這項由阿里雲團隊撰寫、入選 ICML 2026 Spotlight 的工作,正是針對這個「自己造成的錯誤」痛點,從評估與訓練數據兩端同時入手。

他們先推出了 GUI-RobustEval 基準,收錄 1,216 個可執行測試案例,涵蓋 11 種錯誤類型與 4 種錯誤深度,讓開發者能系統化量測智能體的「自救」能力。接著提出 RoTS 框架,以樹狀結構(tree-based)在線生成 80 萬條訓練軌跡,主動探索不同錯誤模式並合成對應的恢復步驟。

基於這批數據微調而成的 RoTS-7B 與 RoTS-32B,在 OSWorld 上於開源權重模型中取得領先表現,其中 RoTS-32B 達到 47.4% 成功率與 33.8% All-Pass@4 分數。研究團隊指出,這些分數顯示長時程錯誤恢復能力,同時提升了整體任務表現。

對從事電腦使用代理(Computer-use agents, CUAs)研究、開源 VLM 微調,或關注 GUI 自動化在真實環境穩定性的團隊而言,這是一份值得追蹤的成果。論文與數據集已公開,但程式碼與評估工具仍在整理中,有興趣的人可先閱讀論文並關注後續釋出。

重點摘要:

  • 解決 GUI agents 因自身策略錯誤而無法恢復的部署瓶頸
  • GUI-RobustEval 提供 1,216 個測試案例,覆蓋 11 種錯誤類型
  • RoTS 以樹狀在線合成框架產出 80 萬條高品質訓練軌跡
  • RoTS-7B 與 RoTS-32B 於 OSWorld 開源模型中表現領先
  • 程式碼與數據集仍在整理階段,論文已於 arXiv 公開

GitHub: https://github.com/AlibabaResearch/RoTS

Paper: https://arxiv.org/pdf/2605.29447

Categories: 開源, Agentic, 框架, OpenClaw

AutoResearchClaw:由想法走向論文的 AI 流程

項目把研究流程自動化,從一句想法延伸到實驗與論文草稿。重點不只快,還加入多代理協作與人類參與。

AutoResearchClaw Logo

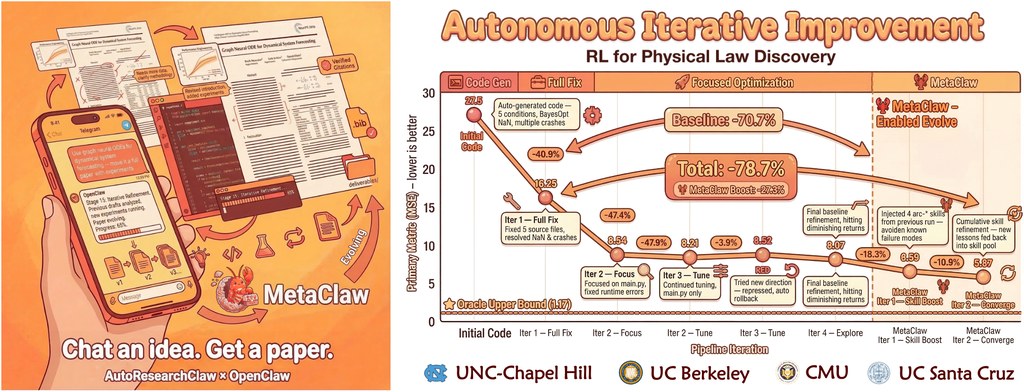
AutoResearchClaw 是一個面向研究工作的 AI 項目,目標不是單純幫你寫字,而是把「提出題目、討論假設、安排實驗、整理結果、輸出論文」串成一條連續流程。由描述可見,它特別針對傳統線性流程的限制,嘗試讓系統在失敗後仍可調整方向,而不是一步出錯就停住。

動手理解這個項目,最自然的方法是把它當成一位研究助理:先輸入一個研究主題,再讓系統展開分析、規劃與生成。它亦支援與 OpenClaw 配合,而人類介入功能預設為關閉,代表你可以先用原本流程體驗,再按需要加入審批或協作節點,不會一下子改變整套使用習慣。

這個項目較有意思的地方,在於它不只靠單一模型一次過完成工作。根據論文介紹,它結合多代理辯論、失敗後修正的執行機制、可驗證的結果彙報,以及跨次任務累積經驗的設計,方向上比一般「輸入提示詞、輸出文章」的工具更接近真正研究循環。

  • 以一句研究想法作為起點,嘗試延伸成完整研究流程
  • 強調多代理協作,而非單一路徑生成內容
  • 支援人類參與模式,但預設不影響原有流程
  • 可選整合 MetaClaw,核心流程毋須新增依賴
  • 已通過 2,699 項測試,顯示整合新功能後穩定性未見明顯倒退

適合的場景包括學術探索、研究提案發想、實驗規劃初稿,以及想觀察 AI 如何拆解研究問題的人。相關比較對象可留意 AI Scientist v2,論文亦直接以 ARC-Bench 作基準比較;若你關心的是代理式研究系統,而不只是聊天機械人,這個項目值得放入觀察名單。不過它產出的內容仍應由研究者覆核,尤其在方法設計、引用與結論判斷上更需要人手把關。

GitHub: https://github.com/aiming-lab/AutoResearchClaw

Paper: https://arxiv.org/pdf/2605.20025

Categories: 開源, Agentic, OpenClaw

openclaw 最新版本重點速覽

openclaw 2026.5.12 版本主要聚焦安裝精簡與外掛拆分。對想減少依賴、按需要擴充功能的團隊特別實用。

Og image

今次 openclaw 2026.5.12 發佈內容,重點放在模組拆分同安裝體驗優化。根據版本說明,Amazon Bedrock 以及 Bedrock Mantle 相關 provider 套件已由核心程式分離,代表一般核心安裝唔再自動拉入 AWS SDK 依賴,只有真正需要這些 provider 時先另外安裝。

實際使用上,呢個改動對開發者同部署人員最直接。若你只用核心功能,可以保留較精簡環境;如果要接入 Amazon Bedrock,先再安裝對應 provider 套件,令依賴管理更清楚,亦較容易控制映像大小、安裝時間同維護成本。

呢個專案今次最明顯的創新,不是新增大量表面功能,而是把供應商整合能力改成按需載入思路。對插件系統來說,這類 externalize 做法通常有助減少不必要耦合,讓核心與外掛邊界更清晰,對長遠擴充同版本管理較有利。

受惠工作主要包括雲端整合、平台維運、DevOps、企業內部工具開發,以及需要多環境部署的團隊。尤其當不同專案未必都用 AWS 服務時,拆分 provider 可避免每個安裝都承受相同依賴負擔。

  • 核心安裝不再預設包含 AWS SDK 依賴
  • Amazon Bedrock 與相關 provider 改為獨立安裝
  • 更適合按需要啟用外掛與雲端整合
  • 有助簡化部署、維護與套件管理

性能與評估方面,頁面可見資訊未提供具體跑分、延遲或資源使用數據,因此較穩妥的結論是:這次更新較偏向架構與依賴優化,預期可改善安裝體積與管理效率,但實際效能提升幅度仍要視部署方式同使用的 provider 組合而定。

網址: https://github.com/openclaw/openclaw/releases/tag/v2026.5.12

Categories: 開源, Agentic, OpenClaw

paperclip:用任務管理思維駕馭 AI 團隊

Paperclip 不是聊天工具,而是管理多代理協作的控制台。它把目標、預算與審核流程放進同一個工作介面。

Paperclip — runs your business

當團隊開始同時使用多個 AI 代理時,真正的瓶頸通常不是模型能力,而是協作失序。Paperclip 的定位很清楚:它不是再做一個代理本身,而是提供一個以 Node.js 伺服器與 React 介面組成的控制平面,讓使用者把不同來源的代理集中管理,並用公司、專案、目標與任務的層級來分派工作。若以一句話概括,它更像是「替 AI 團隊設計的營運系統」,而不是單純的自動化腳本集合。

實際使用上,這個專案適合已經有多個代理在運作的人,例如同時讓 Claude Code、Codex、Cursor 類型工具或 HTTP/CLI 代理各自負責開發、支援、行銷或例行工作。使用流程不是盯著一堆終端機,而是先定義公司目標與專案脈絡,再建立角色、指派任務、設定預算與批准機制,最後透過儀表板追蹤進度、成本與稽核紀錄。對想要讓代理 24 小時運作,但又不希望完全失控的團隊而言,這種「可放手、也可介入」的操作模式很實際。

Paperclip 最有意思的創新,在於它把企業治理概念直接帶進代理協作。README 提到的心跳排程、任務鎖定、持久狀態、預算硬限制、審批與回滾、以及多公司資料隔離,顯示它處理的是多代理系統中最麻煩的邊角問題,而不是只包一層漂亮 UI。尤其「每個任務都能追溯到上層目標」這件事,很適合避免代理只看見局部指令、卻看不見整體方向的常見缺陷;加上對話、工具呼叫與決策都有可追蹤紀錄,也讓後續檢討與合規更有依據。

  • 可整合多種代理執行環境,重點在協調而非綁定單一工具
  • 以組織圖、任務單、排程與預算管理多代理長時間運作
  • 提供完整稽核軌跡,方便人工覆核、追責與成本回顧
  • 支援單一部署管理多家公司,資料隔離是設計核心之一
  • 適合代理數量已經很多、需要正式管理流程的進階使用者

若從應用場景來看,Paperclip 最適合三類需求。第一是小型自動化公司或個人創業者,希望把開發、內容、客服與營運工作交給不同代理分工;第二是 AI 原生團隊,需要把多個代理當成部門成員來協調,而不是各自獨立跑任務;第三是想做內部實驗平台的技術團隊,想測試代理編制、預算政策與治理流程的實際效果。相對地,如果你只有單一代理、任務量也不大,這套系統可能顯得過重,因為它的價值建立在「代理很多、工作持續、成本要控、流程要查」的前提上。

整體來看,Paperclip 評價不在於它幫你生出更強的模型,而在於它把代理工作從零散的個人工具,提升成可管理的組織流程。這種產品思路相當少見,也切中多代理實務的痛點:工作不重複、上下文不遺失、費用不暴衝、責任可追蹤。若你目前已經感受到多代理協作帶來的管理負擔,這個專案值得深入研究;但若仍停留在單一聊天視窗的使用階段,可能還不需要這麼完整的控制層。

Source: https://github.com/paperclipai/paperclip

Categories: 開源, Agentic, , OpenClaw

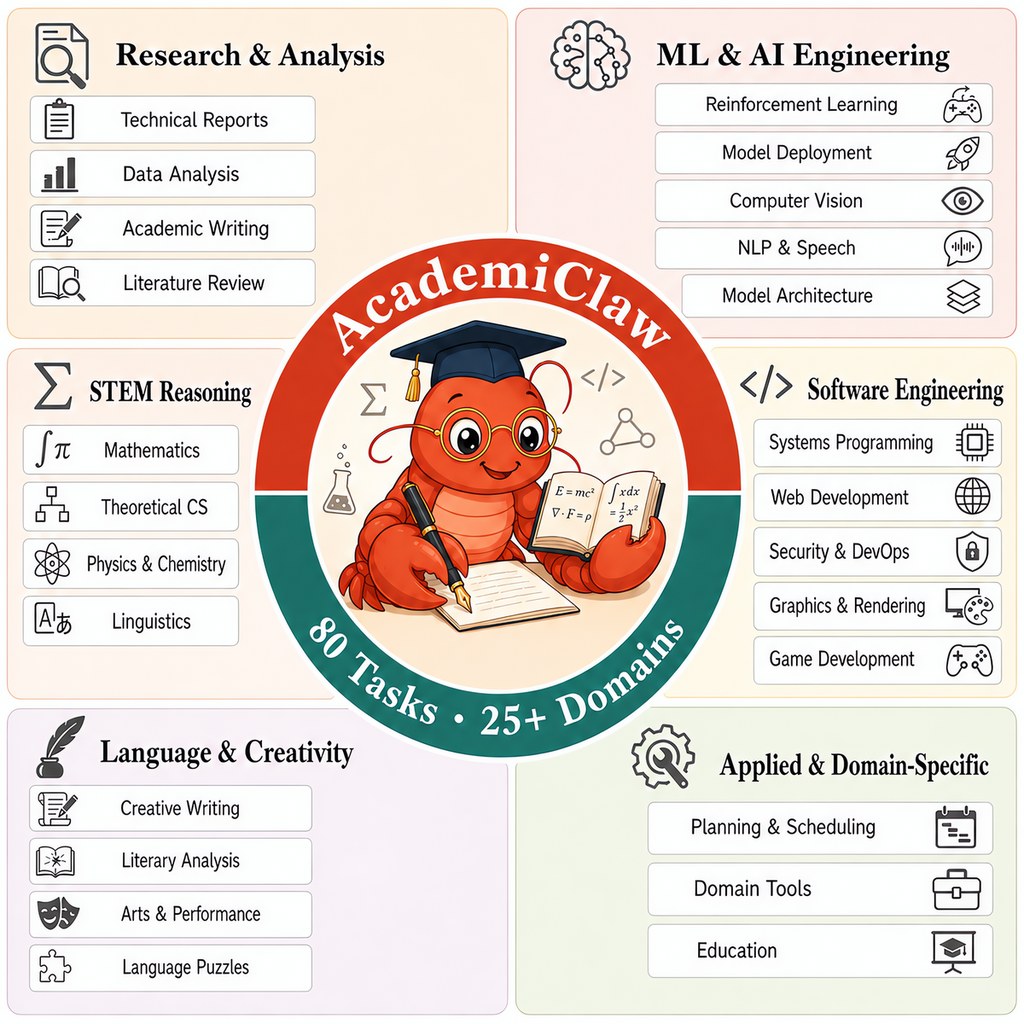
AcademiClaw 包含80個大學生的學術任務雙語基準測試

OpenClaw在真實學生任務上測試AI。

OpenClaw學術評估流程
GAIR-NLP/AcademiClaw

AcademiClaw 包含80個大學生的學術任務雙語基準測試 為AI代理呈現了一項獨特的學術 挑戰,透過使用真實世界的學術任務。這80個任務直接來自學生,突顯了當前AI不足之處。

該基準測試涵蓋了各種類別,如研究、軟體工程和語言創意,確保了全面的測試。研究人員和開發者可以專注於這些類別,以識別AI的優勢和弱點。每個任務都經過精心設計,並進行多維度評估,增強其可靠性。

在實際應用中,AcademiClaw 使用CPU和GPU任務的混合,根據需求自動路由。這種設置確保了在測試不同AI模型時的可重現性和公平性。用戶從詳細的評分維度和安全審核中受益,提供了對模型性能的洞察。

教育工作者和AI研究人員將發現 AcademiClaw 對於提升AI能力極具價值。它需要能夠處理複雜、長時間範圍任務的強大LLMs。

主要收穫:
–  AcademiClaw 使用真實的學生挑戰來測試AI。
– 它涵蓋了多樣化的學術領域,並進行詳細評估。
– 需要堅固的LLMs才能有效完成任務。
– 為AI開發和教育提供寶貴的見解。
– 支援CPU和GPU任務,以實現靈活的測試。

Source: https://github.com/GAIR-NLP/AcademiClaw

Categories: 開源, Agentic, OpenClaw

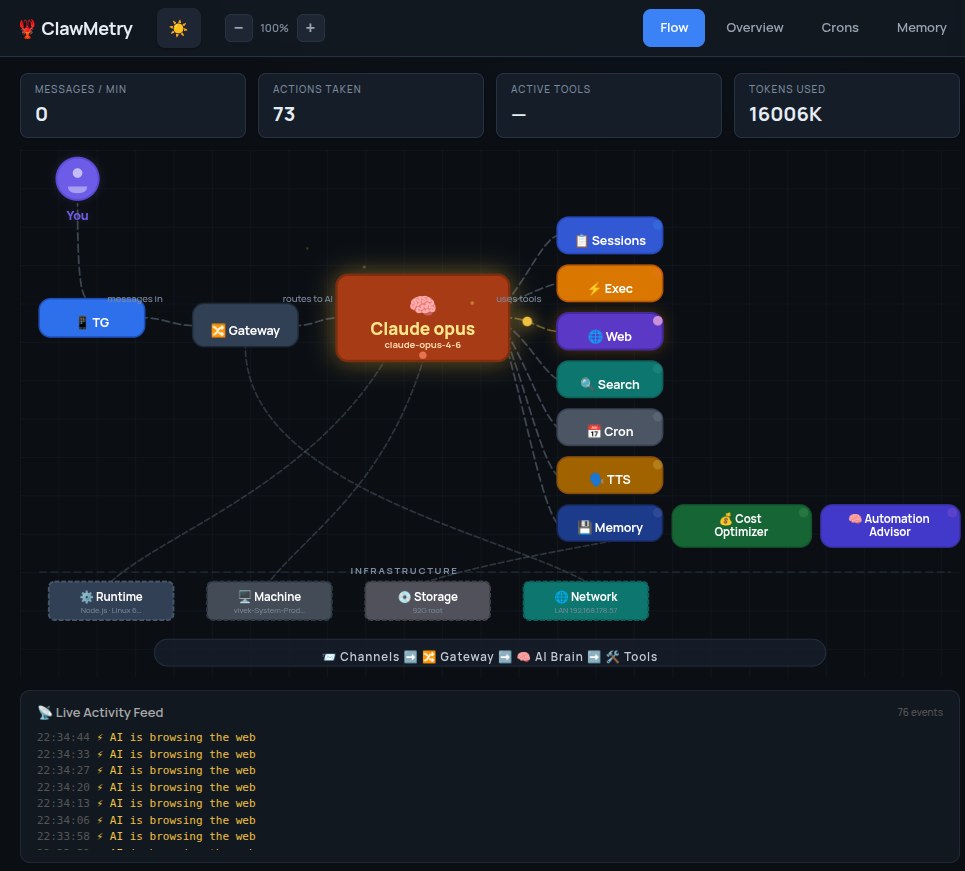
ClawMetry:看見您的代理思考

ClawMetry 可視化 AI 代理流程。零配置設置。

流程可視化

實時動畫流程儀表板是一個突出的功能,展示了通道、大腦、工具等之間的消息交換。這種可視化幫助開發者一目瞭然地理解複雜的交互。

Clawmetry 是一個專為 OpenClaw 設計的開源即時監控儀表板,它會自動讀取 OpenClaw 的現有 openclaw.json 配置文件和 Session 日誌,顯示 Agent 活動、工具呼叫、Token 消耗等資訊 。
它是獨立運行的 Python 服務,使用 pip install clawmetry 安裝後啟動,就能透過 Web 介面(預設 http://localhost:8900)查看資料,無需任何額外配置 。
Clawmetry 只讀取資料,不會寫入或改變 OpenClaw 的任何設定檔案,對 OpenClaw 性能影響極小(獨立進程,額外記憶體約 30MB)。

安裝與使用

安裝後,它會掃描你已配置的 OpenClaw 頻道,只顯示實際在 openclaw.json 中設定的項目 。
若要自訂,可用 clawmetry --port 9000 --workspace /path/to/openclaw/workspace 指定路徑,但仍僅讀取不修改 。
適合你作為 AI/ML 工程師,用來監控 RAG 系統或 Cantonese NLP Agent 的運行狀態 。

主要功能:
* 自動偵測 AI 代理配置
* 提供實時流程圖以提高清晰度
* 高效追蹤令牌使用和成本
* 支援多種大型語言模型

Source: https://github.com/vivekchand/clawmetry

Categories: 開源, OpenClaw

ClawGym 構建高效的 Claw 代理框架

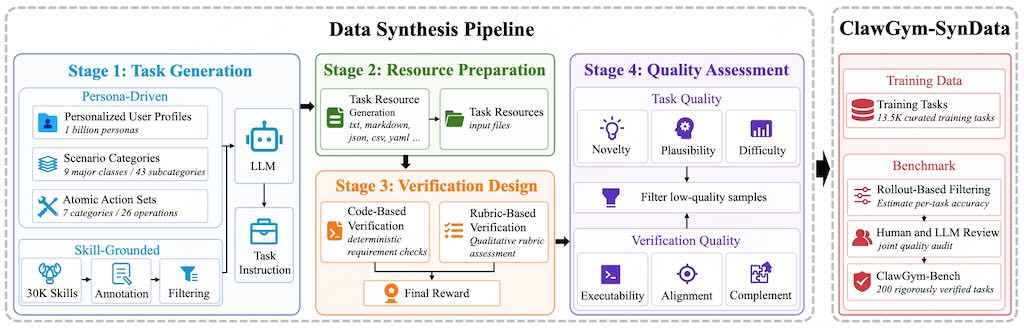
ClawGym 框架的主要用途在於訓練和評估能夠在真實系統上執行任務的 AI 代理。以下是它的核心應用場景: 代理訓練與開發 ClawGym 提供完整的流程讓開發者能夠構建高效的 Claw 代理。框架透過合成大規模任務數據(13.5K 個經過篩選的任務)和智能軌跡收集,使 LLM 模型能夠學習如何在 OpenClaw 框架上自動執行真實任務。 自動化辦公與生產力 根據 OpenClaw 生態應用,Claw 代理可以執行: 企業級多智能體協作 ClawGym 支持構建多智能體團隊系統,實現: 性能評估與基準測試 ClawGym-Bench 提供了 200 個真實場景的評估基準,測試代理在辦公協同、信息檢索、內容創作、數據處理等場景的表現。

ClawGym 框架的主要用途在於訓練和評估能夠在真實系統上執行任務的 AI 代理。以下是它的核心應用場景:

代理訓練與開發

ClawGym 提供完整的流程讓開發者能夠構建高效的 Claw 代理。框架透過合成大規模任務數據(13.5K 個經過篩選的任務)和智能軌跡收集,使 LLM 模型能夠學習如何在 OpenClaw 框架上自動執行真實任務。

自動化辦公與生產力

根據 OpenClaw 生態應用,Claw 代理可以執行:

  • 代碼沙箱運行:自動編寫並執行 Python 腳本,完成非結構化數據的抓取與清洗
  • 跨應用自動化:通過自然語言完成複雜的多步驟工作流,例如「幫我設計一個監控面板,每天定時抓取 A 股新上市企業數據」,代理會自主規劃路徑:編寫爬蟲 → 抓取數據 → 自動修正邏輯 → 生成展示頁面
  • 辦公助手場景:寫代碼、寫文檔、處理日常流程

企業級多智能體協作

ClawGym 支持構建多智能體團隊系統,實現:

  • 多個 AI 分析師並行評估投資價值
  • 多智能體深度研究項目和趨勢分析
  • 代碼漏洞和架構質量的聯合審查

性能評估與基準測試

ClawGym-Bench 提供了 200 個真實場景的評估基準,測試代理在辦公協同、信息檢索、內容創作、數據處理等場景的表現。

Categories: 開源, Agentic, , 編程, OpenClaw


Page 3 of 4
1 2 3 4