InteractiveWorld:把穿戴式 AI 助理放進可驗證的互動世界

穿戴式助理要看見甚麼、怎樣給建議,最後能否幫人完成任務,InteractiveWorld 把整段互動放進可持續變化的 3D 場景中測試。

First-person view of the human walking to a soda can, grabbing it, putting it on the coffee table and sitting on the sof

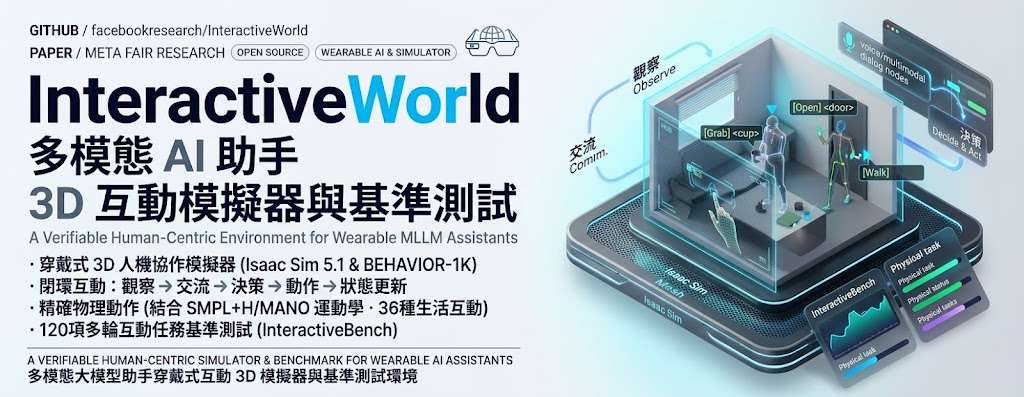
穿戴式 AI 助理不只要辨認眼前物件,還要理解人的要求、給出可執行的指引,並跟進行動後的變化。InteractiveWorld 是一套以人為中心的 3D 模擬器,用第一人稱視角呈現環境,讓助理與模擬人物多輪互動;同一個儲存庫亦提供 InteractiveBench,用來比較多模態大型語言模型(MLLM)在這類任務中的表現。

場景涵蓋 44 個 BEHAVIOR-1K 家居及活動空間。助理以對話提供建議,模擬人物則根據所見自行決定行動;研究者可用簡短指令描述抓取、開門、倒液體等操作,由模擬器處理移動、避障、操作物件及更新場景。世界狀態會延續到下一輪,因此助理要根據新視角調整回答,而非只生成一次性的文字答案。

InteractiveBench 收錄 120 個固定的多輪任務,分為六類,每類 20 個。評分會檢查場景中的狀態是否達成目標,而不是單憑回答文字判斷;基準亦提供評估流程、報告及影片。首頁資料提到曾以 12 個前沿 MLLM 進行評估,但所提供的內容沒有列出各模型分數,無法據此比較排名或判斷差距。

• 模擬器可用 Python API 開啟場景、執行動作、取得觀察結果及原生分數。
• 場景與人物行動涵蓋物件操作、室內移動及第一人稱畫面更新。
• 基準任務固定,適合研究團隊比較模型在多輪助理情境下的完成能力。
• 安裝指南列明資產準備與環境需求;執行需要處理 Isaac Sim 場景及相關資產,並非只呼叫一個輕量 API。

這個項目適合研究穿戴式助理、多模態模型及具身互動的團隊,尤其是需要可重複測試、以環境狀態核實結果的工作。模擬場景能補足純文字評測看不到的行動後果,但仍不能完全代表真實佩戴裝置時的感測誤差、人的習慣差異或實體操作風險;評測結果應視為模擬環境中的能力證據。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, API, Video, 3D, Python, 庫, Meta, 蘋果

CoPE 讓 Agent 逐步預測行動,節省一半訓練樣本

CoPE 以多步行動預測補強 Agentic RL,在不增加推論成本下,提升語言智能體的學習效率。

CoPE

長軌跡只靠完結時一次獎勵學習,往往會令多數步驟欠缺直接回饋。CoPE 是建基於 AgentGym-RL 及 verl 分支的強化學習框架,透過逐步預測智能體接下來會採取的 K 個行動,為每個決策位置加入更細緻的訓練訊號。

模型骨幹同時負責 acting 與 forecasting:智能體按既有 policy 行動,並在每一步預測未來行動;完成 rollout 後,真實行動序列會監督預測結果,再把學習成果蒸餾回同一個 policy。關閉相關功能後,訓練路徑便維持標準 Group Relative Policy Optimization(GRPO),方便按研究需要比較。

  • 每一步預測 K 個後續行動,補充終結獎勵欠缺的分步監督。
  • acting 與 forecasting 共用一個模型,不需額外模型或預訓練階段。
  • 推理時仍逐步行動,不加入額外運算開支。
  • 支援 SciWorld、ALFWorld、WebShop、AppWorld 及 τ²-bench 五個互動環境。

結果顯示,CoPE 在上述環境擊敗 GRPO 與 predictive-auxiliary baselines;樣本效率最高提高 2 倍,其中 ScienceWorld 為 2.0 倍、AppWorld 為 1.6 倍。任務成功率相對 GRPO 在 ALFWorld、WebShop 與 ScienceWorld 分別增加 5.0、12.5 及 8.0 個百分點。

配置需要 Python 3.10 訓練環境及獨立環境服務;WebShop 使用 Python 3.8,τ²-bench 需要 Python 3.12 或以上,並須取得 AgentGym submodule。這套架構適合研究互動式語言智能體、計算成本受控的團隊,以及比較 action forecasting 與稀疏獎勵訓練方法的開發者,但多環境配置與 GPU 需求增加了安裝門檻。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 框架, Python, Meta, 強化學習

nanoMuse:跨裝置、會先徵求同意的開源個人代理

nanoMuse 將手機、電腦與網頁連成同一個個人代理,能代辦事情,也會在刪除、傳送或付款前停下來確認。

nanoMuse: an open-source personal agent for every device you own

你可以在手機交代工作,讓 nanoMuse 轉到電腦執行,完成確認時再把要求送回手上的裝置。它屬於開源個人代理項目,處理的是跨裝置協作、持續執行與高風險操作控管。nanoMuse 是獨立的社區項目,與 Meta Platforms, Inc. 無關

手機 App、桌面 App、網頁控制台和串連各裝置的 relay 放在同一個 GitHub 儲存庫,支援 Android、iPhone、iPad、macOS、Windows、Linux 和網頁。Shell、瀏覽器、MCP servers、skills,以及可透過畫面操作手機 App 和電腦視窗的 Hands,全部經 Sentinel 轉接;刪除、傳送或付款前會要求批准,代理本身不會直接執行工具。

  • Markdown 檔案可讀寫,用來描述代理身份、記憶和喚醒時機
  • App 關閉後仍可繼續工作,裝置共用同一個帳戶和對話
  • 可使用社群 relay 的免費模型額度,亦可改用自己的 key
  • relay 能在自家伺服器運行,減少資料離開住所的需要

和 Muse、OpenMinis 的比較:nanoMuse 明確沿用 Meta Muse 式的個人代理方向,但把手機、桌面、網頁、relay 和安全批准機制一併開源。Android、Windows、macOS 和 Linux 有下載版本,iPhone、iPad 則透過 TestFlight beta。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 框架, 工具, Mac, Linux, 庫, 安全, Meta, 免費試用, 中國, 蘋果, Skill 技能

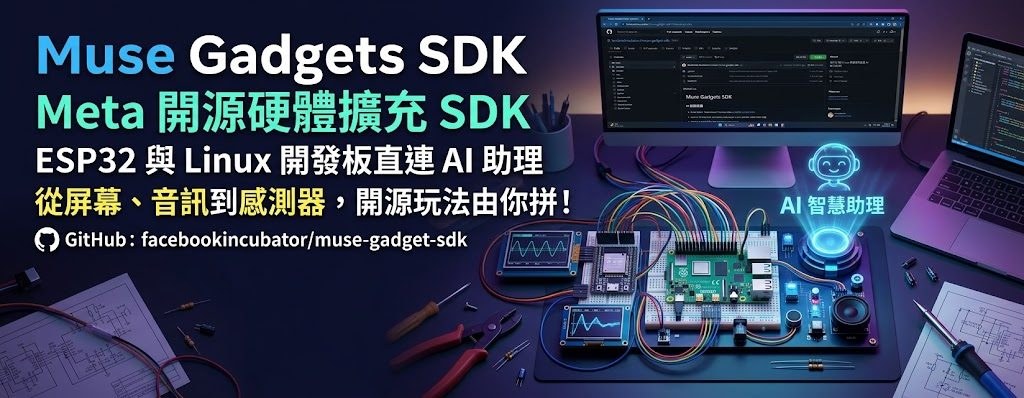
Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

NAVA-WAM 讓機械人從影片學會直接行動

NAVA-WAM 從無動作標註影片學習機械人策略,減少視覺表徵與潛在動作之間的轉換限制。

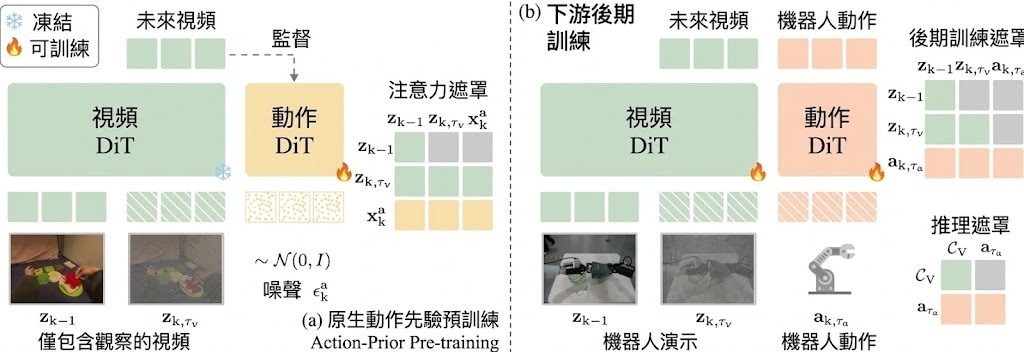
Overview of NAVA-WAM: action-free pre-training and downstream post-training.

機械人只看過人類操作影片,未必需要先建立中間視覺表徵或獨立的潛在動作模型,便能學習下一步應怎樣移動。NAVA-WAM(Native Action-Prior Learning from Videos for World Action Models)是一個 World Action Models(WAM)項目,直接從 observation-only videos 預訓練 action policy,處理動作標註機械人軌跡不足的問題。

訓練分為兩個階段:第一階段利用影片中的未來視覺變化作 flow-matching supervision,透過 transition-structured joint attention 將與動作相關的資訊傳入 Action-DiT;第二階段再加入動作資料,讓策略對應到機械人控制。這種做法避開先學視覺、再轉換成控制訊號時可能出現的落差。

實驗把經 DROID 訓練的策略直接放到實體 Franka FR3,沒有針對個別任務再微調。在三項任務共 15 次測試中,NAVA-WAM 平均成功率為 93.3%,DreamZero 為 66.7%,π0.5 為 53.3%;伺服器端每次 policy call 為 379.2 毫秒,按每次重新規劃實際執行的動作數計算,每個動作約 15.8 毫秒。

• 從 observation-only videos 直接學習 action policy
• 不依賴中間視覺表徵或獨立 latent-action model
• 在空間關係任務中,NAVA-WAM 成功 4/5 次,兩個基線均為 0/5
• 已在實體 Franka FR3 上測試,未作任務專屬微調

T1 要求把方塊放到碗的左側,基線模型雖能正確定位和抓取方塊,卻未能理解指令中的空間關係;NAVA-WAM 則較能將視覺互動經驗連接到具體控制行動。項目的限制是訓練仍需要第二階段的動作資料,並非完全脫離機械人示範,因此更適合用作擴充動作先驗,而不是取代所有實體機械人資料。

項目主頁

Categories: AI productions, 模型, 模型訓練, Video, World-Action Model, Robotic, Meta

moe_vie 視覺編碼器:CLIP 規模 MoE 化,最細版本也貼近 SOTA

Meta 團隊把 Mixture-of-Experts 帶進 CLIP 風格視覺編碼器,用細粒度專家路由配合自訂 Triton kernel,在零樣本分類與檢索上貼近體型大 1.7 倍的 SOTA 編碼器。

Repository image for facebookresearch/moe_vie

視覺編碼器愈變愈大,準確度換來的是推論成本與延遲同時膨脹,特別是高解析度圖片與長影片情境。MoE-ViE 想打破這個取捨:把 Mixture-of-Experts(MoE)機制引入 CLIP 風格的對比預訓練流程,讓模型總容量擴大,但每張圖、每段片只啟用一部分專家,把容量與實際計算脫勾。

與一般 MoE 不同,MoE-ViE 採用細粒度專家拓樸(fine-grained MoE topology),並提出一個無輔助損失(auxiliary-loss-free)的變體來平衡專家負載,避免傳統 MoE 常見的負載不均問題。同時,作者針對 MoE 額外開銷撰寫了專門的 Triton kernel,把推論延遲拉回接近密集模型的水準。

項目以 Vision Transformer 骨幹搭配上述 MoE 設計,配合穩健的對比預訓練流程(contrastive pretraining recipe),一口氣釋出 B / L / H 三個尺寸的模型,覆蓋 224 / 384 / 448px 解析度。在 ImageNet-1k、ObjectNet、COCO 文字檢索圖片、Kinetics-400、MSR-VTT 文字檢索影片等基準上,零樣本表現與各項強 CLIP baseline 相當甚至更佳,其中 H/14 版本在保持約 76% 延遲的情況下,貼近體型大 1.7 倍的 SOTA 編碼器。當對接 LLM 組成視覺語言模型時,MoE-ViE 在圖像與影片基準上亦勝過多個啟用參數多達 5 倍的編碼器。

另一個針對影片能力的處理方式是 frame-level distillation 加上一個新設計的凍結機制,目的是在引入影片理解的同時保留原本學到的圖像知識。這個步驟令同一組視覺編碼器可以同時服務圖像與影片任務,而不必訓練兩套模型。

重點摘要:

  • MoE 化的 CLIP 風格視覺編碼器:以 Mixture-of-Experts Vision Transformer 配合對比預訓練,支援 B / L / H 三種規模。
  • 細粒度專家拓樸 + 無輔助損失平衡:避免傳統 MoE 的專家負載不均,並以自訂 Triton kernel 控制推論延遲。
  • 圖像與影片兼顧:frame-level distillation 配合新凍結機制,讓單一編碼器同時處理圖像與影片理解。
  • 對接 LLM 後仍具競爭力:在多項圖像與影片基準上,表現勝過啟用參數多達 5 倍的既有編碼器。
  • 官方釋出代碼與零樣本評測套件:提供模型定義、配置檔與可重現的零樣本評估流程,惟授權為 CC BY-NC 4.0,需留意非商用限制。

本項目由 Meta 團隊發佈。需要留意的是授權為 CC BY-NC 4.0,僅限非商用場景使用;訓練細節、資料組成與對齊 LLM 的實作屬研究配置,重現成本不低,較適合作研究基準而非即取即用的產品元件。

GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Meta

ConCor-1:一句標註都唔使畀,自動搵出圖文對應

ConCor-1 將視覺語言定位反轉成雙向概念對應,唔使預先指明想搵乜字句,畀一張圖同一段文字就會自動判定邊啲文字對應邊個物件。

Bidirectional concept correspondence: a caption, a referring expression and a category list all produce the same output

以往做視覺語言定位,多數流程都要你先講明想搵邊句字,模型再喺圖入面指出對應區域。ConCor-1 索性反轉呢個做法:畀一張圖同一段文字,無論係完整描述、指代表達,定係一列類別名,模型都會自己判斷邊段文字同圖入面邊個物件對得上,然後一次過畀齊文字遮罩、實例遮罩同對應分數。研究團隊由華盛頓大學、Allen Institute for AI 同 Meta FAIR 組成,模型基於預訓練視覺語言模型,再加上一組可學習嘅 bridge tokens 嚟代表候選對應。

呢種設計最大嘅實用價值,係省卻前置標註嘅工序。當你手上得一段長 caption 或者一大串類別名,傳統方法往往要逐句拆開再分批餵入,ConCor-1 直接當作一次對應預測處理,文字分割、影像分割、跨模態對齊三件事一齊做。佢將 phrase grounding、referring expression 同 open-vocabulary detection 收納成同一格式,等訓練同評測可以用統一數據集比較。

ConCor-1 喺長 caption 數據集上將 correspondence F1 提升 48%,喺零樣本 LVIS、即用大類別清單當文字輸入嘅場景亦提升 29%。Hugging Face 上已有模型權重、數據、Space Demo,源代碼以 Apache 2.0 發佈。對做細粒度理解、自動化標註,或者想整合長描述入視覺流程嘅團隊,呢個框架值得留意;想自行重現訓練嘅人就要再等等,現階段主要提供推論程式碼同評測即將推出。

重點摘要

  • 雙向概念對應:毋須預先指明文字,直接輸出文字遮罩、實例遮罩同對應分數
  • 統一格式:將 phrase grounding、referring expression、open-vocabulary detection 收成單一預測任務
  • 基於 bridge tokens:喺預訓練視覺語言模型上加可學習 token 代表候選對應
  • 顯著提升:長 caption F1 提升 48%,零樣本 LVIS F1 提升 29%
  • 開源配套:模型權重、數據、Space Demo 同推論程式碼已於 Hugging Face 同 GitHub 公開

適合需要從圖文配對中抽取結構化對應、做自動化標註、或研究視覺語言定位框架嘅讀者。ConCor-1 將文字分割、影像分割同跨模態對齊壓成單一任務,特別適合處理長描述或大類別清單等場景。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Meta, Dataset 數據集

Meta Muse Glimmer:為本地多模態代理而生

Muse Glimmer 30B 針對本地部署而設,把圖文理解和代理式操作放在同一個模型裡。它同時提供 BF16、GGUF 與 ExecuTorch 版本,方便不同裝置取用。

Meta

Muse Glimmer 30B 屬於多模態 agentic model,重點放在本地部署時的可用性。對需要在自己裝置上處理圖文輸入、又想保留代理式工作流的用戶來說,這種設計比只提供單一格式的模型更實用,因為可以按硬件環境選擇合適版本。

Meta 這次一口氣放出多種包裝,包括 BF16 權重、GGUF k-quants、ExecuTorch builds,還有一個較細的 assistant 版本。這代表它不是只面向單一推理環境,而是嘗試覆蓋桌面、本地推理引擎,以及流動裝置部署等不同需求。

從現有資訊看,Muse Glimmer 的核心價值在於把多模態能力和本地執行的彈性結合起來。GGUF 版本方便在本地執行推理,ExecuTorch 版本則指向更輕量的裝置端部署;對想控制資料流向、減少依賴雲端服務的工作流,會更有吸引力。

  • 支援多模態輸入,適合圖文混合任務
  • 針對 local deployment 設計,部署選擇較多
  • 提供 BF16、GGUF k-quants、ExecuTorch 等不同格式
  • 有 30B 主模型與較小的 3B assistant 版本
  • 適合需要本地推理、裝置端或代理式工作流的場景

現時公開資料較集中在模型包裝與部署形式。就定位而言,它更像是一個面向實用部署的多模態模型系列,而不是只靠單一規格吸引注意的發佈。

項目主頁 · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, API, Image, LLaMa, 安全, Meta

Meta 提出多模態預訓練的關鍵:視覺要及早融入

模型學習文字、看圖與生成圖像,未必會自然互相增益。這組研究拆解知識如何流動,並提出更有效的多模態預訓練配方。

Og image

對需要同時理解文字與影像、甚至生成影像的模型來說,最難處理的不只是資料量,而是不同能力會否互相拖累。這項由 Meta FAIR、Reality Labs 與 University of Oxford 團隊進行的研究,以統一多模態預訓練為焦點,探討語言、視覺理解和視覺生成怎樣共同學習。

研究發現,跨模態知識流動並不對等。語言資料可普遍提升各類視覺任務;視覺理解會為影像生成提供強而有力的先驗知識;視覺生成對其他能力的直接幫助則較有限,主要透過加快低階概念學習,間接改善理解能力。團隊亦以 CLEVR 合成資料集配合真實世界資料,分辨不同概念之間的轉移方式。

  • 語言可增強視覺理解與視覺生成能力
  • 任務愈複雜,模態之間愈可能出現競爭
  • 參數共享方式會改變不同模態能否產生協同效果
  • 視覺路徑應由預訓練初期同步學習
  • 延後加入視覺訓練,可能造成「vision laziness」

「vision laziness」指模型過度依賴語言捷徑,未有充分學習影像訊號。研究比較早期統一訓練、後期整合及順序式訓練後認為,視覺與語言由一開始共同演化,表現會較穩定;將視覺資料延後加入,即使模型其後接觸影像,也未必能補回早期錯失的表徵學習。

團隊把受控實驗得出的資料混合比例與擴展策略,套用至以 2T tokens 訓練的 13.5B Mixture-of-Experts(MoE)模型驗證。對設計多模態基礎模型的人而言,研究提供的價值不在單一架構,而是指出資料配比、任務難度、共享設計與整合時機,均會直接影響模型是否真正學會運用視覺。

項目主頁 · Paper

Categories: 多模態模型, 模型訓練, Meta

HumanCLAW 直指 VLM 身體感缺口

當 Vision-Language Models 真正要控制一個會碰撞、會受重力影響的人形身體,表現遠比畫面理解困難。HumanCLAW 把問題拆開來量度,直接揭開 VLM 行動判斷的弱點。

HumanCLAW teaser

畫面睇得明,不等於身體識得郁得啱。HumanCLAW 把 Vision-Language Models(VLMs)放進一個閉環人形行動測試環境,集中量度模型每個瞬間應該做哪個動作,而不是把失敗全數歸咎於低層馬達控制。它屬於評測框架兼基準測試項目,處理的是 VLM 在具身場景中的行動決策能力,到底有沒有足夠「身體感」去完成找路、移動與互動。

呢個設計最值得留意的地方,是它把 action decision-making 與 low-level motor execution 分開。每 0.5 秒,凍結的 VLM 只需要根據第一身視角、指令、技能列表與歷史內容,提出一個 atomic whole-body skill;後面的 verifier、motion generator 同 half-physics simulator 再負責驗證、安全過濾與連續動作執行,令接觸、碰撞、重力等物理後果仍然保留下來,但平衡失誤與動作追蹤誤差會被盡量排除。

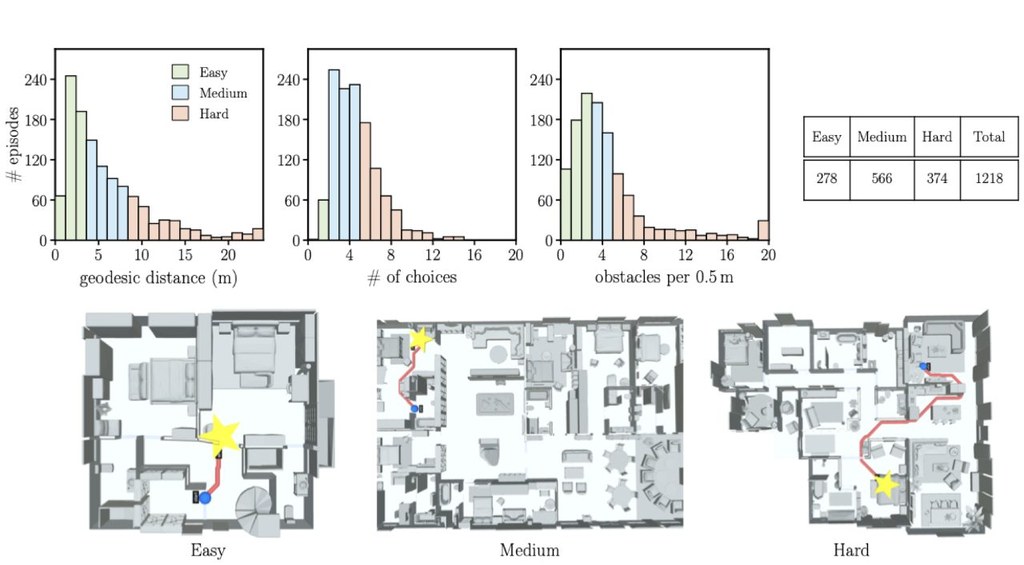
HumanCLAW-Bench 則在這個框架之上提供 1,218 個長時程 find–navigate–interact episodes,覆蓋 41 個室內場景。數字相當直接:九個最先進 VLM 全部未能解決這套基準,最佳成績只有 16.8% success rate,反映問題不在單次辨識,而在模型持續追蹤自身位置、判斷是否到達目標,以及理解自己有沒有撞上環境。

  • 把高層決策同低層動作分離,較易睇清 VLM 真正弱點
  • 保留真實物理後果,唔會因為純符號化環境而高估能力
  • HumanCLAW-Bench 著重長時程、第一身視角、連續互動任務
  • 目前公開資訊顯示程式碼與 benchmark 仍在準備釋出

對研究 embodied AI、Computer-use agents 延伸方向、VLM 評測方法的人來說,呢個項目有參考價值,尤其適合用來檢查模型是否具備 closed-loop spatial action intelligence,而不只是識描述畫面。現階段較大的限制也很清楚:GitHub 儲存庫尚未正式放出 harness、motion generator weights、half-physics simulation environment 與完整評測內容,暫時主要仍是透過 project page、paper 同 leaderboard 理解方法與結果。

項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Meta, Dataset 數據集, Skill 技能

Page 1 of 3
1 2 3