NAPE 簡化自監督音訊片段訓練

NAPE 以因果 Transformer 預測下一個音訊 patch embedding,省去解碼器與 tokenizer,探索更精簡的音訊表徵學習方法。

NAPE Architecture

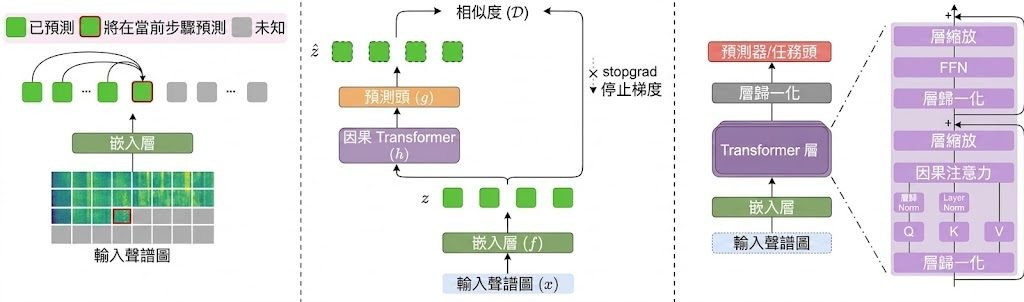
音訊模型要兼顧訓練成本、表徵能力與模型規模,往往需要加入多個輔助模組。NAPE(Next Audio Patch Embedding prediction)是一個自監督音訊表徵學習框架,將 log-mel spectrogram 切成 patch,再由因果 Transformer 根據前面的片段預測下一個 patch embedding。

NAPE 沒有 reconstruction decoder、acoustic tokenizer、student-teacher 架構或額外正則化損失。它依靠三個機制維持學習訊號:causal masking 隱藏未來位置、prediction shift 要求位置 t 預測 t+1,以及 stop-gradient 固定目標 embedding,避免模型退化成輸出相同向量。

二維 spectrogram 會按指定 scanning order 轉成一維序列,研究涵蓋 raster、diagonal、zigzag 和 time-major 四種排列;其中 raster、diagonal 及時間方向的排列較符合聲音事件的發展。模型在 AudioSet 預訓練,再於 AudioSet-2M、AudioSet-20K、ESC-50、Speech Commands V1/V2 和 IEMOCAP 進行微調或 linear probing,資料顯示它在多項任務取得 state-of-the-art fine-tuning 結果,並具備穩定的跨規模擴展能力,但原始資訊沒有提供各項具體分數。

要求系統有 Python 3.10、PyTorch 2.8.0 和 Transformers 4.56.2 的環境,並提供 requirements 檔及部分資料集處理程式;ESC-50、Speech Commands V1/V2 和 IEMOCAP 有下載腳本,AudioSet 則要自行處理涉及 YouTube 的下載流程。研究團隊亦列出程式碼及預訓練 checkpoint 的發布資訊,但 Hugging Face checkpoint 仍標示為待辦,不能把完整模型取得流程視為已經齊備。

  • 訓練訊號精簡:只用下一個 patch embedding 預測與 stop-gradient。
  • 適合音訊表徵:可支援語音指令、環境聲音及情緒辨識等任務。
  • 排列順序有影響:spectrogram 的線性化方式會改變模型看到的時間關係。
  • 測試門檻清楚:需要 AudioSet 或下游資料集,以及 W&B 追蹤實驗。
  • 限制在資料流程:AudioSet 不提供同等簡化的下載方式,checkpoint 取得狀態亦未完全明確。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, Audio, Python, 語音

demystify-agent-skills:Agent Skills 點樣幫到代理,又會喺邊度失手

呢個研究項目唔係再做一個新 agent,而係拆解 Agent Skills 真正幫緊乜、又會喺邊一步開始失靈。這項目讓你會更易判斷技能封裝值唔值得放入自己嘅自動化流程。

Offline retrieval precision

當你想將一段成功經驗整理成可重用指引,最麻煩唔係有冇記錄,而係代理之後會唔會真係拎啱、用得啱。demystify-agent-skills 係一個研究型程式碼項目,圍繞 Agent Skills、Workflow Memory 同 raw trajectories 做受控比較,集中處理代理經驗應該點樣封裝,先至更有機會幫到後續任務。

佢吸引嘅地方不只是話「技能有用」,而係拆開幾層去驗證。相同來源經驗同相同目標任務之下,Skill 成功率有 61.9%,高過 Workflow Memory 嘅 55.9%,差距係 6.06 個百分點;但增益主要來自 procedural anchoring,佔 65.7%,唔係靠明示成功或失敗標籤去灌輸知識。

  • 同一批 agent trajectories 會被整理成 raw、Workflow Memory 同標準化 SKILL.md,再放返去同一類 target tasks 測試
  • retrieval、agent selection 同 real execution 係分開檢查,唔當成單一路徑
  • skill pool 由 5 增加到 100 時,embedding top-1 precision 由 88.3% 跌到 76.9%
  • parsed actual-use precision 會由 29.6% 進一步跌到 3.3%,但 downstream success 仍大致維持喺 36% 至 39%

「識得檢索」同「真係用對技能」原來係兩回事。項目指出 invocation 本身會帶來新失敗邊界:Skill 案例入面,有 10.0% 係誤用或者忽略技能指引,明顯高過 Raw 嘅 0.8% 同 Workflow Memory 嘅 0.4%。換句話講,技能格式改善咗執行穩定度,卻同時引入另一個決策風險。

呢個項目較適合研究 Agentic workflow、做 AI agent 評測,或者想建立可重用 skill library 嘅團隊重現。並非安裝一個即用產品,而係沿住 raw traces、matched artifacts、retrieval diagnostics 同 target task evaluation 去重跑實驗;對正在設計 Computer-use agents、CUAs 或其他多步代理流程嘅人,呢份分析比單看總成功率更有參考價值。

項目主頁 · GitHub

Categories: 開源, Agentic, Embedding, , Skill 技能

LLM_Modularity:MIT 研究拆解 LLM 模組化認知架構

同一類推理會反覆動員同一批神經元,跨領域則明顯分開。這個項目把 LLM 內部的「分工」做成可重跑的分析流程。

probe.py types a reasoning prompt for each cognitive domain; the model

人腦展現出顯著的功能特化程度,不同的神經網路分別支持語言、形式推理、對他人心智的推理以及對物理世界的推理。這種模組化組織是智慧系統建構的基本原則,還是生物大腦特有的進化偶然現象?本文檢驗了大型語言模型(LLM)——另一類透過截然不同的最佳化過程所建構的智慧系統——是否也呈現出類似的組織結構。

值得留意的不是它再講一次模型會推理,而是它嘗試回答:大型語言模型做語言、數理、物理同社交推理時,內部是否真的有近似人腦功能網絡的分工。Pengrui-Han/LLM_Modularity 屬於研究分析工具與資料流程項目,核心工作是用 attribution patching、neuron overlap 同 causal ablation,定位 46 個任務在四個認知領域各自依賴的神經元群。

結論唔止停留在可視化。項目整理出六個 24B 至 123B frontier LLMs 的一致結果:同領域任務的神經元重疊高出 4.3 倍,ARI = 0.78;把某個領域相關神經元做 lesioning 或 ablation,該領域準確率下降幅度比跨領域高 10.3 倍。換句話說,模組化唔係單靠圖像解讀,而係有因果干預支持。

跟一般只看 attention pattern 或 embedding 聚類的做法相比,這個項目更著重「哪些單元真的支撐任務完成」,所以會用 full-sequence teacher-forcing metrics、corrupted-activation ablation,同按模型家族調整的 nnsight 載入流程。代價亦很直接:它不是輕量級 demo,需要 Linux、torch 2.10.0、nnsight 0.4.1,同 NVIDIA GPU;24B 至 123B 模型更要多 GPU 才較可行。

  • 覆蓋 Language、Formal reasoning (Multiple-Demand)、Physical reasoning、Social reasoning (Theory of Mind) 四類推理
  • 提供 46 個任務配置、clean/corrupted data pair、分析腳本與已整理 results CSV
  • 重點不在訓練新模型,而在檢查現有 LLM 內部神經元是否出現穩定分工
  • 已附 figures、overlap matrix 同 ablation analysis,適合延伸做復現或二次研究

較適合做 mechanistic interpretability、認知科學、AI 安全,或者想比較 Qwen、其他大型模型內部推理結構的研究團隊。它暫時更接近研究管線,而不是即裝即用產品;不過資料夾結構、config、scripts 同 results 已經足夠完整,對想重跑實驗、改任務集,或者把 OSWorld 以外的複雜推理基準接入分析流程的人,參考價值相當高。

項目主頁 · GitHub

Categories: 開源, Embedding, Qwen, NVIDIA, Linux, 安全

MiniMax-H3-Text-Embeddings ?

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。

Og image

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。MiniMax-H3-Text-Embeddings 實際上是 DiffSynth-Studio 團隊為 MiniMax-H3 影片生成大模型所設計的「視覺特效/風格控制向量(Diffusion Templates / Textual Inversion)」。

MiniMax-H3 是一個高達 33B 參數的大型多模態生成模型,若要透過訓練 LoRA 來控制風格或特效,顯存與算力成本非常高。DiffSynth-Studio 團隊採用了類似 Textual Inversion(文字翻轉/概念嵌入) 的做法:

  1. 極輕量替代方案:將特定特效(如火爆、風暴、環繞鏡頭等)預先訓練或編碼成特徵 Tensor。
  2. 直接注入文字特徵層:這些檔案體積非常小,能在推理階段直接替換或疊加到 MiniMax-H3 的 Text Encoder 輸出上。
  3. 模組化與組合:使用者可以像掛載外掛一樣,組合多個特效 Embedding 來控制生成的影片視覺效果。

3. 總結建議

  • 如果你是在找 RAG / 知識庫 / 搜尋用的文本嵌入模型:請忽略此模型,這不是向量檢索工具。
  • 如果你是在使用 DiffSynth-Studio 進行 MiniMax-H3 影片生成:這是用來快速套用影片特效、節省顯存並替代重型 LoRA 的控制模組。

項目主頁

Categories: 開源, RAG, Embedding, 視頻模型, MiniMax

NanoVDR:70M 文字編碼器取代 2B VLM:視覺文檔檢索的輕量化新嘗試

NanoVDR 把 2B 參數嘅視覺語言模型蒸餾成 69–151M 嘅純文字編碼器,查詢時完全唔需要視覺模型,CPU 51 毫秒即可完成。

NanoVDR

處理幾十萬張文件圖片嘅時候,每次查詢都要過一次 2B 嘅視覺語言模型(VLM),開銷大到令人卻步。NanoVDR 想解決嘅就係呢個落差:文件索引由教師模型離線建好,查詢階段只用一個 DistilBERT 規模嘅純文字編碼器,CPU 上 51 毫秒出結果,2048 維嘅單一向量直接做點積,扔得入 FAISS。

佢嘅做法係將 Qwen3-VL-Embedding-2B 凍結做教師,提早把目標向量快取落嚟,學生只係學一個餘弦距離嘅 loss——即係 loss = 1 - cos(student, teacher)。訓練時冇相關性標註、冇負例採樣,兩邊完全解耦,所以查詢端同索引端可以分開換組合。DistilVDR 進一步把文件端都換走,做到成個流程都唔再需要教師。

對於做企業 RAG、法律文件搜尋、學術庫檢索嘅團隊,最大吸引力係每頁索引得 4 KB,比 ColPali 嗰類多向量檢索慳 64 倍儲存,而且唔使 GPU 即可頂住查詢負載。ViDoRe v1 上面,NanoVDR-S-Multi 拎到 82.2 NDCG@5,保留咗教師大約 95% 嘅能力,呢個取捨對批量部署嚟講好實際。

重點摘要:

  • 極輕量查詢端:文字編碼器僅 69–151M 參數,無需視覺模型參與查詢
  • 高效索引:每頁僅 4 KB(float16),比多向量方案節省約 64 倍儲存
  • 簡易整合:輸出為單一向量,FAISS 即可處理,無需 MaxSim 池化
  • 教師-學生解耦:目標向量預先快取,兩端可獨立訓練與組合
  • 完整資源:模型、訓練數據集、線上 Demo 同論文均已開源

多向量查詢塔嘅程式碼已就位,但 checkpoint 要等 NanoVDR-v2 先出齊,想要更高召回嘅人需要留意後續更新。

項目主頁 · GitHub

Categories: 開源, RAG, Embedding, 模型, 視覺模型, 多模態模型, Qwen

WorldTrace 令世界模型影片記住更遠場景

影片世界要模型生成得夠長,往往先開始失憶。WorldTrace 針對呢個斷層,想保住長時段生成同遠距場景回想能力。

Og image

做長時間影片生成時,Video World Models 最易出現的問題唔係畫面唔夠靚,而是走出訓練長度之後開始「唔認得之前見過乜」。WorldTrace 針對的正是呢種視覺記憶失效:它屬於 Video World Models 的記憶機制改良方法,重點是令 Key-Value (KV) cache 裡已壓縮的內容,過了原本訓練範圍之後仍然可以被模型重新定位和讀取。

核心思路不是再訓練一個新生成器,而是用 training-free 方式處理記憶可尋址性。研究指出,問題關鍵在 temporal Rotary Positional Embeddings (RoPE) 偏移超出訓練 horizon 後,注意力機制即使保留了舊畫面資訊,都未必再讀得到;再加上在 RoPE 旋轉空間直接平均 key,會令不同 phase 互相抵消,令記憶內容變得模糊。WorldTrace 透過固定、仍屬 in-distribution 的 slot 位置保存壓縮記憶,避免記憶「存在但搵唔返」。

同一套記憶框架下,它分成兩個方向:WorldTrace-Field 用 rotation-invariant 的歷史聚合方式,支援較連貫的長 rollout;WorldTrace-Landmark 則保留較接近原樣的 scene traces,讓模型隔了更長時間後,仍有機會回想曾經到過的場景。這種分工反映出一個很實際的取捨:有些情境重視連續生成的穩定性,有些則更需要精準回憶特定地點或視覺片段。

  • 針對訓練 horizon 以外的記憶失效,而不是單純提升畫質
  • 保持壓縮後的 KV memory 可尋址,重點在 fixed in-distribution slot positions
  • WorldTrace-Field 偏重長序列生成的一致性
  • WorldTrace-Landmark 偏重遠距離場景召回與保留視覺痕跡
  • 原始資料將它描述為 training-free,未見提供安裝、下載或部署流程

這類方法較適合需要長時間互動、持續追蹤場景變化,或者要求模型記得自己曾經去過哪裡的工作流,例如互動式模擬、可探索影片環境與長時段世界狀態建模。現有資料亦提到它獲 ICML 2026 F2S Workshop Best Paper。

項目主頁 · 項目

Categories: Embedding, 世界模型, 模型訓練, NVIDIA, Video, 框架, Dataset 數據集

WorldTrace 令影片世界模型記住更遠場景

影片世界要模型生成得夠長,往往先開始失憶。WorldTrace 針對呢個斷層,想保住長時段生成同遠距場景回想能力。

Og image

做長時間影片生成時,Video World Models 最易出現的問題唔係畫面唔夠靚,而是走出訓練長度之後開始「唔認得之前見過乜」。WorldTrace 針對的正是呢種視覺記憶失效:它屬於 Video World Models 的記憶機制改良方法,重點是令 Key-Value (KV) cache 裡已壓縮的內容,過了原本訓練範圍之後仍然可以被模型重新定位和讀取。

核心思路不是再訓練一個新生成器,而是用 training-free 方式處理記憶可尋址性。研究指出,問題關鍵在 temporal Rotary Positional Embeddings (RoPE) 偏移超出訓練 horizon 後,注意力機制即使保留了舊畫面資訊,都未必再讀得到;再加上在 RoPE 旋轉空間直接平均 key,會令不同 phase 互相抵消,令記憶內容變得模糊。WorldTrace 透過固定、仍屬 in-distribution 的 slot 位置保存壓縮記憶,避免記憶「存在但搵唔返」。

同一套記憶框架下,它分成兩個方向:WorldTrace-Field 用 rotation-invariant 的歷史聚合方式,支援較連貫的長 rollout;WorldTrace-Landmark 則保留較接近原樣的 scene traces,讓模型隔了更長時間後,仍有機會回想曾經到過的場景。這種分工反映出一個很實際的取捨:有些情境重視連續生成的穩定性,有些則更需要精準回憶特定地點或視覺片段。

  • 針對訓練 horizon 以外的記憶失效,而不是單純提升畫質
  • 保持壓縮後的 KV memory 可尋址,重點在 fixed in-distribution slot positions
  • WorldTrace-Field 偏重長序列生成的一致性
  • WorldTrace-Landmark 偏重遠距離場景召回與保留視覺痕跡
  • 原始資料將它描述為 training-free,未見提供安裝、下載或部署流程

這類方法較適合需要長時間互動、持續追蹤場景變化,或者要求模型記得自己曾經去過哪裡的工作流,例如互動式模擬、可探索影片環境與長時段世界狀態建模。現有資料亦提到它獲 ICML 2026 F2S Workshop Best Paper,但公開內容目前集中在方法動機與設計,效能細節在這份摘要材料中仍然有限,閱讀時應留意完整論文是否提供更完整的量化結果與測試設定。

項目主頁 · 項目

Categories: Embedding, 世界模型, 模型訓練, NVIDIA, Video, 框架, Dataset 數據集

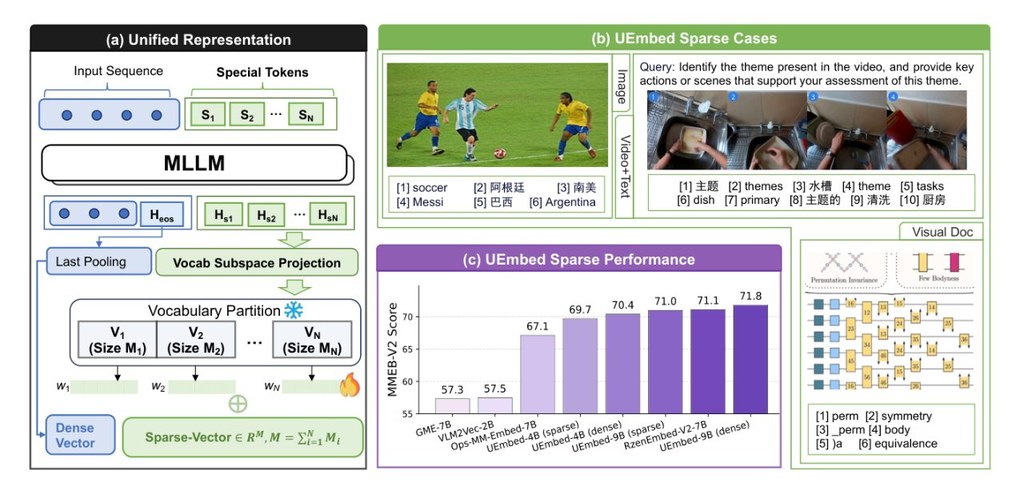
UEmbed:單一模型同時做稠密與稀疏檢索

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

Temporal-Distance-JEPA 訓練世界模型能懂「時間距離」

香港浸會大學團隊把 JEPA 世界模型由「會預測」推近一步到「更識規劃」。Temporal-Distance-JEPA 針對離線示範缺少回報訊號的痛點,直接從軌跡次序挖出可用的進度成本。

Repository image for HKBU-KnowComp/Temporal-Distance-JEPA

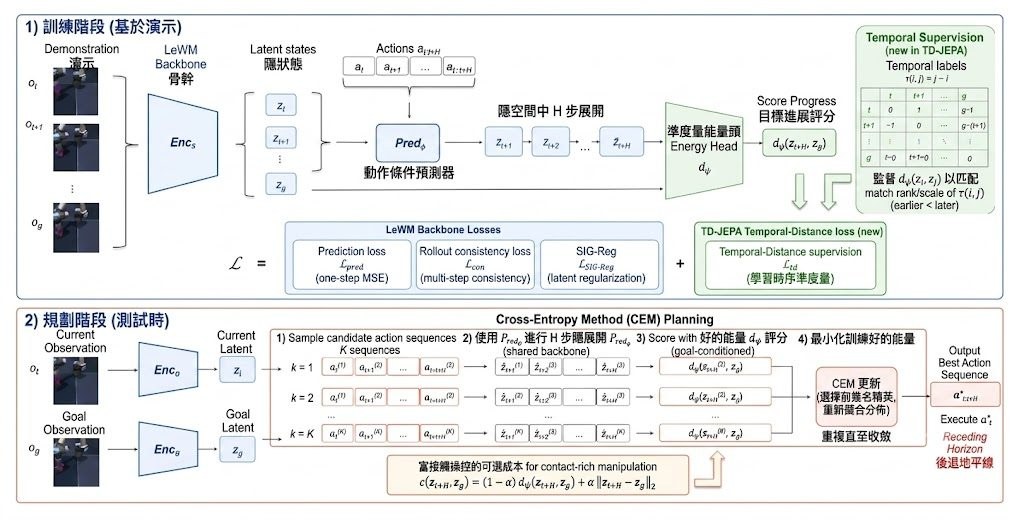
香港浸會大學 HKBU KnowComp 的 Jiaxin Bai 公開了 Temporal-Distance-JEPA 論文重現項目,核心不是再做一個更複雜的世界模型,而是修正 JEPA 規劃常見的落差:訓練時學短期 latent prediction,規劃時卻往往直接拿 latent Euclidean distance 當成目標進度。這個項目屬於模型研究重現項目,處理的是離線示範沒有 reward 時,planner 點樣判斷哪條想像路徑更接近目標。

作者保留 LeWM encoder–predictor 與 SIGReg backbone,但不再只依賴 embedding 幾何,而是從 reward-free demonstration logs 挖出 directed temporal cost。做法沿住論文邏輯很清楚:同一條 trajectory 的先後步序提供 positive targets,跨 trajectory 配對充當 heuristic negatives,再用 rollout-consistency 令學到的成本更貼近 planner horizon。這種 framing 直接回應舊範式把 latent L2 當成進度代理的限制,因為拓撲主導任務未必適合只看幾何距離。

結果在 Two-Room、Reacher 這類 topology-dominated tasks,規劃時直接部署 mined cost d_psi;到了 Push-T、OGB-Cube 這類 contact-rich tasks,則改用同一個 temporally trained checkpoint 上的 latent l2 planning。locked evaluation 下,Two-Room 成功率提升到 100.0%,高於 LeWM 的 97.4%;OGB-Cube 亦比 LeWM 高 14.2 分,並且整體上對 LeWM 與 RC-aux baseline 都能持平或更好。

  • 建基於 stable-worldmodel、stable-pretraining 與 LeWM 既有布局,重點在訓練目標與規劃成本的重新對齊
  • 公開庫是 paper-reproduction release,保留 Python CLI,但刻意不附 cluster/Slurm 包裝
  • 資料以 HDF5 形式放在 STABLEWM_HOME,涵蓋 Push-T、Two-Room、Reacher、OGB-Cube
  • 採用 10 epochs,並附有 locked results、cost matrix、diagnostics 等結果資料

這個庫比較像給已有研究工作流的人接手重跑:有 Python 環境、requirements、Hydra config、資料位置與 checkpoint 輸出方式,但沒有替不同排程系統準備現成封裝。歷史上的 contrastive SoftJEPA 相容程式仍可能留在 losses.py 或 jepa.py,不屬於公開配置;換句話說,閱讀與重現時要以 td_jepa 設定為準。對做 world model、offline RL、latent MPC 的研究團隊來說,這個項目最有價值的地方,是它把「表示學到什麼」與「規劃要怎樣排序未來」重新綁在一起。

GitHub · Paper

Categories: 開源, 浸會大學, Embedding, 世界模型, 模型訓練, 香港, Python, 中國

ARI 用 RAG 修復韓國朝鮮古籍殘字

遇到人名、地名殘缺的古籍,單靠上下文往往會估錯。ARI把檢索到的史料一併交畀模型判斷,明顯更適合做歷史文獻修復。

Method Figure

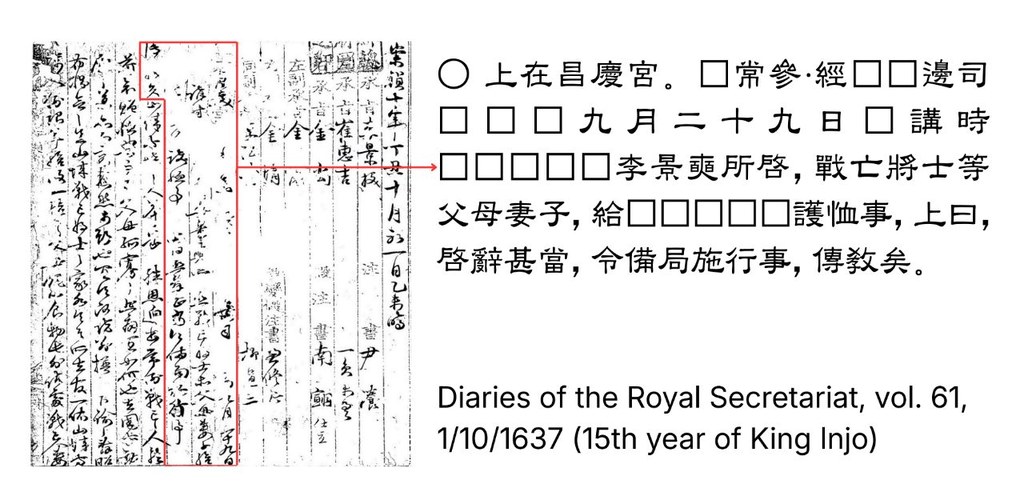
最值得留意的,不是模型把缺字補回來本身,而是它專門處理古籍修復最棘手的一類內容:人名、地名等 Named Entities。ARI 屬於一個結合 Retrieval-Augmented Generation(RAG)的文獻修復框架,針對朝鮮王朝實錄與承政院日記這類韓文漢字史料,補足只靠局部語境時經常失準的缺口。

現有做法多數依賴 masked language modeling,擅長根據前後文猜測一般字詞,但一遇到需要外部史實支持的專名就容易失手。ARI 的取向很清楚:先用 BM25 從歷史語料找出前 20 份相關文本,再以字串相似度 0.8 過濾重複內容,將這些外部證據交給模型一併生成,修正通用 LLM 容易出現的幻覺。

模型部分不是從零開始,而是建基於 Qwen3 32B 與 Qwen3 8B 微調成 ARI-32B 和 ARI-8B,並加入 25% named entity-prioritized masking 訓練策略,把學習重點放在知識密集片段。論文亦指出,對漢字材料而言,詞彙層面的 BM25 檢索比 embedding-based retrieval 更有效,這一點頗有說服力,因為表意文字的字形與字詞對應關係本身就影響檢索效果。

  • 適合歷史文獻整理、數位人文研究與古籍校勘團隊參考
  • 主要強項在於修復需要外部知識支撐的 Named Entities
  • ARI-32B 與 ARI-8B 同步提供,前者追求表現,後者較重視運算成本
  • 論文結果顯示,它在 named entity 與隨機遮罩字元修復都勝過多個基線與通用模型

把它視為一個已有公開模型與方法說明的研究項目。對需要先驗證效果的人來說,現階段較合理的路線會是先查看論文設定與模型頁面,再判斷是否足以接入自己的古籍修復工作流。

項目主頁 · GitHub · Paper

Categories: 開源, RAG, Embedding, 模型, Qwen, 語音, Dataset 數據集

Page 2 of 5
1 2 3 4 5