DomainShuttle 開源:把主角穿梭到任何風格的影片

香港科技大學 C4G 團隊發表 DomainShuttle,以 14B 參數規模實作跨域主體一致性影片生成,並釋出權重與推理代碼。

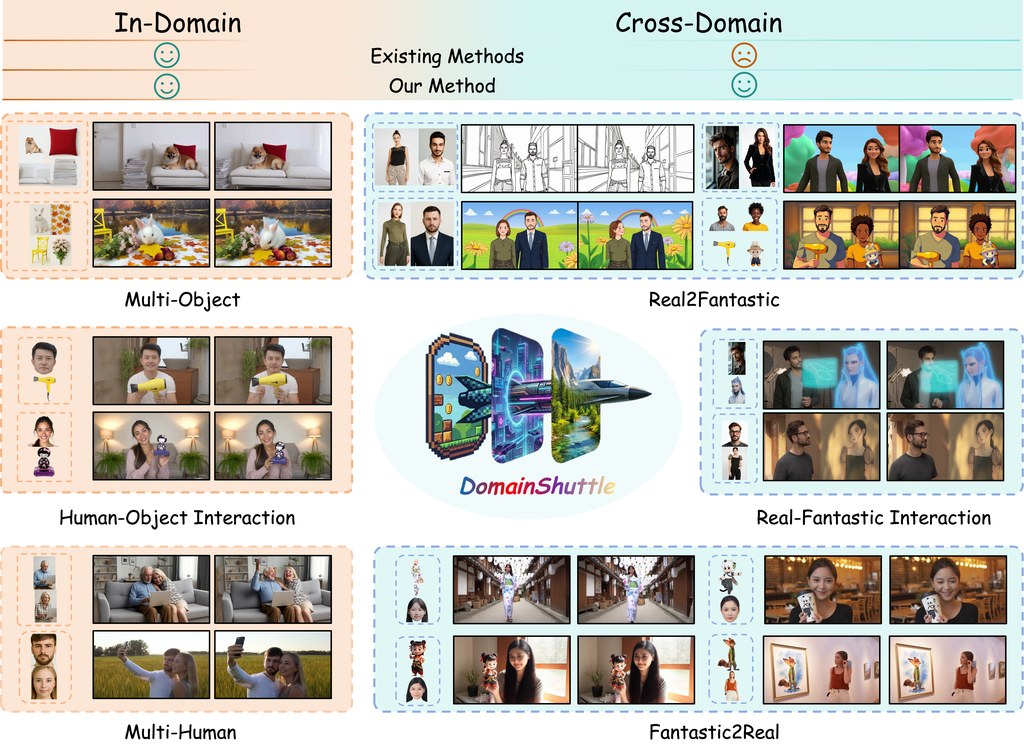
teaser

DomainShuttle 是一個以 Wan2.2-T2V-A14B 為基底的 subject-driven text-to-video(主體驅動文字轉影片)框架,目標是讓用戶提供一張參考圖後,能在不同視覺風格與場景中維持同一角色的身份一致性。過去的 subject-driven 方法多在 in-domain(與訓練資料同域)下能保留主體細節,但一旦跨域到風格差異大的場景,主體往往走樣或失去身份特徵;DomainShuttle 把參考特徵與影片特徵解耦,並引入 domain attribute 建模與 intrinsic subject representation,試圖兼顧 in-domain fidelity 與 cross-domain editability。

開發團隊來自香港科技大學 C4G 實驗室,作者群包括 Nan Chen、Yiyang Cai、Rongchang Xie、Junwen Pan、Cheng Chen、Weinan Jia、Zhuowei Chen、Wen Zhou(項目負責人)、Zhenbang Sun 以及通訊作者 Wenhan Luo。等貢獻作者共同發表技術報告,並同時釋出 14B 規模的非官方權重與推理代碼。

先以 conda 建立 Python 3.10 環境並安裝 PyTorch 2.5.1(CUDA 12.4),接著執行 build_env_conda.sh。模型準備分兩步:先用 huggingface-cli 下載 Wan-AI 的 Wan2.2-T2V-A14B 作為基底模型,再下載 CNcreator0331/DomainShuttle_weight,最後將 VAE、configuration.json 等檔案移入指定的 ./models/Diffusion_Transformers/Wan2.2-DomainShuttle-A14B/ 目錄。原始資料未提供完整推論指令片段,相關細節需參考技術報告與項目頁面的後續說明。

從示範結果看,DomainShuttle 能在寫實人物、動漫風、Ghibli 風、3D 動畫風等不同域之間切換,同時保留臉部與服飾特徵,跨域 personalisation 效果明顯。適合短片創作、角色 IP 化、廣告分鏡與動畫預覽等需要「同一角色穿梭多場景」的團隊。需注意目前釋出的是非官方實作,且依賴 14B 規模的基座模型,部署對顯存要求較高。

重點摘要:

  • 類型:subject-driven text-to-video 框架,建基於 Wan2.2-T2V-A14B
  • 開發團隊:香港科技大學 C4G 實驗室,Wen Luo 為通訊作者
  • 核心設計:解耦參考與影片特徵、加入 domain attribute 與 intrinsic subject representation
  • 與同類差異:強調 cross-domain editability,補足過往方法跨域走樣的缺陷
  • 資源:已釋出 14B 權重、技術報告與推理代碼,需 CUDA 12.4 環境

GitHub: https://github.com/HKUST-C4G/DomainShuttle

項目主頁: https://cn-makers.github.io/DomainShuttle/

模型: https://huggingface.co/CNcreator0331/DomainShuttle_weight
Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Stable Diffusion, Video, 框架, 香港, Content Creator, IDE, 3D, Python NLP, Python, 動畫

Semantic Browsing:用樹狀圖掌控 AI 生圖的多樣性

Tel Aviv 大學團隊提出 Semantic Browsing,以多智能體流程把單一文字提示展開成可瀏覽的語意樹,讓圖像生成的多樣性變得可控且可解讀。

Og image

Semantic Browsing 是一篇發表於 ECCV 2026 的學術項目,由 Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or 共同開發。它針對文字生成圖像模型在重複取樣時容易「語意塌縮」、產出過於雷同的問題,提出一套可控多樣性的工作流程。

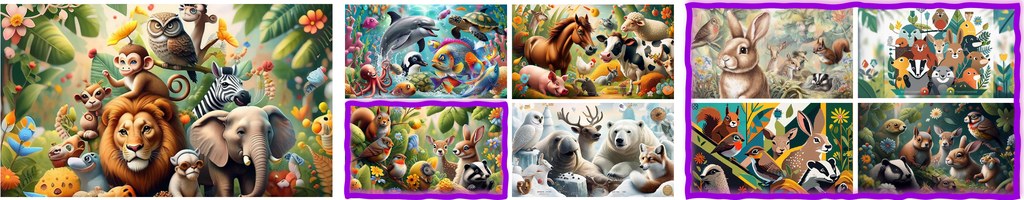
這套方法的核心做法,是把多樣性從像素層級搬到文字層級。系統會先用多智能體(multi-agent)流程把使用者的提示擴寫成結構化的場景 JSON,記錄物件、屬性、互動與整體場景設定,再從中找出提示中未明確指定、但合理的變化軸心。每一次分支都對應一個明確的語意決定,例如角色、構圖或風格的差異,最終形成一棵可瀏覽的場景樹。

與一般常見做法相比,這個項目最值得留意的差異在於:變化不是來自隨機噪聲,而是來自可解讀的語意約束。樹狀結構讓使用者可以沿著特定分支往下探索,同時保留先前已固定的條件,方便在設計空間中做有意識的導覽。

重點摘要:

  • 開發團隊:Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or。
  • 核心方法:以多智能體流程把提示展開為結構化 JSON 場景樹。
  • 可控多樣性:每個分支對應一個明確的語意決定,而非隨機變化。
  • 適用情境:概念設計、視覺探索、需要比較多個語意詮釋的創作流程。
  • 目前狀態:程式碼尚未公開,僅釋出 arXiv 論文與項目頁。

使用方法詳細教學:

  1. 準備提示:先寫好一段文字提示,例如「A poster featuring animals」,提示中可以刻意留白部分細節,讓系統有空間展開變化。
  2. 進入項目頁:前往 Semantic Browsing 的官方網頁(saradorfman1.github.io/SemanticBrowsing-webpage/),等待互動介面載入。
  3. 送出提示並生成根節點:系統會先推論出一個初始場景詮釋,作為場景樹的根節點。
  4. 瀏覽與選擇變化軸心:介面會列出可變化的語意面向,例如角色、構圖、風格等,每個面向都會顯示目前值與替代選項。
  5. 展開分支:選定一個面向並挑選替代值後,系統會呼叫多智能體流程,在保留先前約束的前提下產生新的子節點與對應圖像。
  6. 沿著分支深入探索:可以重複步驟四與五,沿著感興趣的路徑繼續往下展開,逐步建立一棵專屬的設計樹。
  7. 匯出或記錄結果:若需要保留特定分支,可記下該節點的場景 JSON 或截圖,作為後續迭代或團隊溝通的依據。

由於程式碼尚未釋出,目前只能透過項目頁的示範介面體驗流程;待官方開源後,便能整合進 ComfyUI、Stable Diffusion 等本地生圖工作流。對於從事概念設計、視覺探索,或需要比較多個語意詮釋的創作者與研究人員來說,這套方法提供了一條比隨機抽樣更可控的探索路徑。

項目主頁: https://saradorfman1.github.io/SemanticBrowsing-webpage/

Paper: https://arxiv.org/pdf/2606.23679

Categories: 開源, ComfyUI, Agentic, 模型, 視覺模型, Stable Diffusion, Image, 影像處理, 教學

PerceptionDLM:多區域圖像描述加速方案

PerceptionDLM 把多個區域描述改成並行生成,重點不是只追準確度,而是連速度一齊納入比較。

icon

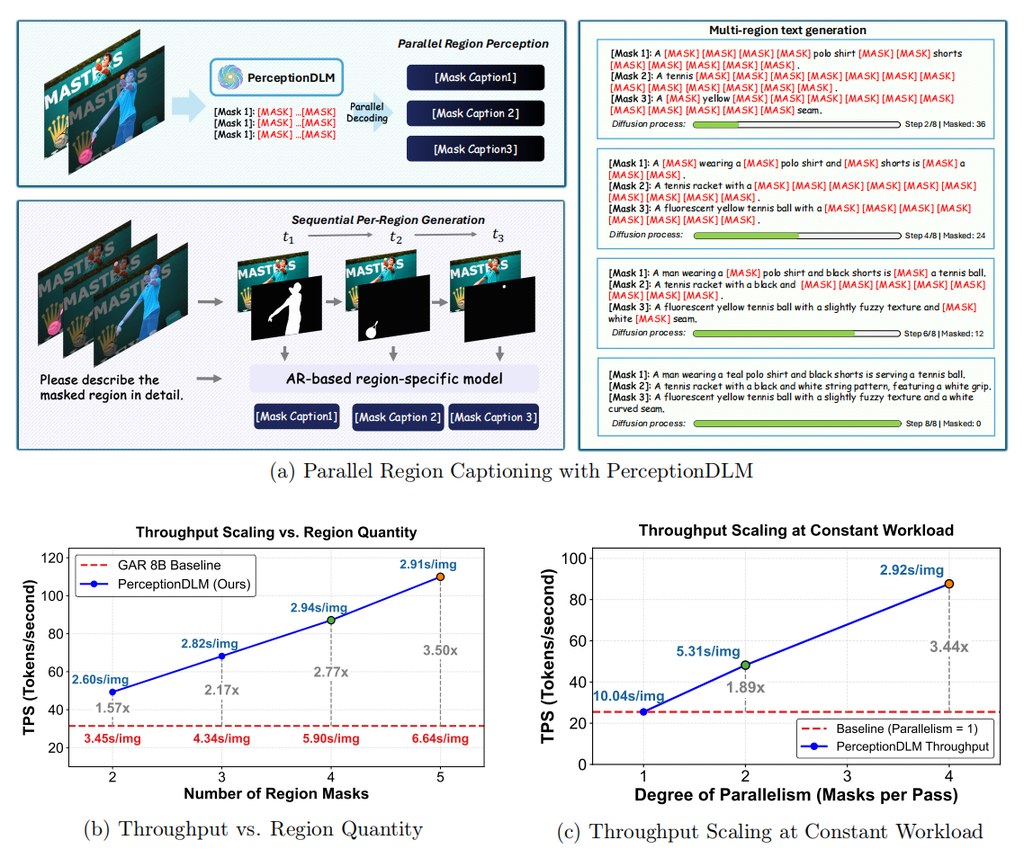
現時不少 Multimodal Large Language Models (MLLMs) 做區域描述時,仍然依賴 autoregressive (AR) 逐段生成:一張圖有幾多個 mask,就要逐個區域慢慢解讀。PerceptionDLM 提出的方向很明確,改用 Multimodal Diffusion Language Model,同一輪 denoising process 內同時輸出多個區域描述,目標是解決多區域感知在延遲上隨數量線性上升的問題。

這是一個偏向模型加基準測試的開源項目:核心是 PerceptionDLM 與 PerceptionDLM-Base,另加 ParaDLC-Bench、PerceptionDLM-Data 和 Bee / Honey 系列訓練資料配方。作者點名批評舊範式主要卡在 autoregressive region captioning,因此加入 efficient prompting 與 structured attention masking,讓平行生成不只停留在概念,而是落到 sequence level 同 token level。

從公開資料看,這個項目較適合以 Hugging Face 已釋出的模型、資料集與 evaluation suite 來理解和測試;想重現結果的人,亦可沿住訓練資料配方、Training 與 Evaluation 流程部署。對一般開發團隊而言,最有參考價值的不是安裝細節,而是它示範了 diffusion VLM 怎樣處理「多區域同時描述」這種以往較少由 DLM 承擔的任務。

  • 單次 denoising pass 可同時描述多個 masked regions,官方稱在密集多區域情境可有最高 3.4× throughput speedup
  • PerceptionDLM-Base 據稱在 16 個 multimodal benchmarks 之中,15 個勝過 LLaDA-V
  • ParaDLC-Bench 不只看 caption quality,也把 inference efficiency 一併納入
  • 已公開 code、model weights、training data recipe、evaluation suite,重現門檻比只放論文低

它較適合做視覺理解、圖像標註、自動資料整理,或者需要一次看多個區域的研究團隊。限制也很清楚:目前公開資訊主力強調 benchmark 與吞吐提升,對一般產品場景的記憶體需求、延遲分佈與部署成本仍要再看實測;相關模型則包括 PerceptionDLM、PerceptionDLM-Base,以及其 backbone LLaDA-8B-Instruct,對比對象則有 LLaDA-V。

GitHub: https://github.com/MSALab-PKU/PerceptionDLM

項目主頁: https://msalab-pku.github.io/projects/PerceptionDLM/index.html

項目: https://huggingface.co/collections/MSALab/perceptiondlm-model-zoo

Categories: 開源, 北京大學, 字節跳動, 模型, 視覺模型, 多模態模型, 模型訓練, Stable Diffusion, 提示詞, Dataset 數據集

FreeStyle:用社群 LoRA 做雙參考生圖

FreeStyle 不只放出資料,亦重整了雙參考生圖的訓練與評測方法。它的焦點是減少風格參考偷帶內容,同時保住畫風。

FreeStyle teaser

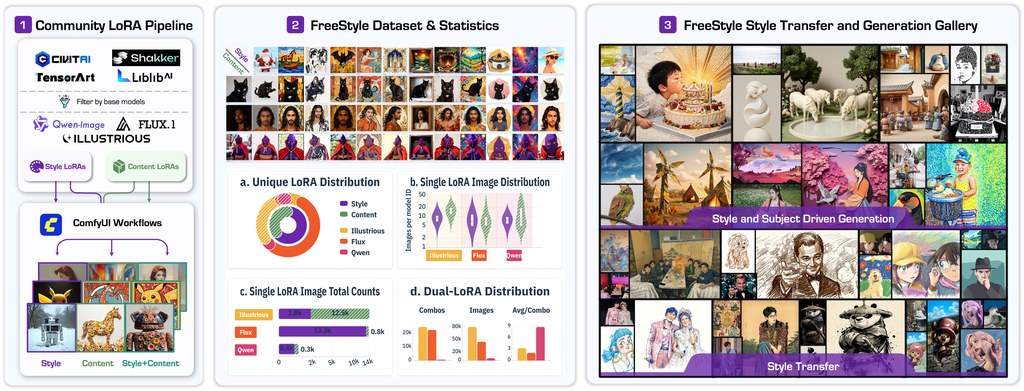
現時不少 style-reference 生成,只處理單一風格參考;至於 content + style dual-reference,常見難位是資料難整、風格長尾不足,兼且 style reference 容易把人物、物件等內容一併「滲」入結果。FreeStyle 把社群 LoRA 視為風格或內容概念的聚類中心,再配合自動生成與過濾流程,重組出可訓練的雙參考資料,連 benchmark 一起補上。

這不是單純模型,而是一個結合資料管線、benchmark 與 DiT-based model 的影像生成項目,目標是解決 SRef 與 CRef+SRef 兩類任務中,內容保持、風格對齊與 leakage suppression 很難同時兼顧的問題。文中提出 attention-level constraint,以及 RoPE low-frequency modulation,核心取向很清楚:寧可多做約束,也要壓住 style-reference content leakage。

資料規模是 FreeStyle 最有份量的部分。CRef+SRef dataset 提供 480K sequences,涵蓋 1,704 種 styles;SRef dataset 則有 619,302 sequences、622 種 styles。評測亦不只看靚唔靚,還加入 CSD、OneIG、DINOv2、CAS、CLIP-T、aesthetic predictors 及 VLM-as-judge,將 style similarity、content preservation、instruction following 同 leakage rejection 分開量度。

想理解怎樣測試這個項目,較合理的做法是分三層看:先用公開 dataset 與 benchmark 檢查資料結構;再看 repo 提供的 LoRA metadata 與 ComfyUI workflows,理解 triplet 怎樣生成與驗證;最後才研究 checkpoint 表現。它較適合研究團隊、做可控生圖的產品組,或者本身已在用 FLUX、Qwen、Illustrious 生態的人。

  • 把 Civitai、TensorArt、Liblib 的社群 LoRA 變成可用訓練訊號
  • 同時覆蓋 SRef 與 CRef+SRef,而非只做單一風格參考
  • 重點不是單純追求風格像,而是壓低內容洩漏
  • 提供 dataset、benchmark、workflow、checkpoint,便於重現整個流程

相關模型與基礎生態包括 DiT-based model、FLUX、Illustrious、Qwen,以及資料生成用的 ComfyUI workflow。若你關心的是商用穩定性,仍要留意它相當依賴社群 LoRA 品質與過濾流程;作者亦有講明,原始 LoRA 權重本身未必會隨項目再分發。

GitHub: https://github.com/Blue2Giant/FreeStyle

項目: https://blue2giant.github.io/FreeStyle/

Categories: 開源, 阿里巴巴, ComfyUI, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Stable Diffusion, Image, 影像模型, 影像處理, 工具, Content Creator, Sora, Meta, Dataset 數據集

UniAR 用一個 Transformer 包辦看圖、作圖、改圖

UniAR 針對多模態模型常見的雙 tokenizer 分裂問題,改用單一視覺 tokenizer。這個方向同時瞄準理解、生成與編輯三種影像任務。

teaser

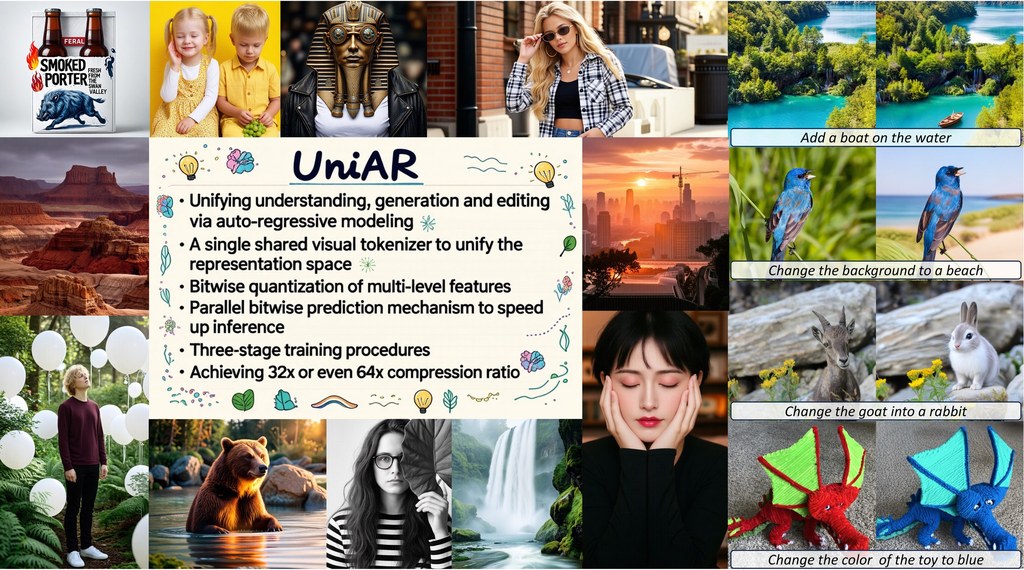
現有 Unified Multimodal Models(UMMs)多數會把影像理解和影像生成分開處理,常見做法是用兩套 visual tokenizers。作者認為這種 fixed paradigm 會把表示空間拆開,模型生成完圖片後,還要再重新編碼才能理解自己剛產生的內容,shared context 也就難以真正成立;UniAR 因此提出一個 unified autoregressive framework,用單一 discrete visual tokenizer 連接理解、生成與編輯。

項目屬於多模態模型,目標是用同一個 Transformer 解決 image understanding、image generation 和 image editing 之間來回切換的成本。它的核心判斷很直接:若模型看圖與作圖共用同一套視覺 token,流程就不需要額外 re-encoding,系統結構會更一致。

技術上,UniAR 有幾個辨識度很高的設計。Multi-level BSQ tokenizer 把高層語意與低層細節一併保留,並透過 Binary Spherical Quantization 擴大有效 vocabulary;parallel bitwise prediction 則把視覺碼以分組方式一齊預測,令 autoregressive 長序列壓短,論文提到 1024×1024 影像只需 256 個 AR tokens,對應 32x visual compression ratio。

  • 單一 discrete visual tokenizer 取代雙 tokenizer 架構
  • 支援 image understanding、image generation、image editing 同模運作
  • Multi-level BSQ tokenizer 同時顧及語意與細節
  • parallel bitwise prediction 壓縮視覺序列,加快 autoregressive 生成
  • DiT-based visual decoder 以 discrete visual tokens 重建高保真影像
  • 需求:Python 3.12、CUDA 12.1+、推理的 GPU 記憶體 >= 24 GB

如果你想試這個項目,較合理的切入點不是直接拿來當日常工具,而是先看它公開的模型權重與項目頁,分開測理解、生成、編輯三類輸出是否一致。它較適合研究多模態統一架構的人、關注 Qwen 生態的開發者,以及想比較 autoregressive 與 diffusion 混合路線的讀者。

性能方面,原文聲稱 UniAR 經 large-scale pre-training、supervised fine-tuning 和 reinforcement learning 後,在 image generation 與 image editing 達到 state-of-the-art,同時在多模態理解 benchmark 保持競爭力。不過目前公開資訊較像研究成果展示,visual decoder training code 仍未完整放出,因此更適合拿來理解方法論,而不是立即評估成成熟生產工具。

相關模型與組件包括 SD3-medium visual decoder、Qwen Team 背景下的多模態模型路線,以及論文聚焦的 Unified Multimodal Models(UMMs)。若你在意的不是單次生成效果,而是模型能否「理解自己生成的內容」,UniAR 的 shared context 設計確實提出了一個有意思而且相當具體的答案。

GitHub: https://github.com/ShareLab-SII/UniAR

項目: https://sharelab-sii.github.io/uniar-web/

Categories: 開源, 阿里巴巴, AI productions, 模型, 多模態模型, Qwen, Stable Diffusion, Image, 影像模型, 影像處理, 框架, Vibe Coding, 工具

BRDFusion:物理與生成模型合體,城市街景逆向渲染新框架

結合物理渲染與生成式擴散模型,把城市影片拆解為幾何、材質與 HDR 光源,支援夜景模擬與物件插入等編輯應用。

logo

現有的城市場景逆向渲染方法長期面臨兩難:基於物理的渲染(physically-based rendering)雖然能嚴格遵守光學物理,但在重建與渲染階段容易產生雜訊與破圖;生成式模型(generative models,例如 DiffusionRenderer)能產出逼真影像,卻難以精準控制光源,例如車燈這類局部照明往往被忽略。BRDFusion 正是針對這個 trade-off 而設計的混合框架。

這個項目屬於研究型框架,目標是把多視角城市影片分解為幾何(法線、深度)、材質(albedo、roughness、metallic)與 HDR 環境光源,並支援新視角重照明、夜景模擬與動態物件插入等下游應用。具體做法上,它先用物理模型取得明確且一致的場景屬性,再借助生成式先驗(generative priors)緩解優化過程中的歧義;前向渲染時,物理模型負責可控渲染,生成模型則負責去噪與修補瑕疵。

測試方面,作者提供預處理資料集與預訓練權重,研究人員可直接下載並透過 tools/run_pipeline.py 跑推理與評估;硬體需求偏高,建議使用 NVIDIA RTX A6000,RTX 4090 在記憶體允許下可執行部分階段,但 Gen. Render 階段可能突破 24 GB 限制。資料集與評估影片亦同步發佈於 Hugging Face,方便重現結果。

這個項目的創新之處在於把「物理一致性」與「生成式品質」放在同一條管線中互補,而非二選一。對從事自動駕駛模擬、遊戲或影視場景重建的研究團隊而言,這是一個值得關注的方向。

重點摘要

  • 混合範式:物理渲染負責可控性,生成模型負責修補瑕疵,突破單一方法的極限。
  • 完整分解:輸出幾何、材質與 HDR 光源,支援新視角、夜景與物件插入。
  • 高硬體需求:建議 RTX A6000,4090 僅能跑部分階段。
  • 完整開源資源:程式碼、預訓練權重、資料集與評估影片均已公開。
  • 適用場景:自動駕駛模擬、城市數位孿生、影視級場景編輯。

GitHub: https://github.com/shigon255/BRDFusion

Categories: 開源, 清華大學, 模型, 視覺模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 影像處理, 框架, 工具, Meta, 深度學習

iMaC:把機械臂動作變成可預測影像

iMaC 不是只餵動作向量入模型,而是把未來動作轉成影像控制。這種 world model 更貼近機械臂與場景的空間互動。

overview

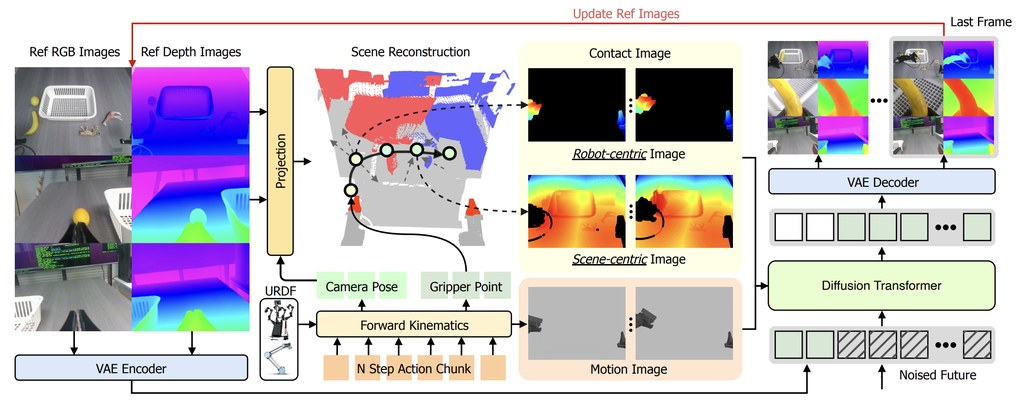
現時不少 action-conditioned video models 會把未來動作壓成 compact vectors,再經 learned conditioning modules 交給模型處理;作者認為這種做法要模型自行猜測細微空間後果,遇到 real manipulation 時,幾厘米差距已足以改變接觸、物件移動與任務成敗。iMaC 屬於世界模型與影片生成模型,核心是把 future joint actions 轉成 image-like controls,減少「動作有輸入,但空間關係表達不足」的問題。

這個項目的方法相當具體:先利用 robot URDF 與 forward kinematics,渲染 future robot-observation control videos,也就是 motion images;之後再加入 depth 作為輔助訊號,配合 3D pointclouds 建立 two-stream geometry controls,也就是 contact images。舊範式主要靠抽象向量條件化,iMaC 則把「未來機械臂會出現在哪裡、如何接近場景」直接變成可見控制,這是它最清晰的技術分野。

GitHub 儲存庫提供 training、preprocessing 與 inference code,覆蓋 RND-mix stage-one、stage-two,以及 WorldArena 三條流程。想試這個項目的人,會先由資料前處理、depth 與 3D condition 建立開始,再跑 validation inference 看生成影片是否跟動作一致;若本身做 robotic policy evaluation,還可以接到 WorldArena 或 online RND evaluation 場景。

  • 把 actions 轉成 motion images 與 contact images,空間條件更明確
  • 用 depth encoding 和 3D pointclouds 強化 robot-scene 幾何理解
  • 加入 training-time rollout strategy,目標是支援更長時序生成並減少 exposure bias
  • 儲存庫同時涵蓋訓練、前處理、推論,不只是論文展示模型
  • 相關組件包括 Wan transformer variants、Diffusion inference pipelines、RobotWin 2.0、WorldArena

性能方面,論文指出它在八個長時序真實機械人操作任務中,world-model success estimates 與真實 policy performance 呈強正相關。這個結果的價值不在於取代真機測試,而是在正式落機前,先用生成式 world model 篩選 policy checkpoints;對研究 embodied evaluation、robotics 與世界模型的人來說,iMaC 屬於相當值得跟進的一個方向。

GitHub: https://github.com/imac-wm/iMac

Paper: https://arxiv.org/pdf/2606.09813

Categories: 開源, 清華大學, AI productions, 模型, 視頻模型, 世界模型, 模型訓練, Stable Diffusion, Video, Image, Robotic, Vibe Coding, Mac, 3D, , 編程, Win

本地部署 Flux.1 – Comfyui 一键安装

本地部署 Flux.1 最强文生图大模型!Comfyui 一键安装,简单又方便 – 零度解说 最近,由前 Stability AI员工创立的黑森林实验室推出了开源图像生成模型Flux.1,可谓名声大噪,爆火全网。零度刚才已经上手使用,效果确实让我大吃一惊,真的很强!!!

Categories: ComfyUI, Stable Diffusion, 教學


StableSwarmUI 支援 Stable Diffusion 3

(英)StableSwarmUI,模組化 Web 介面, 重點在於易於存取、高效能和可擴展性 您可以在 Google Colab 或 Runpod 上運行 StableSwarmUI。或者,您可以按照文中说明在 Windows、Linux 或 Mac 上安裝它。 https://www.youtube.com/watch?v=Y_xT08sqIho 安裝教學及測試

Install Stable Diffusion 3 Locally: Step-by-Step with StableSwarmUI & ComfyUI
安裝教學及測試
Categories: Stable Diffusion

Page 2 of 3
1 2 3