AI Toolkit 把擴散模型訓練搬上消費級硬件

將多種新式圖像與影片模型放入同一套訓練工具,兼顧 GUI、CLI 與本地環境管理。

AI Toolkit UI

想在家用硬件微調 FLUX、Qwen-Image 等模型,過往往往要自行處理環境、依賴與介面;Ostris AI Toolkit 把這些繁複步驟整合成一套擴散模型訓練工具。官方資料未提供完整安裝指令,但建議透過儲存庫內建的 AI Toolkit Manager 啟動。

AI Toolkit Manager 會偵測硬件並配置合適的 PyTorch 版本、建立 Python 環境,以及下載 Node.js 和 FFmpeg,所有檔案留在 ai-toolkit 資料夾內,不會系統級安裝。啟動時亦會檢查更新;若本機檔案經修改,更新會跳過並發出警告,減少覆蓋自訂設定的風險。

它屬於開源訓練套件,可透過 GUI 或 CLI 操作,涵蓋圖像及影片模型訓練。模型支援範圍頗廣,包括 FLUX.1、FLUX.2、FLUX.2-klein 4B/9B、Lumina-Image-2.0、Qwen-Image-2512、SDXL,以及 Chroma、HiDream、OmniGen2、Z-Image、ERNIE-Image 等新式架構。

  • 以消費級硬件為主要目標,縮低本機訓練門檻
  • 同一套工具支援多種新舊擴散模型
  • GUI 與 CLI 並存,兼顧互動操作及批次流程
  • 依賴與模型資源集中管理,減少系統污染
  • 保留本機修改,並在更新衝突時給出警告

相較只針對單一模型或只提供訓練腳本的做法,AI Toolkit 的優勢是將模型選擇、環境配置與操作介面放進同一工作流。不過,原始資料沒有交代各模型的訓練速度、記憶體需求或量化設定,硬件是否足夠仍要視模型大小與訓練配置而定。

這套工具較適合需要建立角色、產品或風格資料的設計團隊、內容創作者,以及想在本地微調開源模型的開發者。模型及環境檔案仍佔用大量磁碟空間,影片模型亦可能帶來更高記憶體與運算負擔,部署前宜先核對個別模型的條件。
GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Stable Diffusion, Video, Image, 工具, Content Creator, Python, 庫, 百度

TextRIRO:修改文字內容並保留原始風格

讓圖片中的文字換內容、留風格,但處理範圍限於裁切文字區域,項目暫時只是作為研究,因此生成解像度亦有限制。我仍為這研究有助 Diffusion Model 發展更多的應用

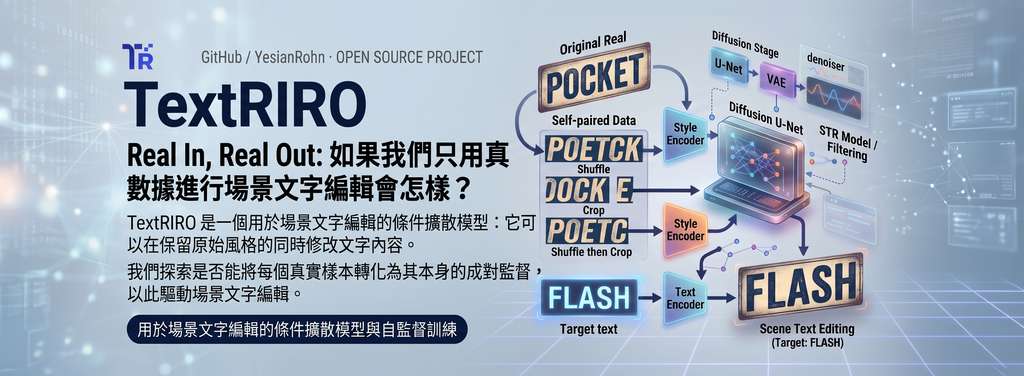
TextRIRO training, inference, STR-pretrained text encoder, and TextRIRO-3M construction pipeline

招牌或包裝上的字換了,仍希望保留原有外觀;TextRIRO 以條件擴散模型處理場景文字編輯(Scene Text Editing,STE),輸入裁切文字圖及替換內容,輸出改字後的圖像。

它以 Shuffle&Crop 打亂真實影像的文字語意,同時保留風格線索,讓每張圖形成自身的配對監督,毋須合成編輯前後配對或字元分割。多尺度風格編碼器配合以場景文字辨識(Scene Text Recognition,STR)預訓練的文字編碼器,分別提供外觀與字元條件。

「Real-only」只涵蓋編輯監督及文字編碼器預訓練。生成骨幹仍採用 Stable Diffusion(SD)1.5 的 U-Net 與 scheduler,以及 SD 2.1 的變分自編碼器(Variational Autoencoder,VAE)。

  • 可透過 Hugging Face Demo 試改文字。
  • 本地推理需 CUDA、模型權重及相關組件;儲存庫列出 Python 3.8/PyTorch 1.13 環境。
  • 生成解像度為 64 × 256,再還原來源尺寸,細節仍受限制。
  • RIROCommon 測試等長及變長改字;所附資訊未提供分數,不能判斷領先幅度。

文字辨識研究團隊亦可利用 TextRIRO-3M 的三百萬張長文字影像。這批資料由篩選後的編輯圖與原圖拼接而成,屬合成資料;完整照片改字流程,仍需另行處理文字區域裁切及回貼。

GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Stable Diffusion, Image, Python, 庫, Dataset 數據集

InfoVis 簡報生成與編輯能力整合到 9B 模型

InfoVis 讓同一個模型處理簡報生成、素材參考、模板控制與局部編輯,開源評測已接近 Nano-Banana-2。

overview

製作簡報圖像時,你可以用文字生成整頁投影片,也可以提供風格參考、內容素材或原有投影片作修改。InfoVis 屬於開源影像模型項目,集中處理文字轉投影片、模板條件生成、多圖像內容生成,以及按指令編輯投影片四類工作,減少不同模型之間切換所帶來的流程斷裂。

模型以 FLUX.2-klein-base-9B 為基礎,經過 slide-native continual pretraining、四任務混合 continual pretraining,再進行 task-specific SFT,最後把不同分支合併成單一模型。這種做法換來較完整的任務覆蓋,但同一模型要同時兼顧文字準確度、版面美感、內容對齊和精準編輯,效果仍會受提示內容及輸入素材質素影響。

VisSlideBench 收錄 1,527 個人工篩選案例,分別檢查內容忠實度、指令遵循、美感、語義一致性和簡報質素等指標。InfoVis 整體得分 7.94,略低於專有的 Nano-Banana-2(7.99),但在所有 11 項指標均領先受評開源模型;相較原始 FLUX.2-klein-base-9B,專門訓練帶來 1.6 分整體提升,美感仍是它與專有模型之間較明顯的差距。

項目提供 Hugging Face Space 的線上示範,再按需要下載模型權重、程式碼、InfoVis-Data 和 VisSlideBench 作本地研究或評估。這個項目較適合需要大量製作簡報草稿、產品提案、教學投影片的設計及內容團隊;本地執行 9B 模型則要自行準備相容的圖像生成環境,儲存庫資料未列出統一的硬件要求。

  • 四合一工作流:文字生成、模板控制、多圖像接地生成及指令式編輯由同一模型處理。
  • 專用訓練資料:提供超過 13M continual-pretraining records 及 1.9M SFT records。
  • 可驗證評測:VisSlideBench 同時公開資料集及評估程式碼。
  • 主要取捨:開源模型中表現突出,但整體仍稍低於 Nano-Banana-2,美感差距較大。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 教學, 庫, 中國, 蘋果, Dataset 數據集

LensErase 超精確移除物件,水印

只需圖片與 mask,LensErase 便可移除物件、文字或水印,再按周圍內容補回較自然的畫面。

logo mark

移除圖片中的水印、文字或多個物件時,難處往往不在於遮走目標,而是要同時處理陰影、反光及原本被遮住的背景。LensErase 以 foundation model 形式處理這類影像擦除工作,輸入一張圖片和一個 mask,輸出清理後的結果,適合海報整理、圖片修復及內容再利用等場景。

項目配套的 LensErase-100M 包含 101.07M 組對齊的 input–mask–target 三元組,涵蓋一般圖片、水印、大範圍 mask、視覺文字及海報五類資料,另有 140K 組 SFT samples 和 19K 組 RL samples。高解析度資料會由 GPT-5.6 Sol 檢查 mask 有效性、編輯正確性、重建效果及非目標內容保留程度。

LensErase-Bench 收錄 500 個案例,毋須指定唯一的 ground-truth target,改以 Removal、Inpainting、Preservation 和 Cleanliness 四個維度評估,當中完整移除目標及相關效果佔總分 40%。較貼近擦除任務的實際情況,因為同一個遮罩可能存在多個合理的背景補全方案。

  • 支援物件、視覺文字、水印及其相關效果的移除
  • 以 LensErase-100M 支援 pretraining、SFT 及 RL
  • 以 LensErase-Bench 評估移除、補全、保留和畫面潔淨度
  • 提供與 GPT-Image2.5-Sunburst、Flux2-Erase 及多個開源模型的比較
  • 頁面目前只表示 Code coming soon,未提供安裝、下載或使用流程

項目展示了跨場景和多物件擦除能力,亦包括海報及反射等較複雜案例。對需要批量清理素材、保留非目標結構的影像工作流;不過使用者仍需等待程式碼及更多可重現資料。

項目主頁

Categories: 開源, 北京大學, 模型, 模型訓練, 微軟, OpenAI, Stable Diffusion, Image, Dataset 數據集, 強化學習

CrossTimeEdit-release:用衛星變化還原歷史街景,補回城市記憶

CrossTimeEdit 把歷史街景生成改成有證據約束的影像編輯,利用新舊街景與衛星變化重建城市過去面貌。

CrossTimeEdit teaser

街景資料未必記錄到城市每次改建,CrossTimeEdit 便把近期街景、不同時期的衛星影像和跨視角資訊結合,推算較早期的街道外觀。這個項目屬於視覺生成模型及跨視角資料集,實際處理的是在保留未改變背景的同時,重建建築、道路或其他城市元素的歷史變化。

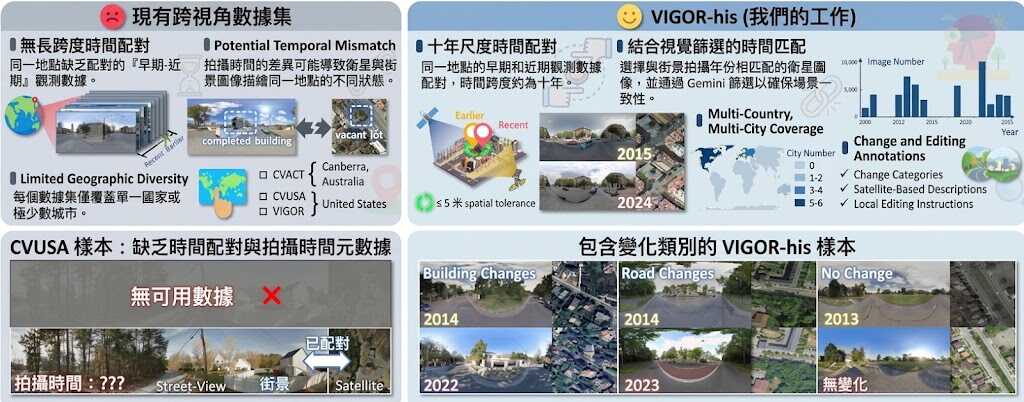
核心資料集 VIGOR-his 收錄來自三大洲 11 個城市的 43,653 組位置級四元組,配對早期與近期街景、衛星影像,並加入變化分類、衛星變化描述及局部編輯指令。模型以近期街景固定視角和場景內容,再把不同時期的衛星差異當成變化證據,較單純依賴文字提示的生成方式更適合處理具地理關聯的重建工作。

CrossTimeEdit 以 FLUX.2 [Klein] 4B 為起點,先進行 Supervised Fine-Tuning (SFT),再以 Online Reinforcement Learning (RL) 優化。訓練獎勵同時考慮 Instruction Alignment (IA)、Background Preservation (BP) 及 Quality and Physical Plausibility (QP),並透過 Flow-GRPO 與 GDPO 在不同獎勵維度之間作平衡,減少只追求畫面逼真而破壞場景一致性的取捨。

  • VIGOR-his 提供約十年跨度的跨視角城市資料
  • 模型同時保留未變背景及重建指定變化
  • 評估涵蓋指令符合度、背景保留和物理合理性
  • 整體三項編輯指標較預訓練基線提升 17.12%
  • 相比跨視角生成模型,在場景一致性、視覺真實感及感知質素上更佳

城市歷史研究、地理資訊分析、舊城改建記錄和地圖內容補全都可能受益於這套方法,但生成結果仍屬推算,不能取代真實歷史影像。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Stable Diffusion, Image, 庫, LoRA, 強化學習

InstantFusion 讓不同影像模型接力生成

InstantFusion 把不同 diffusion models 接到共同 latent space,令模型可以中途交接、加速生成,亦能混合不同偏好。

InstantFusion — A Shared Latent Interface for Image Generators

當一張圖的生成工作需要在 Qwen-Image、FLUX.1 或 SD3 之間切換,InstantFusion 讓去噪軌跡可以在中途交接。這個開源研究項目屬於影像模型工具,處理的是不同 diffusion models latent space 不相容,難以直接接續生成的問題。

核心是 Latent Alignment Encoder(LAE):模型專屬的 encoder 和 decoder 先把各自 latent 映射到 shared latent space,再以重建、cross-reconstruction、latent alignment 及 denoising-velocity alignment loss 保留圖像資訊和去噪動態。模型本身維持 frozen,LAE 負責建立彼此之間的轉換接口。

完成對齊後,生成軌跡可以交由另一個模型繼續處理,帶來三種用途:
– 不同步數預算的模型接力,嘗試縮短生成時間
– 結合針對不同偏好優化的模型
– 在 shared latent space 進行 cross-model OPD,以模型 A 的 velocity field v 蒸餾模型 B

LAE 重建測試涵蓋 Qwen-Image、FLUX.1 和 SD3,並以 100 張圖片計算 mean SSIM;介面驗證亦顯示,單次 latent round trip 能保留較高 fidelity,但反覆轉換會累積 reconstruction error。這意味着模型接力有實用價值,但不適合無限制地來回切換。

儲存庫包括 LAE training、OPD training 和 LAE-based model handoff inference,適合研究 heterogeneous image generators、模型融合或生成加速的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 上海人工智慧實驗室, 模型, 模型訓練, Qwen, Stable Diffusion, Image, 影像模型, 香港, 工具, 庫

ComfyUI-Omnichar:用 .char 讓角色跨模型保持一致

ComfyUI-Omnichar 把角色參考圖、描述和 LoRA 收進同一個 .char,方便在圖像與影片模型之間保持人物連貫。

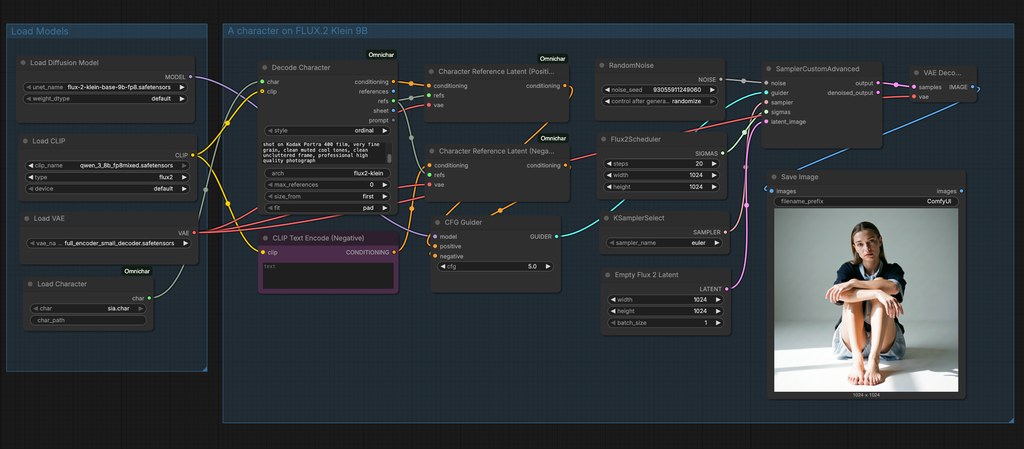
Omnichar nodes in a ComfyUI graph

同一角色要跨圖像與影片模型維持相同面孔、服裝和身形,ComfyUI-Omnichar 以可攜式 .char 檔案處理這個問題。它屬於 ComfyUI 自訂節點工具,讓角色資料不必隨每個工作流程重新整理。

.char 可保存參考圖、鎖定描述,以及可選的訓練 LoRA;檔案可以由 Omnichar Studio、Omnichar Cloud 或 Encode Character 建立,再交給 FLUX.2、MiniMax H3、Krea2、klein9B 及 klein4B 使用。相較於每次手動接入參考圖,這種方式把角色資料、圖片順序和提示詞編號固定下來,代價是工作流程需要配合支援 references 的模型。

  • 透過 Load Character 讀取 .char 檔案
  • Encode Character 可分別加入 face、body 和 cloths 參考圖
  • Decode Character 可輸出 conditioning、references 和 prompt
  • 角色附有 LoRA 時,可同時套用至 MODEL 和 CLIP

安裝需要 ComfyUI、Python 3.10+ 和 omnichar-sdk;.char 檔案放入 ComfyUI/models/characters/ 後,便可由載入節點選取。需要共用 Omnichar Studio 資料夾時,也可設定 INLINE_CHARACTERS_DIR,讓兩邊讀取同一批角色檔案。

生成結果仍會受所選模型、參考圖質素和 GPU 資源影響。對需要製作連續角色插畫、分鏡、短片或多模型內容的創作者,.char 的集中管理會比散落在不同 workflow 的參考圖更容易維護;偏好完全手動控制的人,則未必需要加入這層封裝。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, Stable Diffusion, API, Video, Image, 提示詞, 工具, Content Creator, Python, MiniMax, LoRA

ComfyUI 眼睛方向 LoRA:用紅點指定角色視線

呢個 LoRA 透過畫面上嘅紅點控制眼睛睇邊度,無論寫實、動漫定 CG 角色都適用。

喺生成角色圖像嘅時候,好多人會發現想控制眼睛視線方向係一件好頭痛嘅事:用 prompt 寫「望鏡頭」或「望向左邊」往往效果不穩定。Eric Venti Seeds 推出嘅 Eyes Direction LoRA,以 black-forest-labs/FLUX.2-klein-9B 作為基礎模型,提供咗一個更直接嘅操作方式——只要喺畫面擺放一個紅點,眼睛就會自動望過去。

呢個 LoRA 嘅運作邏輯係參考圖像入面紅點嘅位置嚟決定瞳孔方向。紅點放喺正中間,雙眼就會望鏡頭,無視身體姿勢;紅點貼近畫面邊緣,視線就會偏向畫框外面。訓練時已包含人眼活動嘅物理極限,所以當紅點放喺「唔可能」嘅位置時,模型會將瞳孔隨機處理。LoRA 採用 MIT 授權,總檔案大小約 258 MB。

為了方便擺放紅點,作者額外開發咗 ComfyUI 專用嘅 Eyes Direction Control node,可以直接拖動紅點預覽效果。如果唔用 node,手動用 Photoshop 整張紅點圖都得。LoRA 同時保留咗原本瞳孔形狀同虹膜顏色,所以風格唔會走樣。

重點摘要

  • 基礎模型:black-forest-labs/FLUX.2-klein-9B
  • 控制方式:以畫面紅點位置決定眼睛視線方向
  • 相容風格:寫實、動漫、CG、漫畫、油畫都適用
  • 配套工具:ComfyUI Eyes Direction Control node,可手動拖動紅點
  • 已知限制:動物眼睛效果差,極端頭部角度或異色瞳情況處理唔穩定

項目主頁 · 模型

Categories: 開源, ComfyUI, 模型, Stable Diffusion, Image

S2R 用物理模擬解決影片反光

隔住玻璃拍片常見嘅反光,會令畫面難睇又影響後續辨識。S2R 把合成、去反光同評測串成一條流程,重點是先補足可信訓練資料。

Og image

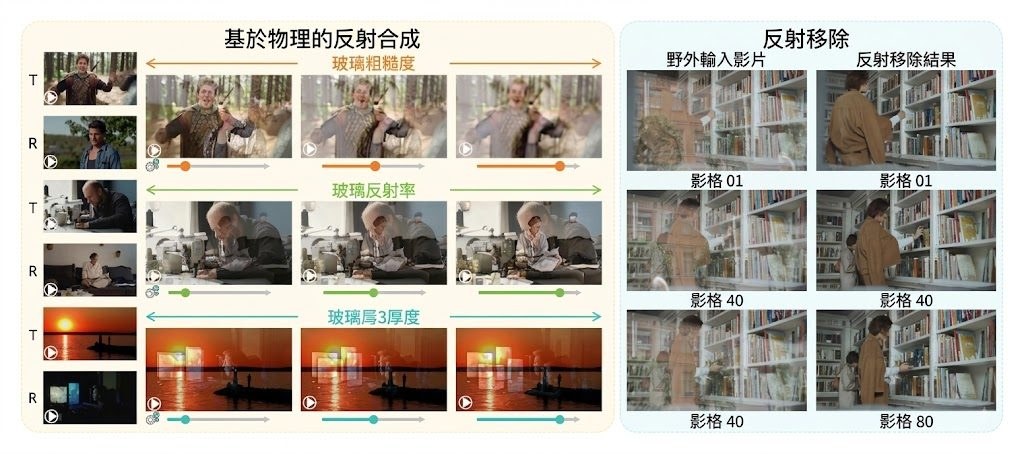
隔住玻璃拍攝時,反光往往唔只影響觀感,仲會干擾偵測、辨識同追蹤等後續視覺工作。S2R 屬於影片去反光項目,重點唔係單靠清理單幀畫面,而是同時處理資料不足、時間連貫性同評測基準缺位三個卡位。

呢個項目用一個閉環流程連接 S2R-Synthesis、S2R-Removal 同 S2R-Benchmark。前段先以 Physics-Grounded Augmentation 與影片擴散生成方法合成成對影片,控制玻璃粗糙度、反射率、厚度等性質;後段再把 pretrained video diffusion prior 調整成適合去反光的模型,加入 reflection-aware latent adaptation 同 one-step pixel-geometric refinement,減少殘影並維持時序一致。

它跟常見做法最大分別,在於先把反光結構同外觀拆開處理。S2R-Synthesis 會從 FLUX-generated pseudo videos 學習較真實的反光外觀,再把兩段乾淨影片經 Physics-Grounded Augmentation 融合,生成可配對訓練資料,避免只靠傳統合成或少量真實資料,令模型較難學到穩定的影片反光模式。

  • 用物理約束方式合成反光影片,補足 paired video data 不足
  • 以 diffusion-based video dereflection 處理影片,強調跨幀一致性
  • 提供 S2R-Benchmark,兼顧 full-reference 評估同真實場景人類感知評估
  • 在 OpenRR-1k 的結果中,加入完整 PGA 後,PSNR 與 SSIM 都比基線再提升

現有資料顯示,S2R 特別適合需要穿玻璃拍攝的內容整理、監控視覺流程,或者任何重視畫面可讀性與後續分析品質的工作流。項目亦反映一個明確取捨:先花力氣建立可信的反光合成與評測系統,再用 diffusion-based 方法做移除,換來較完整的訓練閉環,但最終表現仍會受真實場景複雜反射型態影響。

項目主頁

Categories: Stable Diffusion, Video, Image, 框架, Dataset 數據集, 小米-Xiaomi

Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

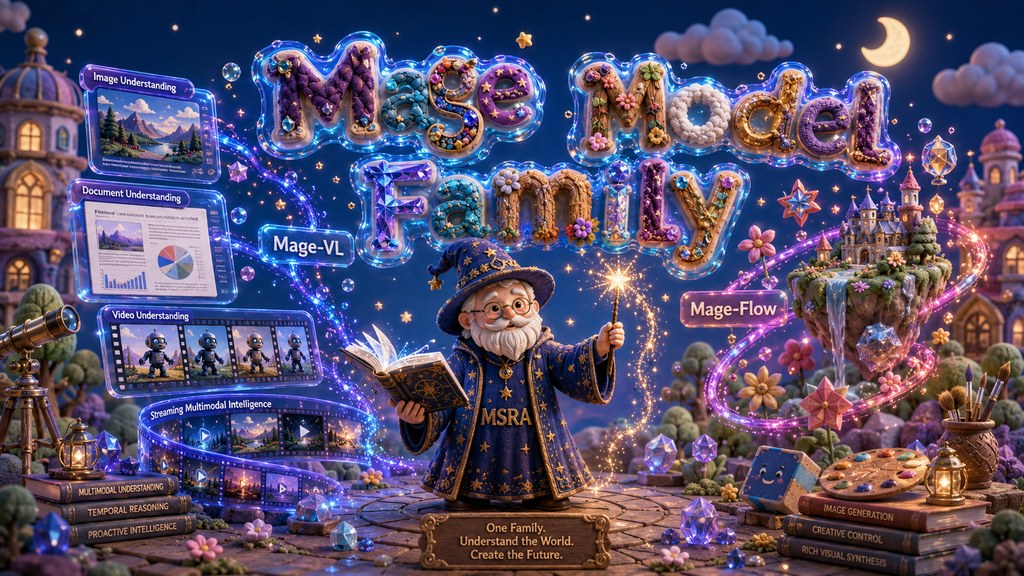
當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

Page 1 of 4
1 2 3 4