TRIBE v2 (Meta) 全腦神經活動資訊

TRIBE v2(Trimodal Brain Encoder)是一個多模態基礎模型,用於輸入一段影片、音訊或文字,然後輸出一個對應的「全腦神經活動圖」(約 7 萬個體素的 fMRI‑style 活動預測)。它在 Algonauts 2025 獲獎架構上進一步提升,準確度約是上一代 2–3 倍,空間解析度提高約 70 倍,並支援跨受試者、跨語言、跨任務的 zero‑shot 預測。 可以當成一個「神經科學可視化工具」,用來研究。例如內容設計(影片、廣告、UI)如何觸發大腦特定區域(視覺皮層、語言區等)。又或者多模態 embedding 是否真的對齊人類大腦的處理路徑。 若你在做 RAG、多模態搜尋或 Brain‑AI 類實驗,可以拿這個 demo 來:比較不同 prompt/多模態輸入對「腦激活圖」的差異(例如:同一段文字用不同語氣、圖片風格重製)。

TRIBE v2(Trimodal Brain Encoder)是一個多模態基礎模型,用於輸入一段影片、音訊或文字,然後輸出一個對應的「全腦神經活動圖」(約 7 萬個體素的 fMRI‑style 活動預測)。
它在 Algonauts 2025 獲獎架構上進一步提升,準確度約是上一代 2–3 倍,空間解析度提高約 70 倍,並支援跨受試者、跨語言、跨任務的 zero‑shot 預測。

可以當成一個「神經科學可視化工具」,用來研究。例如內容設計(影片、廣告、UI)如何觸發大腦特定區域(視覺皮層、語言區等)。又或者多模態 embedding 是否真的對齊人類大腦的處理路徑。

若你在做 RAG、多模態搜尋或 Brain‑AI 類實驗,可以拿這個 demo 來:比較不同 prompt/多模態輸入對「腦激活圖」的差異(例如:同一段文字用不同語氣、圖片風格重製)。

Categories: 開源, 視覺模型, Medical醫學, Meta

PrismAudio 視訊立體聲模型框架

PrismAudio 是一套影片生音訊框架,把強化學習帶進 V2A 任業,並以 Chain-of-Thought 拆開語意、時間、美感、空間四個目標,讓生成結果更貼合人類偏好。
以往 Video-to-Audio(V2A)模型總要在語意對不對、聲畫同步、音色好唔好聽、空間定位準唔準四個指標之間拉鋸,往往一個 loss function 包起晒,結果邊樣都做唔好。PrismAudio 想處理嘅就係呢個「目標纏結」問題。

佢最特別嘅做法係把生成過程拆成四個專門嘅 Chain-of-Thought 模組,分別對應語意、時間、美感、空間,每個模組配對一組針對性嘅 reward function,再用 RL 聯合優化。換句話講,模型唔再係靠單一總分亂試,而係四個維度各自有指引。

訓練成本係 RL 常見痛點。PrismAudio 提出 Fast-GRPO,用 ODE 同 SDE 混合採樣,比起一般 GRPO 實現大幅減低開銷,令多維度 RL 訓練變得貼地。

團隊亦同步推出 AudioCanvas 基準,包含 300 個單事件類別同 501 個多事件樣本,比現有數據集更貼近真實多樣場景。喺 VGGSound 同 AudioCanvas 上,PrismAudio 都拎到四個感知維度嘅 SOTA。

配搭 Sora 2、Veo 3 等頂級影片生成模型時,PrismAudio 可以補上立體聲音軌,令短片多一層沉浸感。對做 AI 影片、數字人、內容創作嘅人來說,多咗一件可以直接嵌入成片流程嘅音訊工具。

重點摘要

  • 首次把強化學習引入 V2A 生成流程。
  • 四個 Chain-of-Thought 模組對應語意、時間、美感、空間 reward,拆解目標纏結。
  • Fast-GRPO 以 ODE-SDE 混合採樣降低 RL 訓練成本。
  • 自建 AudioCanvas 基準涵蓋更多真實多事件場景。
  • 喺 VGGSound 同 AudioCanvas 上四個感知維度都達到 SOTA,並可配合頂級影片模型輸出立體聲。
  • 語義合理性(Semantic)
  • 音視同步性(Temporal synchrony)
  • 音質美感(Aesthetic quality)
  • 空間準確度(Spatial accuracy)

作者的關鍵點是:現有模型通常把這些目標混在一個損失函數裡,會造成「目標互相干擾」(objective entanglement),而 PrismAudio 用 分解式 Chain‑of‑Thought(CoT)推理+多維度強化學習(RL) 來避免這個問題。

項目主頁
Categories: 開源, 視覺模型, 聲效

Matrix-Game 3.0 記憶增強世界模型

Matrix‑Game 3.0 是一個基於 Diffusion Transformer(DiT)的記憶增強世界模型,目標是做 720p 解析度、可達 40 FPS 的實時長序列互動視訊生成,用於第一人稱、第三人稱等遊戲/虛擬世界場景。它能根據滑鼠+鍵盤輸入一邊生成新畫面,一邊維持場景長時間的一致性(例如分鐘級序列),並可擴展到 2×14B 甚至 28B MoE 規模。 三大技術層面

Matrix‑Game 3.0 是一個基於 Diffusion Transformer(DiT)的記憶增強世界模型,目標是做 720p 解析度、可達 40 FPS 的實時長序列互動視訊生成,用於第一人稱、第三人稱等遊戲/虛擬世界場景。它能根據滑鼠+鍵盤輸入一邊生成新畫面,一邊維持場景長時間的一致性(例如分鐘級序列),並可擴展到 2×14B 甚至 28B MoE 規模。

三大技術層面

  1. Data Engine
    • 用 Unreal Engine 生成合成資料,加上對 AAA 遊戲的大規模自動錄製、與真實影片資料增強,產出高品質的 Video–Pose–Action–Prompt 四元資料
    • 這種「工業級無限資料機器」讓模型能學習大量互動式行為與視角變化。
  2. 記憶增強模型(Memory‑augmented DiT)
    • 基礎模型是一個統一的雙向 DiT,把過去的潛在畫面、當前加噪畫面與動作輸入(滑鼠/鍵盤)放在同一個架構裡。
    • 用 residual error buffer 收集預測殘差,再以「error injection」把誤差加回訓練,讓模型學會在長時間序列上自我修正,增強長時一致性。
    • 加入 camera‑aware memory retrieval,只撿選視角相關的歷史畫面作為記憶條件,用 Plücker 編碼處理幾何關係,並用一個「sink latent」(第一幀)錨定場景整體風格。
  3. 高效實時推論(Distillation + Quantization)
    • 採用多段式的自生成 few‑step distillation(基於 Distribution Matching Distillation),讓「學生模型」在訓練時就模擬實際的少量步數 autoregressive 推論流程,做到訓練與推論對齊。
    • 搭配 INT8 量化、輕量化 VAE 解碼器(MG‑LightVAE)以及 GPU 加速的記憶檢索,單個 5B 模型可在 8 張 GPU 上達到 720p @ 40 FPS,而 2×14B 模型則在更長時間和更複雜場景下表現更好。
Categories: 開源, 視頻模型, 影像模型

RealRestorer – 通用真實世界影像復原

RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。

RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。

Categories: 開源, 影像模型, 影像處理

daVinci‑MagiHuman 單流數字人

daVinci‑MagiHuman 是一個 15B 參數、專注數字人(human‑centric)的文本到視頻生成模型,同時支援視頻與音頻 token 的聯合生成,主打「人類主體」表現力。daVinci‑MagiHuman 由 SII‑GAIR Lab(中國上海人工智慧實驗室 SII‑GAIR)與 Sand.ai 這兩方聯合開發

daVinci‑MagiHuman 是一個 15B 參數、專注數字人(human‑centric)的文本到視頻生成模型,同時支援視頻與音頻 token 的聯合生成,主打「人類主體」表現力。daVinci‑MagiHuman 由 SII‑GAIR Lab(中國上海人工智慧實驗室 SII‑GAIR)與 Sand.ai 這兩方聯合開發

  • 單流 Transformer — 一個統一的 150 億參數、40 層的 Transformer,僅透過自註意力機制即可聯合處理文字、視訊和音訊。無需交叉注意力,也無需多流處理。
  • 🎭卓越的以人為本的品質— 富有表現力的面部表情、自然的語音表達協調、逼真的身體動作以及準確的音視頻同步。
  • 🌍多語言— 支援中文(國語和粵語)、英語、日語、韓語、德語和法語。
  • 超快推理-在單一 H100 GPU 上,可在2 秒內產生 5 秒 256p 視頻,在38 秒內產生5 秒 1080p 影片。
  • 🏆最先進的結果—在超過 2,000 次的成對人工評估中,與 Ovi 1.1 的勝率達到80.0% ,與 LTX 2.3 的勝率達到60.9% 。
  • 📦完全開源— 我們發布完整的模型堆疊:基礎模型、精煉模型、超解析度模型和推理程式碼。
Categories: 開源, 數字人, 模型, 視頻模型

Helios – 實時生成分鐘級長視頻

Helios 是一個 140 億參數(14B)自回歸擴散模型(autoregressive diffusion model),設計成可以在 單張 NVIDIA H100 GPU 上以約 19.5 FPS 實時生成分鐘級長視頻。它原生支援 Text‑to‑Video(T2V)、Image‑to‑Video(I2V)和 Video‑to‑Video(V2V) 三種任務,並有一個統一的輸入表示。 在維持 14B 規模的前提下,不使用 KV‑cache、稀疏/線性注意力、量化等常見加速技術,單卡就能跑到 19.5 FPS。

Helios 是一個 140 億參數(14B)自回歸擴散模型(autoregressive diffusion model),設計成可以在 單張 NVIDIA H100 GPU 上以約 19.5 FPS 實時生成分鐘級長視頻。它原生支援 Text‑to‑Video(T2V)、Image‑to‑Video(I2V)和 Video‑to‑Video(V2V) 三種任務,並有一個統一的輸入表示。

在維持 14B 規模的前提下,不使用 KV‑cache、稀疏/線性注意力、量化等常見加速技術,單卡就能跑到 19.5 FPS。

  • Helios‑Base(高質量)
  • Helios‑Mid(中間 checkpoint)
  • Helios‑Distilled(極端高效、對消費卡更友好),有 YouTuber 甚至在 RTX 4090 級別上跑 33 幀每段、分鐘級長視頻。
Helios - A 14B ByteDance Real-Time Long Video Generation Model Run Locally.

Categories: 開源, 字節跳動, 視頻模型

Utonia – Point Cloud 的單一編碼器

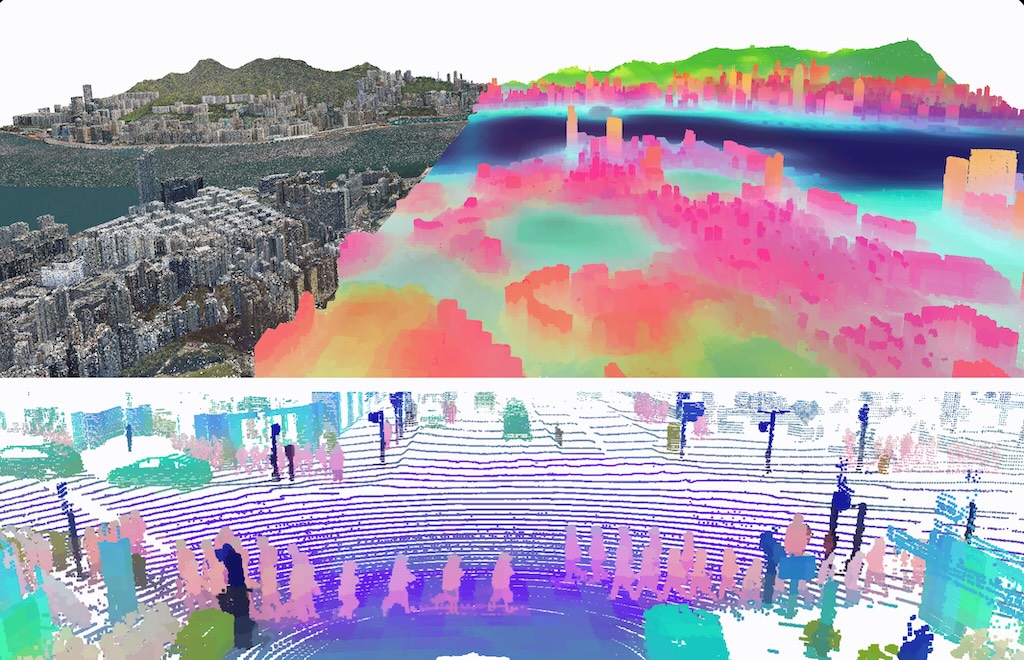
Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。 Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。 跨域資料混合:研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。

Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。

跨域資料混合
研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Categories: 開源, 香港中文大學, 影像模型, 影像處理

shadcn-admin 把後台介面做成可重用基底

想快速砌出像樣的管理後台,shadcn-admin 提供的是一套可直接改造的 UI 基底。它重點唔係生成功能,而係先幫你處理版面、互動同可讀性。

alt text

做管理後台最花時間的,往往唔係業務邏輯,而係側邊欄、搜尋、深色模式同手機版排版呢類反覆出現的介面細節。shadcn-admin 屬於後台 UI 項目,用 ShadcnUI、Vite 同 TanStack Router 組成一套可重用的 dashboard 介面集合,目的係幫團隊快啲整理出一致、可維護的管理界面。

呢個項目最有價值的地方,在於它刻意唔包裝成 starter template。你拎到手的是一套已經鋪好結構的介面樣板與元件組合,包括 sidebar、global search command、10+ pages、light/dark mode、responsive 同 accessible 設計,適合拿來拆件、重組,再接上自己嘅資料流、權限同 API。

它同一般只展示幾個畫面嘅 UI showcase 有分別,因為 README 已經講清楚部分元件為咗 RTL support 做過修改,唔建議無腦用 Shadcn CLI 覆蓋更新。換句話說,呢個項目換來的是較完整的多語系版面照顧同現成後台骨架,但代價係後續升級某些元件時,要自己處理 merge,唔係純粹一路跟官方元件版本推進。

  • 建基於 ShadcnUI、TailwindCSS、RadixUI,同時配合 Vite 與 TypeScript
  • 內建 sidebar、全域搜尋指令、10+ 頁面,適合用作內部系統或 SaaS 後台雛形
  • 針對 RTL support 改過多個元件,對雙向語言介面更友善
  • Clerk 只屬 partial auth 整合,身份驗證仍需要按自己項目補完

部署同理解方式都算直接:安裝依賴後以 Vite 本地跑起介面,再按 src/components/ui/ 同路由頁面逐步替換成自己嘅資料與流程。它唔提供完整產品功能,也冇聲稱性能 benchmark;重點係把一個後台最難維持一致性的 UI 層先整理好,對經常做內部工具、SaaS 管理台、內容營運面板的前端團隊尤其實用。

GitHub

Categories: 開源, API, UI/UX


Page 71 of 90
1 69 70 71 72 73 90