DeepSeek NSA 原生稀疏注意力

2025 年 2 月 16 日,DeepSeek 提出了一種名為「原生稀疏注意力」(NSA)Natively trainable Sparse Attention 的新型注意力機制,目的是解決長傳統注意力機制運算量過大的問題。NSA 透過結合分層式 Token 壓縮與硬體加速設計,達成既能有效處理長文本,又不會顯著增加運算負擔的目標。其核心創新點在於演算法與硬體協同優化,保持甚至超越完整注意力模型的性能。實驗證明,NSA 在多項基準測試中表現出色,並且在解碼、前向傳播和反向傳播階段都顯著加速。
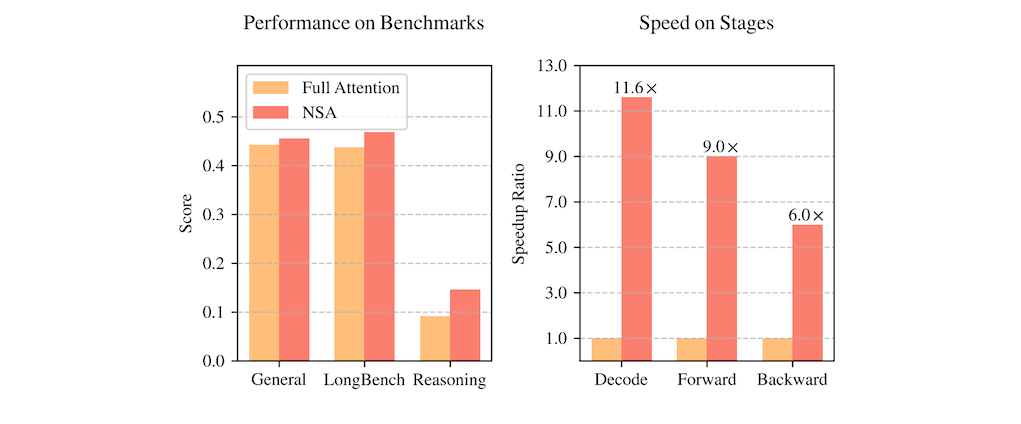
2025 年 2 月 16 日,DeepSeek 提出了一種名為「原生稀疏注意力」(NSA)
Natively trainable Sparse Attention 的新型注意力機制,目的是解決長傳統注意力機制運算量過大的問題。NSA 透過結合分層式 Token 壓縮與硬體加速設計,達成既能有效處理長文本,又不會顯著增加運算負擔的目標。其核心創新點在於演算法與硬體協同優化,保持甚至超越完整注意力模型的性能。實驗證明,NSA 在多項基準測試中表現出色,並且在解碼、前向傳播和反向傳播階段都顯著加速。

【人工智能】DeepSeek再发新研究成果NSA | 原生稀疏注意力机制 | 梁文锋参与 | 超快长上下文训练 | 十倍速度提升 | 动态分层 | 粗粒度压缩 | 细粒度选择 | 滑动窗口
Categories: 推理引擎, 新聞

VideoLLaMA3 影片理解模型

一個以視覺為中心的多模態基礎模型,用於圖像和影片理解。其核心設計理念是優先利用高品質的圖像文字數據,而非大規模的影片文字數據進行訓練。模型採用四階段訓練流程:視覺對齊、視覺語言預訓練、多任務微調以及影片中心微調。此外,VideoLLaMA3 的架構設計能根據影像大小動態調整視覺 token 數量,並在影片處理中減少冗餘的視覺 token,以提升效率和準確性。最終,VideoLLaMA3 在圖像和影片理解基準測試中取得了令人信服的成果。(HuggingFace)

一個以視覺為中心的多模態基礎模型,用於圖像和影片理解。其核心設計理念是優先利用高品質的圖像文字數據,而非大規模的影片文字數據進行訓練。模型採用四階段訓練流程:視覺對齊、視覺語言預訓練、多任務微調以及影片中心微調。此外,VideoLLaMA3 的架構設計能根據影像大小動態調整視覺 token 數量,並在影片處理中減少冗餘的視覺 token,以提升效率和準確性。最終,VideoLLaMA3 在圖像和影片理解基準測試中取得了令人信服的成果。(HuggingFace)

Categories: 開源, 模型, 多模態模型, 影像處理, 推理引擎

Google 正在模擬整個物理世界

谷歌最近的人工智慧計畫是模擬整個物理世界的系統,谷歌認為這是通往通用人工智慧的關鍵路徑,以及它如何與谷歌更廣泛的人工智慧策略相連,這當然包括 Gemini。  這是 Google DeepMind 一項突破性的 AI 計畫:建構模擬整個物理世界的系統,以朝向通用人工智能 (AGI) 邁進。該系統整合了多模態數據 (例如影片、音訊和機器人數據),用以模擬真實世界的物理規律,並將應用於機器人、遊戲和科學研究等領域。 這項計畫展現 Google 擴展 AI 模型以達到前所未有的智能和真實感的雄心壯志,並預期將對各產業帶來革命性的影響,加速 AGI 的實現。

谷歌最近的人工智慧計畫是模擬整個物理世界的系統,谷歌認為這是通往通用人工智慧的關鍵路徑,以及它如何與谷歌更廣泛的人工智慧策略相連,這當然包括 Gemini。

 這是 Google DeepMind 一項突破性的 AI 計畫:建構模擬整個物理世界的系統,以朝向通用人工智能 (AGI) 邁進。該系統整合了多模態數據 (例如影片、音訊和機器人數據),用以模擬真實世界的物理規律,並將應用於機器人、遊戲和科學研究等領域。 這項計畫展現 Google 擴展 AI 模型以達到前所未有的智能和真實感的雄心壯志,並預期將對各產業帶來革命性的影響,加速 AGI 的實現。

Google’s New AI Is Recreating the Whole World to Unlock Superhuman Intelligence
Categories: 多模態模型, 3D, 推理引擎, 新聞

Speculative Decoding 推理解碼技術

大幅提升大型語言模型 (LLM) 的推理速度 Cerebras 和 Groq 等公司利用此技術,在 Llama 模型上取得遠超傳統 GPU 的效能表現,速度提升達數倍。文章詳細解釋了如何取巧進行推理解碼的原理:使用較小的模型快速生成初步答案,再由較大的模型校驗其準確性,類似「助理先打草稿,老闆再審核」的流程。文章後半部提供了使用 Llama.cpp 實作推測解碼的步驟,並說明了其各個參數的意義,以及在實際應用中可能遇到的挑戰,例如偶爾出現的延遲問題,但整體而言,推測解碼能有效提升 LLM 的效能,尤其適用於需要大量運算的應用情境,例如結合思考鏈 (CoT) 的複雜任務。

大幅提升大型語言模型 (LLM) 的推理速度

Cerebras 和 Groq 等公司利用此技術,在 Llama 模型上取得遠超傳統 GPU 的效能表現,速度提升達數倍。文章詳細解釋了如何取巧進行推理解碼的原理:使用較小的模型快速生成初步答案,再由較大的模型校驗其準確性,類似「助理先打草稿,老闆再審核」的流程。文章後半部提供了使用 Llama.cpp 實作推測解碼的步驟,並說明了其各個參數的意義,以及在實際應用中可能遇到的挑戰,例如偶爾出現的延遲問題,但整體而言,推測解碼能有效提升 LLM 的效能,尤其適用於需要大量運算的應用情境,例如結合思考鏈 (CoT) 的複雜任務。

Categories: 推理引擎

mistral.rs 高速推理引擎

高效能語言模型推論引擎 它以 Rust 編寫,支援多種模型、量化方法 (GGML, GPTQ, HQQ 等) 和加速器 (CUDA, Metal, CPU),並提供 便捷的 Python API 和 OpenAI 相容的 HTTP 伺服器。 核心功能包括 快速推論、多種量化技術 以提升效能,以及對 LoRA、X-LoRA 等模型調整技術的支援。 附詳細說明安裝、建置、模型取得和使用方法,並提供豐富的範例程式碼與效能基准測試結果。(支援 Mac M 系列)

高效能語言模型推論引擎

它以 Rust 編寫,支援多種模型、量化方法 (GGML, GPTQ, HQQ 等) 和加速器 (CUDA, Metal, CPU),並提供 便捷的 Python API 和 OpenAI 相容的 HTTP 伺服器。 核心功能包括 快速推論、多種量化技術 以提升效能,以及對 LoRA、X-LoRA 等模型調整技術的支援。 附詳細說明安裝、建置、模型取得和使用方法,並提供豐富的範例程式碼與效能基准測試結果。(支援 Mac M 系列)

MAC ImageWIN Image

Categories: 開源, 推理引擎

Page 2 of 2
1 2