KATok 教影片 VAE 自己丟 Token 減運算量

Kakao 開源 KATok,一個會根據內容自動決定保留多少 token 的影片 VAE,靜態畫面用得少,動態場景留得多,省下的算力直接交給下游擴散模型。

Repository image for kakao/KATok

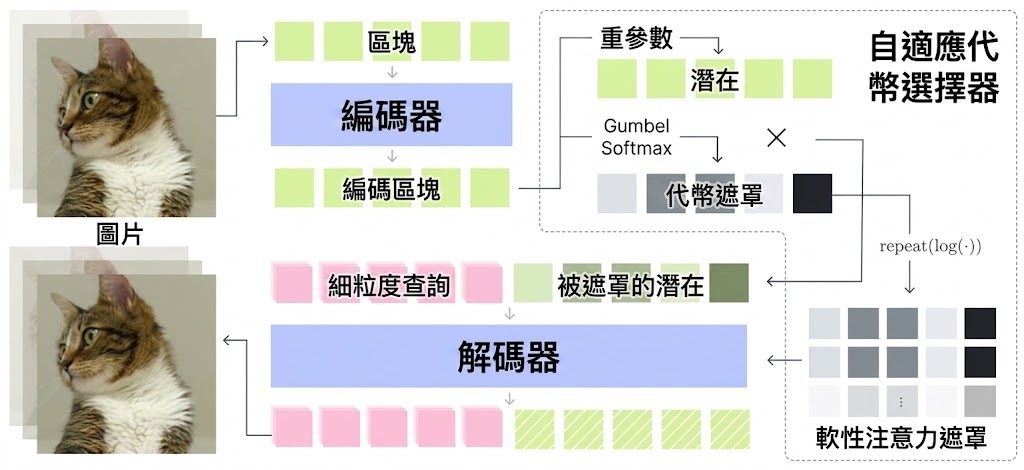
KATok 處理嘅係影片生成入面一個常見但少有人拆開嚟解決嘅問題:傳統影片 VAE 用固定壓縮比,無論係一張幾乎唔郁嘅定鏡,或者主體快速移動嘅場面,每段都會被切成同一個 token 數。呢種做法喺靜態片段上明顯浪費頻寬,令擴散模型要做好多無意義嘅工作。

佢嘅做法係喺 transformer VAE 嘅 latent bottleneck 加一個可學習嘅 keep-or-drop 決策,對每個 token 估計要唔要保留,仲會一齊學 latent 表示。遮罩同時控制 latent 值同 decoder 嘅注意力,decoder 用 coarse-to-fine 結構由稀疏 token 重建細節,因此 token 數變成內容嘅結果,而唔係預設參數,亦唔需要推理時搜索。

喺 Panda-70M 256²×16 設定下,平均 366 個 token 就可以達到 31.24 PSNR 同 5.12 rFVD;喺 UCF-101 嘅稀疏生成實驗中達到 61.53 gFVD,比 dense transformer tokenizer 訓練快 6.9 倍。代價係當 token 被丟棄後空間佈局會被打亂,所以佢哋仲設計咗 cascaded mask prior 同 joint content–position 變體,幫下游擴散模型補返結構。

值得留意嘅重點:

  • 自適應 token 化,內容決定 token 數,無需推理時搜索或人手調參
  • 喺 Panda-70M 用 366 個 token 達到 31.24 PSNR / 5.12 rFVD
  • UCF-101 稀疏生成快 6.9 倍訓練速度,質素達 61.53 gFVD
  • 提供 inference code 同權重(仍在內部審核),訓練碼暫未開源
  • 直接用 PyTorch SDPA 即可行,安裝簡單

如果你嘅團隊需要處理大量冗餘嘅影片片段,又想慳運算量畀下游生成模型,呢種由內容決定 token 數嘅做法比起單純壓解像度更貼近問題本質。

項目主頁 · GitHub

Categories: 開源, Image, 推理引擎

OasisKV 把 LLM KV Cache 帶出 HBM 瓶頸

HBM 容量已成為一種稀缺且昂貴的資源,嚴重限制了推理批量大小和系統吞吐量。OasisKV 以記憶體為中心進行推理,透過解碼期間將完整的 KV 快取儲存與 HBM 解耦來減輕 HBM 容量壓力。

Hugging Face

OasisKV 來自 Microsoft Research、Imperial College London、KAIST 和 University of Edinburgh。是建基於 vLLM 的 LLM 推理系統設計。

長上下文及長篇推理會令 Large Language Model (LLM) 的 key-value (KV) cache 佔用大量記憶體和頻寬,High Bandwidth Memory (HBM) 容量遂成為批次大小與吞吐量的限制。OasisKV 不再把完整 KV cache 全部放在 HBM,而是在解碼階段只保留注意力較高的 KV 項目,其他資料存放於主機或遠端記憶體。

系統利用 speculative decoding (SD) 產生的 lookahead tokens,預測下一步可能重要的 KV blocks,再透過背景 attention pipeline 預先載入 HBM。論文報告指,在 2,048-token KV 預算下,準確度只比 full attention 低最多 0.7 分,推理工作負載吞吐量可達 dense vLLM 的 1.69 倍,多 GPU 長上下文服務最高達 2.1 倍。

  • 預取稀疏 KV,降低 HBM 容量壓力
  • 支援 host 或 remote memory 作較大容量層級
  • prefill–decode disaggregation 下吞吐量約為 dense 方法 2 倍
  • 每個請求所需 KV 可減少 6.5 至 9.7 倍
  • decode node host memory 可降低 2.2 至 2.6 倍

取捨在於系統依賴 lookahead 預測及稀疏 attention;預測失準可能影響準確度,且跨記憶體層級預取會增加系統複雜度。暫時只確認以 vLLM 實作,沒有提供 GGUF 檔案、量化版本、mmproj 附加檔案、Ollama 或 LM Studio 支援資料。

項目主頁 · Paper

Categories: 微軟, 推理引擎

Step3-VL-10B 輕量但超級視覺模型

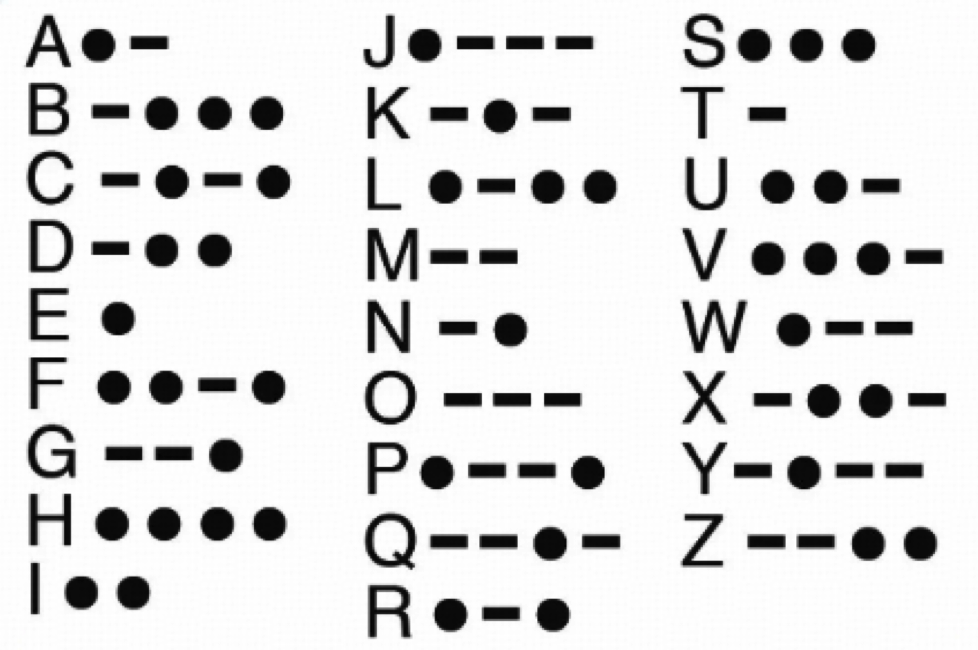
Step3-VL-10B 是一款輕量級開源基礎模型,旨在重新定義緊湊高效與前沿多模態智能之間的權衡。儘管僅有 10B 參數,Step3-VL-10B 在視覺感知、複雜推理和人類對齊方面表現卓越。 該模型在 10B 規模以下的模型中始終表現最優,並能媲美甚至超越規模大 10×–20× 的開源模型(如 GLM-4.6V 106B-A12B、Qwen3-VL-Thinking 235B-A22B)以及頂級閉源旗艦模型(如 Gemini 2.5 Pro、Seed-1.5-VL)。 Demo: 根據表格推導”STEPFUN”的莫爾斯編碼 Step3-VL-10B 的成功源於兩大核心設計:高質量多模態語料庫的統一預訓練(1.2T tokens)與規模化多模態強化學習(超過 1,400 次 RL 迭代),並引入 Parallel Coordinated Reasoning (PaCoRe) 實現並行視覺探索的證據聚合。

Step3-VL-10B 是一款輕量級開源基礎模型,旨在重新定義緊湊高效與前沿多模態智能之間的權衡。儘管僅有 10B 參數,Step3-VL-10B 在視覺感知、複雜推理和人類對齊方面表現卓越。

該模型在 10B 規模以下的模型中始終表現最優,並能媲美甚至超越規模大 10×–20× 的開源模型(如 GLM-4.6V 106B-A12B、Qwen3-VL-Thinking 235B-A22B)以及頂級閉源旗艦模型(如 Gemini 2.5 Pro、Seed-1.5-VL)。

Demo: 根據表格推導”STEPFUN”的莫爾斯編碼

Thinking Process

用户现在需要把每个字母转换成莫尔斯电码,先看每个字母在表中的编码。首先分解"STEPFUN"每个字母:S、T、E、P、F、U、N。

S:看右边第三列第一个,S是···(三个点)。(一个短横)
T:第三列第二个,T是-。
E:左边第一列第五个,E是·(一个点)。
P:中间列(J到R)中P对应的符号是·--·点、短横、短横、点)。
F:最左侧列第六行,F的符号是··-·(两个点、一个短横、一个点)。
U:最右侧列第三行,U的符号是··-(两个点、一个短横)。
N:中间列(J到R)第五行,N的符号是-·一个短横、一个点)。
再将每个字母的编码按顺序拼接(字母间用空格分隔更清晰),"STEPFUN"的莫尔斯电码为:··· - · ·--· ··-· ··- -·

Final Answer
··· - · ·--· ··-· ··- -·

Step3-VL-10B 的成功源於兩大核心設計:高質量多模態語料庫的統一預訓練(1.2T tokens)與規模化多模態強化學習(超過 1,400 次 RL 迭代),並引入 Parallel Coordinated Reasoning (PaCoRe) 實現並行視覺探索的證據聚合。

Categories: 開源, 視覺模型, 推理引擎

CoF-T2I 漸進式視覺推理模型

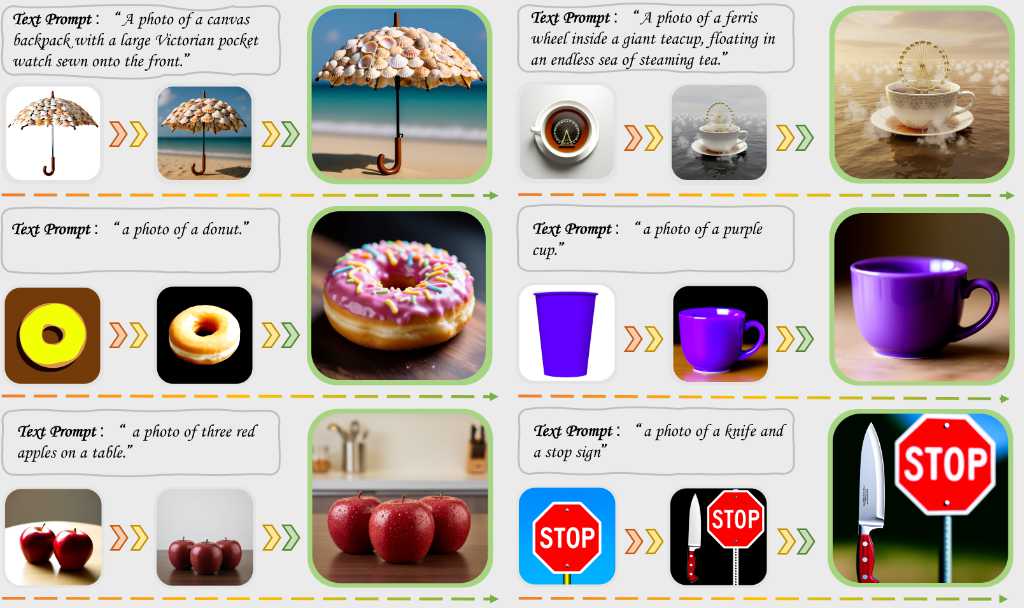
CoF-T2I 模型透過漸進式視覺細化,將 CoF 推理整合到 T2I 生成過程中,其中中間幀作為顯式推理步驟,最終幀作為輸出。為了建立這種明確生成過程,CoF-T2I 建立了CoF-Evol-Instruct 資料集,該資料集包含從語義到美學的 CoF 軌跡,用於建模生成過程。為了進一步提高品質並避免運動偽影,CoF-T2I 對每一幀都進行了獨立編碼。實驗表明,CoF-T2I 的性能顯著優於基礎視訊模型,並達到了具有競爭力的水平。

CoF-T2I 模型透過漸進式視覺細化,將 CoF 推理整合到 T2I 生成過程中,其中中間幀作為顯式推理步驟,最終幀作為輸出。為了建立這種明確生成過程,CoF-T2I 建立了CoF-Evol-Instruct 資料集,該資料集包含從語義到美學的 CoF 軌跡,用於建模生成過程。為了進一步提高品質並避免運動偽影,CoF-T2I 對每一幀都進行了獨立編碼。實驗表明,CoF-T2I 的性能顯著優於基礎視訊模型,並達到了具有競爭力的水平。

Categories: 開源, 視覺模型, 影像處理, 推理引擎

Matrix-Game 2.0 互動世界生成系統

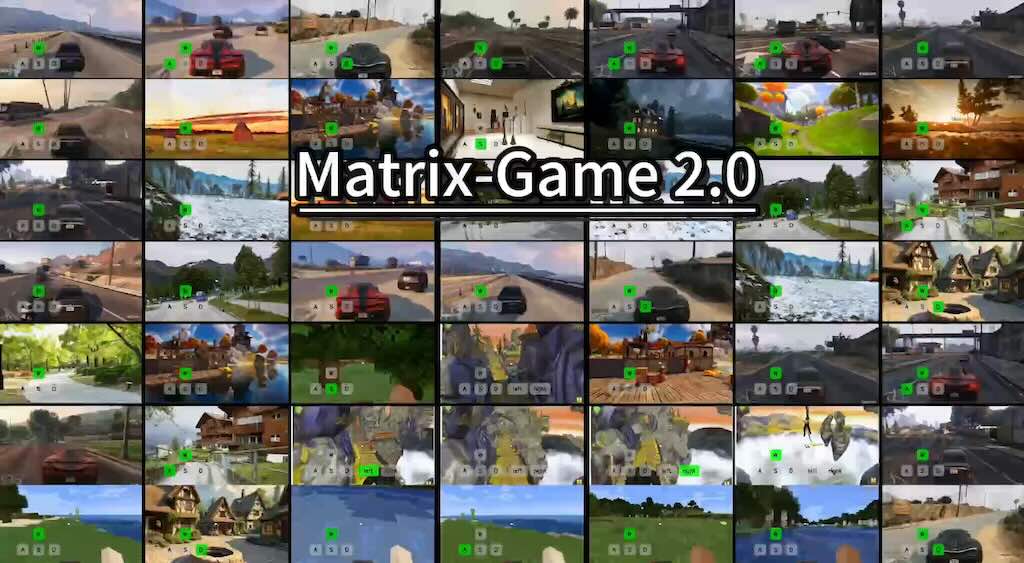
Matrix-Game 2.0 是一套高效、強大的互動世界生成系統,專注於視覺與行動融合,能夠在多種遊戲場景下生成高質量、流暢並可交互的視頻內容,領先於現有主流方案,適合用於前沿AI遊戲和虛擬世界研究。主要由Skywork AI團隊開發。

Matrix-Game 2.0 是一套高效、強大的互動世界生成系統,專注於視覺與行動融合,能夠在多種遊戲場景下生成高質量、流暢並可交互的視頻內容,領先於現有主流方案,適合用於前沿AI遊戲和虛擬世界研究。主要由Skywork AI團隊開發。

Categories: 開源, 視覺模型, 多模態模型, 影像模型, 3D, 推理引擎

OpenAI 的開放權重模型 gpt-oss 系列

GitHub - openai/gpt-oss: gpt-oss-120b and gpt-oss-20b are two open-weight language models by OpenAI 專為強大的推理、代理任務和多功能開發人員用例而設計。


Categories: 開源, Ollama, 推理引擎

VisionThink 智慧高效視覺語言模型

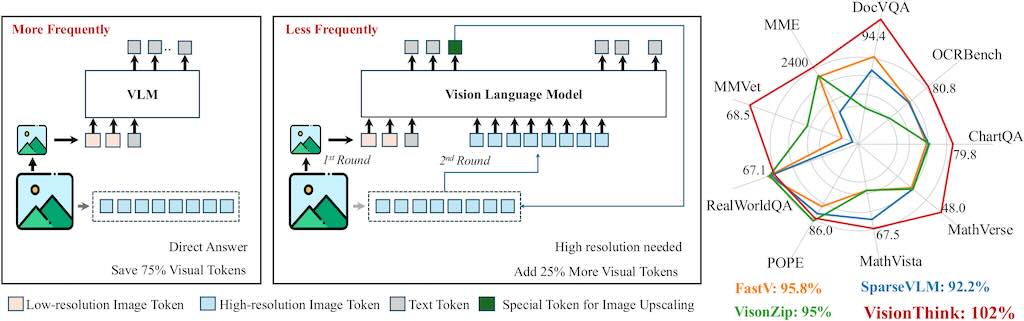
VisionThink 利用強化學習自主學習減少視覺 token。與傳統的高效 VLM 方法相比,這方法在微粒度基準測試(例如涉及 OCR 相關任務的基準測試)上取得了顯著的提升。 由香港中文大學,香港大學,科技大學大聯合開發

VisionThink 利用強化學習自主學習減少視覺 token。與傳統的高效 VLM 方法相比,這方法在
微粒度基準測試(例如涉及 OCR 相關任務的基準測試)上取得了顯著的提升。

由香港中文大學,香港大學,科技大學大聯合開發

VisionThink: Smart and Efficient Vision Language Model via Reinforcement Learning
Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 模型, 視覺模型, 推理引擎, 深度學習

NVIDIA RTX AI 加速 FLUX.1 Kontext [dev]

NVIDIA 與 Black Forest Labs 合作,使用NVIDIA TensorRT軟體開發套件和量化技術針對NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],從而以更低的 VRAM 要求提供更快的推理速度。

NVIDIA 與 Black Forest Labs 合作,使用
NVIDIA TensorRT軟體開發套件和量化技術針對
NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],
從而以更低的 VRAM 要求提供更快的推理速度。

Categories: 開源, ComfyUI, 視頻模型, 影像模型, 工具, 推理引擎

SkyReels-V2 生成無限長度影片

Skywork 是一個創新的研究團隊,致力於推動 LLM 和多模式理解。它們的使命是透過視覺和語言開發並實現無縫互動的尖端模型和資料集來突破人工智慧的界限。模型支援文字到視訊(T2V) 和圖像到視訊(I2V) 任務,並且可以在同步和非同步模式下進行推理。 影片長度限制的突破:雖然像 LTXV 和 HuanYun 等模型在速度或品質方面表現出色,但它們通常限制生成約 5 到 10 秒的短片。Frame pack 可以生成高達 60 秒的高品質影片,但 60 秒是其最大長度。Skyreels V2 透過其稱為「擴散強制 (diffusion forcing)」的技術,可以讓您生成長達 60 秒甚至可能更長的影片。技術上,擴散強制模型可以透過不斷訓練一個擴散強制取樣器並在最後組合每個結果來無限延長影片長度。

Skywork 是一個創新的研究團隊,致力於推動 LLM 和多模式理解。它們的使命是透過視覺和語言開發並實現無縫互動的尖端模型和資料集來突破人工智慧的界限。模型支援文字到視訊(T2V) 和圖像到視訊(I2V) 任務,並且可以在同步和非同步模式下進行推理。

影片長度限制的突破:雖然像 LTXV 和 HuanYun 等模型在速度或品質方面表現出色,但它們通常限制生成約 5 到 10 秒的短片。Frame pack 可以生成高達 60 秒的高品質影片,但 60 秒是其最大長度。Skyreels V2 透過其稱為「擴散強制 (diffusion forcing)」的技術,可以讓您生成長達 60 秒甚至可能更長的影片。技術上,擴散強制模型可以透過不斷訓練一個擴散強制取樣器並在最後組合每個結果來無限延長影片長度。

Categories: 開源, 多模態模型, 影像模型, 推理引擎

BFS-Prover 自動定理證明

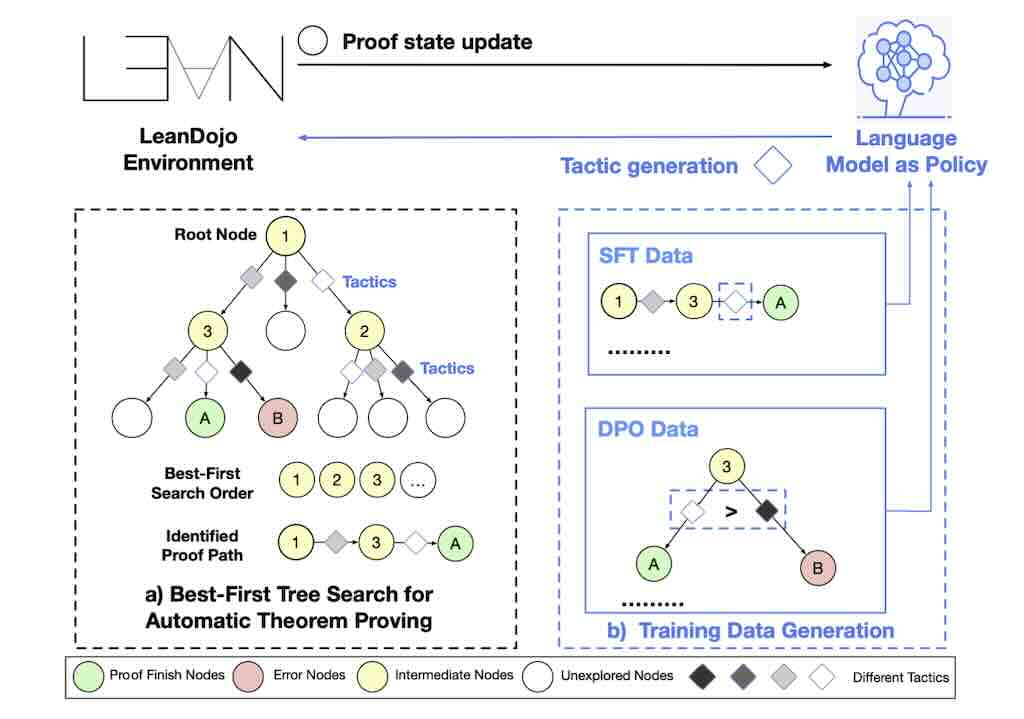
最佳優先搜尋 (BFS Best-First Tree Search) 是一種樹狀搜尋演算法,它透過優先從機率最高的節點來運作,屬於簡單和效率演算法,但普遍認為對於證明定理並不是最理想的方法。 BFS-Prover 挑戰了傳統觀點,提出一種可擴展的專家疊代框架,主要包含了三個創新點:一是策略性數據過濾,二是利用編譯回饋進行直接偏好優化 (DPO) Direct Preference Optimization,三是長度正規化。

最佳優先搜尋 (BFS Best-First Tree Search) 是一種樹狀搜尋演算法,它透過優先從機率最高的節點來運作,屬於簡單和效率演算法,但普遍認為對於證明定理並不是最理想的方法。 BFS-Prover 挑戰了傳統觀點,
提出一種可擴展的專家疊代框架,主要包含了三個創新點:一是策略性數據過濾,二是利用編譯回饋進行直接偏好優化 (DPO) Direct Preference Optimization,三是長度正規化。

Categories: 開源, 模型, 推理引擎

Page 1 of 2
1 2