Hy Memory 共享不同 Agent 的記憶

Hy Memory 的模型、框架、應用三層全開源。將聊天脈絡、工作進度與代碼修改原因分開管理,再讓不同 AI 工具共享同一份記憶。

Tencent Hunyuan

當 AI 需要記住的不只是單句事實,還包括事情是如何發展、任務做到哪一步,以及代碼為何這樣修改,Hy Memory 便提供了一套較完整的處理方式。它屬於面向 LLM agents 的認知記憶引擎與 Python SDK,將 Chat、Working、Coding 三類場景分開處理,減少長對話和長期任務中召回錯誤脈絡的問題。

Chat 以分層長期記憶整理事件及後續發展;Working 同時保存任務事實與可重用經驗,重用前會檢查適用條件;Coding 則以版本演化鏈追蹤每次改動,將相關指令、真實 diff 和指定函式區塊連結起來。這比單純把內容切段後交給向量搜尋更適合需要延續工作的 Agent,但也依賴清晰的 user id、workspace id 和代碼變更來源。

• 自動按工具呼叫及搜尋模式分流到三類記憶
• 支援記憶的新增、更新、刪除、列出及 System 2 演化
• Coding 可讀取本地 Git diff,亦可處理 path、old、new 替換記錄
• MemHub 將 Claude Code、Cursor、Codex、OpenCode 和 Qwen Code 等工具的資料集中管理

評測涵蓋四套 benchmark:LoCoMo 聊天記憶準確率為 72.6%,MemoryArena 工作記憶平均分為 55.31%,CodeMemoryBench 的問答及解決率為 64.2% 和 35.6%,SWE-ContextBench 解決率為 28.3%。官方亦指記憶儲存佔用維持在較低水平,但不同任務和資料來源仍會影響結果。

透過 hy-memory SDK 接入,按場景寫入及搜尋;不指定場景時,無工具呼叫的寫入會直接進入 Chat,帶工具呼叫的內容才會分類。Hy-Memory-30B-A3B 是負責記憶讀寫的專用模型,約有 3B 激活參數,並可與引擎分開使用;MemHub 則提供 local-first 桌面及 CLI 產品,適合需要跨 AI 工具延續對話或編程工作的個人與團隊。
項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, 模型, API, 工具, IDE, Python, 編程, Dataset 數據集

Terminal-RSI 讓終端機代理循環改寫策略

Terminal-RSI 透過成功軌跡反覆改寫與微調策略,提升模型完成終端機任務的能力。

Og image

終端機代理面對複雜指令時,往往不是完全不懂,而是在多輪操作中逐步偏離正確路徑。Terminal-RSI 是一項研究項目,利用驗證成功的 terminal trajectories,讓 27B 參數模型反覆修正自身行為,減少同類任務重犯錯誤的情況。

項目把 Recursive Self-Rewrite 與 Policy-Refine 分成兩條互相配合的流程。模型先透過不同 harness 產生操作軌跡,再由 terminal verifier 篩走失敗結果;成功軌跡會交給 actor 進行 SFT,critic 則保留並重新校準,之後再以 actor–critic PPO 一同優化政策。

它採用 TB-GAE(Turn-Based Generalized Advantage Estimation)追蹤生成 token 的責任,觀察內容留在上下文中,信用分配則沿着每輪操作向後傳遞。完成一輪後,保留的 checkpoint 會成為下一輪遞歸改進的起點,而非每次都由零開始訓練。

測試結果顯示,Terminal-Bench 4.0 的分數由 0.00% 升至 19.84%,Terminal-Bench 2.1 則由 51.70% 升至 86.52%,分別提升 19.84 個百分點及 34.82 個百分點。兩個基準版本的任務與難度不同,數字較適合用來觀察各自的改進幅度,不能直接當作同一條排行榜比較。

  • 只保留通過 verifier 的成功軌跡
  • 以 Recursive Self-Rewrite 改寫可重用的操作經驗
  • 以 Policy-Refine 持續調整 actor–critic 政策
  • Terminal-RSI-27B 是目前展示的最終 checkpoint
  • Code 與 model 仍標示為即將推出

對需要模型執行檔案處理、程式編輯或多步驟 shell 任務的工作流,這種訓練方式提供了另一條提升可靠性的方向。不過項目仍處於研究展示階段,代碼及模型尚未公開,結果亦主要集中於指定的 Terminal-Bench 評測。

項目主頁

Categories: 開源, 騰訊, Agentic, 模型

Multics:開源多玩家世界模型

Multics 是騰訊 ARC Lab 與港大合作的多玩家影片生成世界模型,靠分層通訊機制讓同一個訓練版本直接推廣到 6、8、10 人,玩家與鏡頭控制互不干擾。

Repository image for TencentARC/Multics

打機時如果有 4 個、6 個甚至 10 個玩家走在一起,畫面要保持連貫,又要讓每個人各自控制鏡頭與動作,舊做法往往一加人就 O(N²) 爆計,或出現互相干擾。Multics 正是針對這個卡位:來自騰訊 ARC Lab 與香港大學的開源世界模型,採用 Player → Group → Global 的分層通訊,動態根據最近鏡頭軌跡分組,限制無關事件直接混合。共享的 group-token 參數令用 4 人數據訓練的模型,可以直接推廣到 6、8、10 人而毋須重新訓練。

對於做多人遊戲原型、模擬訓練環境或敘事影片的團隊,這個項目直接省掉「人數一變就要重訓模型」的麻煩,同時降低自注意力計算量,GPU 開銷壓得較低。它的代價是依賴 NVIDIA GPU、CUDA 12.8 與 Linux 環境,安裝需用 uv 同步依賴,並從 Hugging Face 下載包含 VAE、tokenizer 與 4-player checkpoint 的完整推理包。

Repository 提供 inference.py 配合 YAML 配置,可選擇 4-player 範例或擴展到多人數測試,原始資料未列出具體的玩家數上限驗證結果,只說明同一個 4 人 checkpoint 能支援 10 人輸出。代碼以 Apache 2.0 授權,研究與商業應用皆可改作。

重點摘要:

  • 騰訊 ARC Lab 與香港大學共同開發的多玩家影片生成世界模型
  • 分層通訊機制降低注意力計算成本,避免無關玩家互相干擾
  • 共享參數設計讓 4 人訓練版本直接支援 6、8、10 人,毋須重新訓練
  • 推理需 Linux + CUDA 12.8 + NVIDIA GPU,模型權重經 Hugging Face 發佈
  • 適合多人遊戲畫面合成、模擬訓練、互動敘事等需要可擴展多視角的工作場景

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 騰訊, 模型, 世界模型, 模型訓練, NVIDIA, Video, 香港, Linux, Tokenize

WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

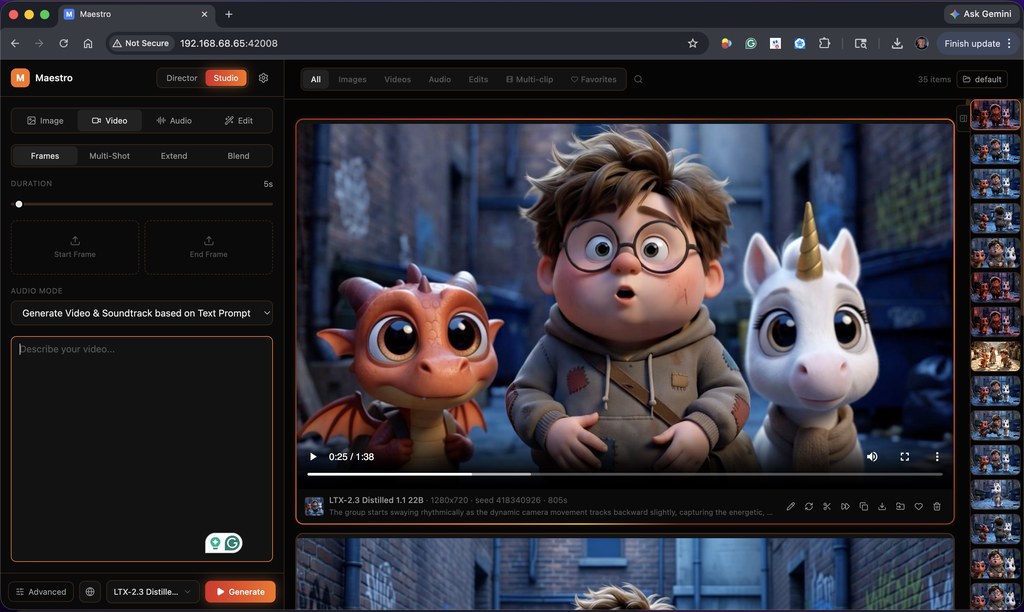
Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

WorldCrafter 記住你走過的世界

WorldCrafter把單張圖片或文字提示變成可操控鏡頭的連續場景,改善長時間探索時畫面失憶與視角不一致的問題。

鏡頭移開再回望時,生成場景仍能維持空間關係,正是 WorldCrafter 要處理的核心卡位。它屬於影片世界模型,能從單張圖片或文字提示建立可探索場景,並按照鏡頭控制生成後續畫面,減少長時間移動、回訪視角時的內容漂移。

WorldCrafter以可由鏡頭查詢的隱式 3D-aware memory 保存過往觀察,讓指定視角決定哪些歷史資訊交給影片生成器;記憶編碼器與姿態條件讀取模組會把不同視角的資料整理成目標視角適用的 memory tokens。它不依賴顯式深度估計或幾何 warping,近期 temporal context則負責維持動態物件和連續動作。

WorldCrafter Video Demo

提供 WorldCrafter-Base,以及經蒸餾、面向較快推理的 WorldCrafter-Fast。兩者可在 Linux、Python 3.11、NVIDIA GPU 和相容 CUDA 驅動環境運行,模型權重放在 Hugging Face;Fast 版本較適合互動式串流,但硬件要求和生成速度仍取決於本地配置。

  • 支援圖片轉可探索世界,也支援文字轉可探索世界
  • 可控制鏡頭、揭示未見區域,並回到曾經觀察的視角
  • 設計同時兼顧靜態場景、動態場景和長時間探索
  • 評測涵蓋145個場景及725條鏡頭軌跡

評測中,WorldCrafter在長時間回訪一致性和鏡頭控制準確度上優於參與比較的基線,整體 VBench 分數亦最高;項目展示的點雲與鏡頭軌跡重建,則用來檢查生成影片的幾何連貫性。研究團隊來自 Tencent ARC Lab 與北京大學,較適合研究生成式世界模型、可控影片、虛擬場景探索及互動內容的團隊測試。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 騰訊, AI productions, 模型, 世界模型, NVIDIA, Video, Image, 3D, Linux, Dataset 數據集

WeVisDoc 騰訊文件圖片的端到端解析模型

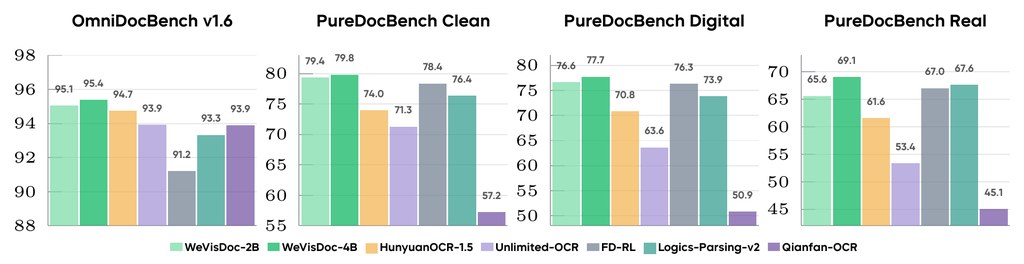
騰訊 WeChat Vision 團隊開源 WeVisDoc 系列文件解析模型,以「先擴廣覆蓋、再針對性補強」的兩階段訓練框架,在 OmniDocBench v1.6 與多個 PureDocBench 軌道同時刷新端到端解析器紀錄。

WeVisDoc-4B leads the compared end-to-end parsers across all four reported settings.

當一份文件同時夾雜模糊掃描、手寫註記、複雜表格與數學公式時,多數 OCR + 版面分析的流水線都會在交接處出錯——模型間責任不清,錯誤層層放大。騰訊 WeChat Vision 團隊開源的 WeVisDoc 系列正正針對這個痛點,把「文件頁 → 結構化 Markdown(含 LaTeX 公式、HTML 表格)」收進單一端到端模型,避免不同模組互相推卸責任。

WeVisDoc 推出 2B 與 4B 兩款模型,皆以 Qwen3-VL 為基座微調而成,覆蓋文字、公式、表格與閱讀順序四個維度。訓練方法分兩階段:Stage I 先擴大語義、結構、外觀三方面的數據覆蓋;Stage II 則用殘差診斷找出 Stage I 仍出錯的樣本,針對性地補充與重新分配訓練數據。這套做法與單純堆數據量的路線不同——它把精力集中在模型最容易跌倒的角落。

在 OmniDocBench v1.6 上,WeVisDoc-4B 取得 95.38 的 Overall 分數,三條 PureDocBench 軌道的平均分為 75.54,均為目前端到端解析器的最佳成績。在更貼近真實擷取條件的 PureDocBench Real(模擬四次實體拍攝劣化)上,相對次強基線仍拉開 1.44 分,是四個比較場景中差距最大的一項,正好對應 Stage II「在真實擷取最難看的外觀變化上獲得最大增益」的設計初衷。

對需要把大量歷史紙本文件、學術論文、表格報表轉成結構化內容的研究團隊與企業來說,WeVisDoc 提供了一個開源、可在本地用 GGUF 等格式部署的小模型選項。模型現已上載 Hugging Face,並附技術報告與互動式 Recovery Lab,方便逐頁對比 Stage I 與 Stage II 修復了哪些具體錯誤(例如被漏掉的 9×9 數獨格線)。

  • 騰訊 WeChat Vision 團隊開源的端到端文件解析模型,2B/4B 兩個規模,皆基於 Qwen3-VL 微調
  • 兩階段「數據中心」訓練框架:Stage I 擴大覆蓋、Stage II 以殘差診斷針對性補強
  • 輸出結構化 Markdown,內含 LaTeX 公式與 HTML 表格,涵蓋文字、公式、表格、閱讀順序四維度
  • WeVisDoc-4B 在 OmniDocBench v1.6 與三條 PureDocBench 軌道均居端到端解析器首位
  • 開源釋出模型權重、技術報告與互動式範例頁,方便逐頁審視修復效果

項目主頁 · GitHub

Categories: 開源, 騰訊, 模型, 模型訓練, Qwen, 框架, Dataset 數據集

KaiNinja 將 3D 生成推到部件級 – 直接拆零件

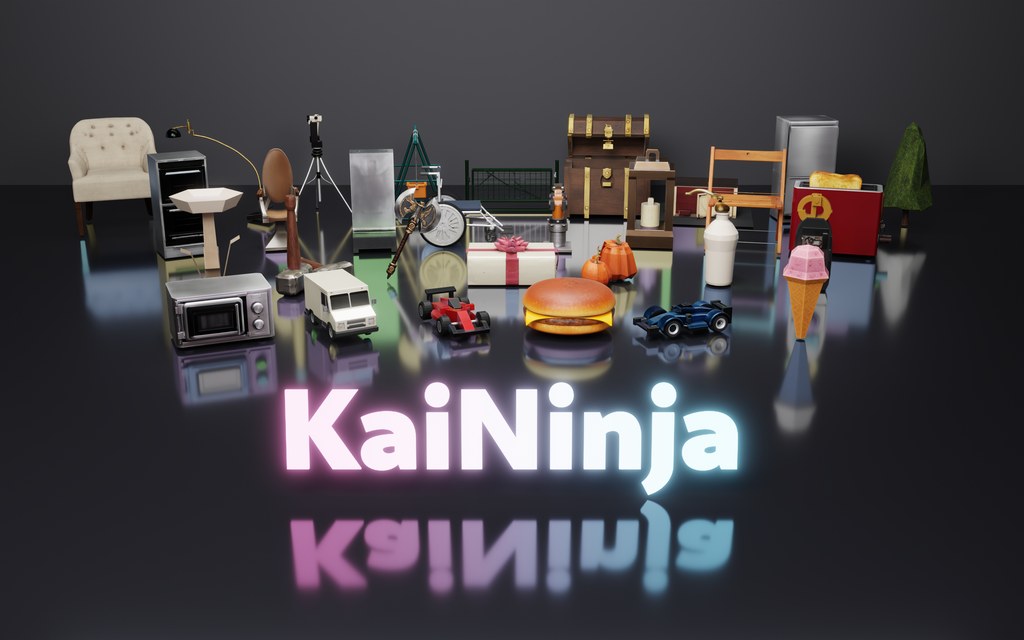
一張圖就能生成分件可拆的 3D 模型,毋須人手標註或語義分割。KaiNinja 用兩個 O-Voxel 體素保留部件接觸面,把原生 3D 生成器延伸到部件級。

KaiNinja teaser

以往想做一張椅子、可以分開拆件再重新組裝的 3D 模型,往往要事先畫遮罩或跑一套語義分割網絡,既費時又限制後續編輯彈性。KaiNinja 由 Alaya Lab 團隊提出,目標是把 TRELLIS.2 這類原生 3D 生成器直接延伸成「部件級」輸出,毋須遮罩或分割網絡就能從單張圖生成可拆分的部件網格。

模型輸出兩個 O-Voxel 體素,各自解碼後透過連通區分量化成獨立部件,同時保留部件之間的接觸面,避免拆件後出現破洞或懸空。換言之,它在現有 3D 生成流程中替代或補強的,就是那一步手動標註與分割。

對遊戲美術、3D 資產設計、以及需要快速做可編輯原型的團隊來說,這類即拆即改的部件輸出明顯降低後製成本。雖然目前只釋出技術報告與項目頁面,推斷碼與預訓練權重尚未開源,但官方展示的下游材質替換與手繪動畫片段,已能看出部件分離對後續工序的實質幫助。

官方在 986 個物件的評測中,以匈牙利配對方式同時報告整體與部件級指標,在 CD、F1、mIoU 七個項目上均領先 X-Part、OmniPart、PartPacker、AutoPartGen 等同類方法,亦勝過用同一語料微調過的 TRELLIS.2。Fail 率(即整體 CD 大於 0.1 的比例)亦由 5.4% 降至 0.7%,代表部件拆分並沒有犧牲整體幾何質素。

重點摘要

  • 輸入單張圖片即可輸出部件級 3D 網格,免遮罩免分割網絡
  • 以兩個 O-Voxel 體素保留部件接觸面,避免拆件破洞
  • 在 986 件評測中,部件與整體指標同步領先 OmniPart、PartPacker、AutoPartGen
  • Fail 率由 TRELLIS.2 的 5.4% 降至 0.7%,整體幾何質素未受部件任務拖累
  • 目前僅有技術報告與項目頁面,源碼與權重標示為 Coming soon

項目主頁 · GitHub

Categories: 開源, 騰訊, AI productions, 模型, Image, 3D, 動畫

騰訊混元開源 AuK:1.5B 模型統一語音生成與編輯

騰訊混元把零樣本 TTS、語音編輯、分離與增強收進同一個自然語言指令介面,並同步釋出追求速度的蒸餾版本 AuK-Flash。

AuK performance across speech generation, editing, enhancement, and separation benchmarks

語音模型一直存在一個尷尬:零樣本合成、語音克隆、音色替換、分離、降噪往往是幾套獨立系統,要串起來就得堆 pipeline。騰訊 Hunyuan 開源的 AuK 想打破這個分工,以 1.5B 參數的基礎模型為核心,讓一句自然語言指令直接對應到編輯後或生成的音訊。

AuK 由三部分組成:負責語義條件的多模態語言模型、提供聲學潛在空間的 50 Hz VAE,以及一個混合 rectified-flow Transformer,用雙流 MMDiT 塊融合兩種條件後再做單流 DiT 生成。訓練數據規模相當可觀——約 30.3 億條指令-音訊配對,加上約 195 萬小時的有效監督,覆蓋五大任務族:語音生成、內容編輯、增強與分離、副語言資訊編輯、聲學編輯。

同步釋出的 AuK-Flash 走速度路線:透過一致性初始化加上任務路由的 Decoupled DMD 蒸餾,做到 NFE=4、無 CFG 的 4 步推論,官方指在匹配條件下對比完整 AuK 有約 4.5 倍 wall-clock 加速,質量接近教師模型。這個分層策略對需要即時語音生成的應用場景(如對話 agent、實時配音)有直接意義。

部署層面,官方同時提供 Hugging Face Space、ModelScope Space、Gradio 互動介面、ComfyUI 節點、Python API,以及 uv 和 Conda 兩種依賴管理方式,並已獲 SGLang-Omni Day 0 支援。對於本地資源有限的團隊,AuK-Flash 配合 SGLang-Omni 是較合理的切入點;如果追求最高質量、且不在意推論延遲,則可選 AuK Base,並透過可配置的 NFE 與 CFG 做品質/速度取捨。

重點摘要:

  • 1.5B 統一模型:用自然語言指令統一零樣本 TTS、語音編輯、分離、增強、副語言與聲學編輯。
  • 三模組架構:多模態語言模型 + 50 Hz 音訊 VAE + 混合 rectified-flow Transformer,採雙流 MMDiT 接單流 DiT。
  • AuK-Flash 蒸餾:一致性初始化 + 任務路由 DMD,4 步推論無需 CFG,wall-clock 加速約 4.5 倍。
  • 後訓練策略:語音生成用獎勵強化學習,開放式編輯用人類偏好優化。
  • 部署支援完整:Hugging Face、ModelScope、Gradio、ComfyUI、Python API、SGLang-Omni 齊備。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, 文字轉語音, ComfyUI, Agentic, 模型, 多模態模型, 模型訓練, API, Audio, Python, 語音

Page 1 of 4
1 2 3 4