TempCloze:揭開 Video-LLM 的時間盲區

TempCloze 是一個專門測試 Video-LLM 視覺時間推理能力的影片填空基準,從七個來源收集 1,521 條長鏡頭與第一人稱影片,挑戰模型能否在四選一中找回正確的「消失中段」。它直接揭示現有模型在時間對齊上的明顯短板。

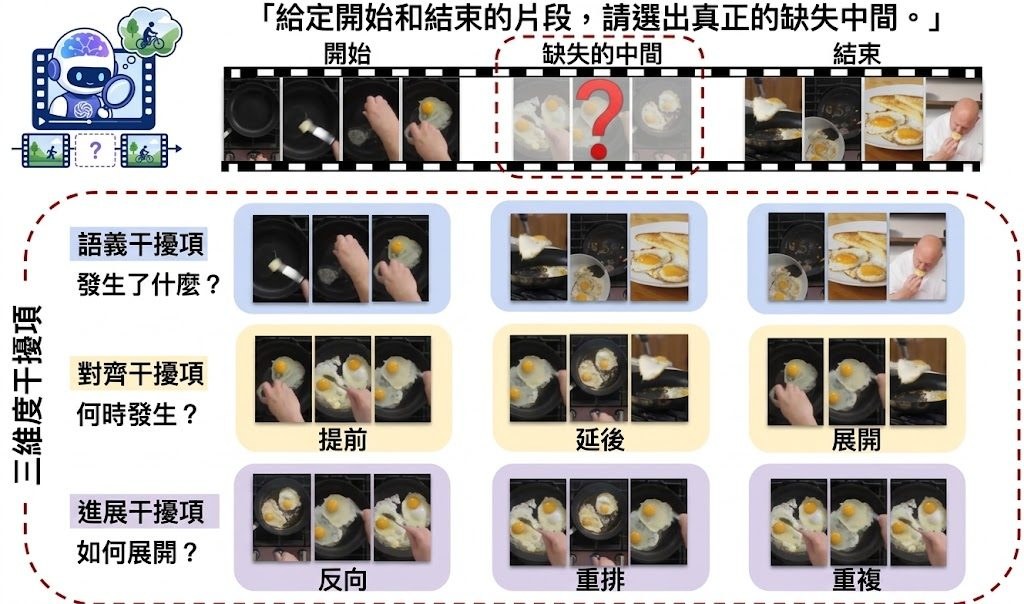
Overview of the TempCloze benchmark

TempCloze 的玩法相當直觀:給一段影片的開頭與結尾,要求模型從四段候選片段中挑出真正屬於中間缺失的那一段。四個選項全部來自同一條影片的素材,連文本線索都壓到最低,等於逼模型只能用眼睛去判斷時間先後與事件流暢度。

這套基準特別針對三個時間維度:語義(Semantic,考「發生了什麼」)、對齊(Alignment,考「應該在何時發生」)、推進(Progression,考「事件如何展開」)。對齊的干擾選項設計得很巧妙,例如把同一段內容前移、後移或拉長;推進維度則把片段倒播、重排、重複,看模型能否識破。題目素材刻意挑選長鏡頭與第一人稱影片,避免靠剪輯或場景切換就能蒙混過關。

跑完 31 個 Video-LLM(10 個閉源加 21 個開源)後結果很殘酷:無論是 GPT 類還是開源權重,模型在對齊任務上的準確率幾乎腰斬,閉源平均從語義 70.73% 跌到對齊 48.13%,開源平均更只剩 26.54%。相比之下,人類在嚴格協議下仍能達到 97% 平均正確率。換言之,現在的 Video-LLM 對畫面在時間軸上的位置幾乎沒概念,只能靠語義關聯硬猜。

對於做影片理解、embodied AI、多模態基準研究的人來說,這份工具包很值得關注。它提供統一抽幀協議(每段 16 幀,六片段題 96 幀),評測流程可直接套用,重點在於指出時間對齊才是視頻推理的真正瓶頸,數字與圖表都已經整理好。

重點摘要:

  • 任務設計:四選一影片填空,所有干擾項來自同一條原片,消除文本捷徑
  • 三維度考核:語義、對齊、推進,分別測事件、位置、展開方式
  • 數據規模:1,521 條影片,長鏡頭與第一人稱為主,七個公開來源
  • 核心發現:對齊維度是最大瓶頸,開源模型跌至 26.54%,閉源亦僅 48.13%
  • 工具價值:統一抽幀協議與評測腳本,可直接比較現有 Video-LLM 在時間推理上的差距
GitHub

Categories: 開源, Agentic, 模型, 視覺模型, Video, 影像處理, 框架, 工具

World in World 把 14B 世界模型變成你的虛擬攝影機

想用一條普通影片就做到 360 度重拍、子彈時間、視角切換?World in World 讓凍結的 14B 影片世界模型 LingBot-World 2.0 直接「走進」影片,無需微調,單卡 80GB GPU 即跑。

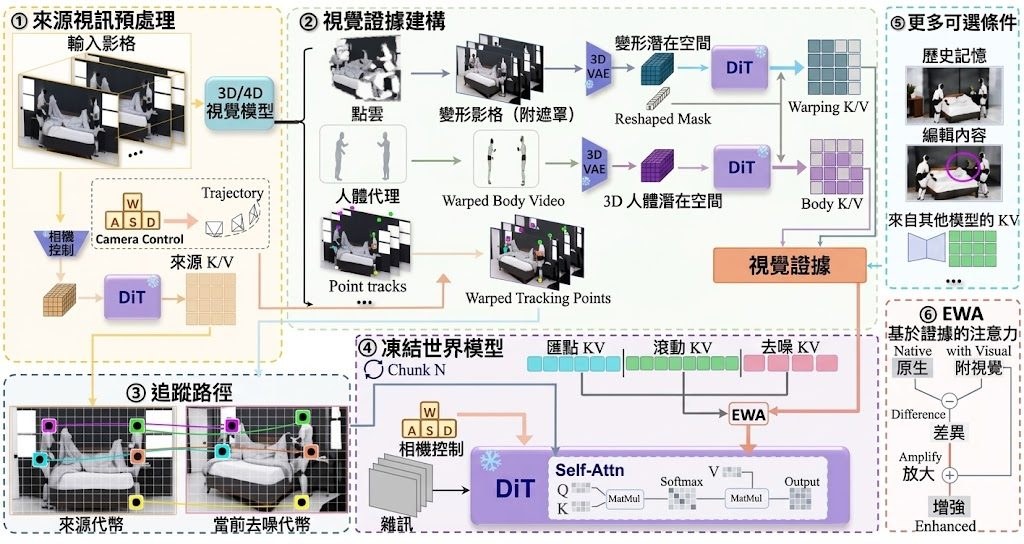
pipeline

對於做特效、剪輯或沉浸式內容的人來說,最頭痛的往往不是生成新畫面,而是手上明明有一段拍好的影片,卻想換個角度、換條鏡頭軌跡重新「拍一次」。Westlake-AGI-Lab 推出的 World in World,正是針對這個卡位:給定一段輸入影片和一條新相機路徑,模型會重新生成同一事件在新視角下的畫面,不用訓練、不用微調。

它本質是一個影片再攝影框架,骨幹是一個凍結的 14B 影片世界模型 LingBot-World 2.0。技術上沒有走 latent editing 或 GAN 反轉的老路,而是把所有可控制的訊號——來源影片、場景幾何、相機參數——全部變成視覺證據:先用深度把來源幀提升到 3D,依新相機路徑 warp 過去,再當成額外 key/value 塞進模型自己的 attention,讓模型「看到」新相機應該看到什麼,缺失的部分由它自己補完。這種做法讓相機軌跡、人物動作與場景幾何保持高度一致。

從結果來看,它已經放出自由相機重拍、子彈時間和影片編輯三項功能;大型角度 360 度重拍結合 3D 人體代理、跨模型記憶共享、長影片 frustum memory、串流互動生成、動作遷移等仍在路線圖中。對特效團隊、短片創作者、遊戲過場預覽、AR/VR 內容開發者來說,可以用一條現成素材快速產出多視角版本,而不必從零生成或手動三維重建。

官方在 Linux 上以 80GB A100 測試,峰值記憶體約 72GB,需 CUDA 12.4 與 Python 3.10,並預編譯 flash-attn wheel 以避免從源碼編譯。相較同類影片重生成方案,它放棄了對模型本體做適配,以 warp + attention injection 換取「即插即用」與較低硬體門檻,但代價是大角度旋轉、人物遮擋等極端情況仍依賴後續的 3D 代理與 frustum memory。

  • 凍結模型免訓練:以 warp 後的視覺證據作為 attention key/value,無需微調 14B 世界模型。
  • 多視角影片重拍:支援弧線、推拉、平移、定點旋轉等自由相機路徑。
  • 子彈時間與影片編輯:凍結任意一幀改變視角,或改第一幀讓編輯自然延伸至整段。
  • 單卡 80GB 可跑:Linux + A100 + CUDA 12.4 + Python 3.10,硬體門檻相對可控。
  • 路線圖仍在擴展:360 度重拍、跨模型記憶、串流生成等功能陸續排程中。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, 3D, Linux, Python

Edge0 開源框架:Mac 本機推論 35B MoE,記憶體僅佔用 2.9 GB

Edge0 是一套開源串流 MoE 推論框架,靠 SSD 專家卸載搭配 LoRA 還原與前置路由器,在 Apple Silicon 上把 35B 等級的 MoE 模型壓到 2.9 GB 活動記憶體就能跑,對想在筆電本機玩大型稀疏模型的人來說是個務實的選擇。

edge0

MoE 模型參數規模愈推愈大,但真正能在消費級硬體本機跑得動的方案一直不多。Edge0 想處理的就是這個落差:它把 SSD 專家卸載、Recover-LoRA 還原、以及 prerouter 路由預測這三招組合成一套可擴展框架,目前以 MLX 後端跑在 Apple Silicon(M1 至 M4)上,CUDA 後端列在路線圖但尚未支援。

隨框架釋出兩個模型檔:edge0-35b(基於 Qwen3.5-MoE 35B-A3B)與 edge0-8b(基於 Ling 3.0 bailing 混合架構),皆以 4-bit 量化釋出。LoRA 配重與 prerouter 頭已隨 checkpoint 一同發佈,edge0 serve 即可直接載入訓練好的完整管線,不用額外拼湊組件。短上下文情境下,edge0-35b 峰值活動記憶體約 2.9 GB,edge0-8b 約 1.0 GB;專家權重以 mmap 方式按需讀取,不會預先佔用 RAM。

TierReleased checkpointInference profile
edge0-35bEdge0/Edge0-35B-A3B-preview4-bit, 40 layers, 256 experts, prerouter K=4
edge0-8bEdge0/Edge0-8B-A1B-preview4-bit, 24 layers, 128 experts, prerouter K=8

使用介面提供 AutoModel、AutoConfig、AutoEngine 自動按模型名稱解析層級。所有 MLX 程式碼集中在 edge0/backends/mlx/,核心邏輯只依賴抽象層,因此日後加入 CUDA 等後端時不必重寫調度邏輯。

  • 類型:開源 MoE 推論框架(搭配兩個預訓練 checkpoint)。
  • 資源門檻:4-bit 35B 模型約 23 GB 磁碟、2.9 GB 活動記憶體;8B 模型約 4.2 GB 磁碟、1.0 GB 活動記憶體。
  • 硬體限制:目前僅支援 macOS Apple Silicon,CUDA 仍在規劃中。
  • 目標用戶:想在 M 系列 MacBook 上本機試跑大型稀疏模型的研究者、開發者,以及對 VRAM 不夠、又不願完全依賴雲端推論的團隊。
  • 差異化:相較純量化或純卸載方案,Edge0 把 prerouter 預測與 LoRA 還原包進同一條管線,讓卸載後的精度損失有明確補償路徑。

Edge0 屬於「先把本地大型 MoE 跑起來」這個務實路線上的工具,限制也很清楚:必須在 Apple Silicon 上跑、長上下文 KV 會額外吃記憶體、目前沒有非 Apple 平台的後端可用。對想驗證稀疏模型在消費硬體可行性的人,這套框架省去了自行整合卸載與適配器還原的功夫;對 NVIDIA 用戶,則要等 CUDA 後端落地。

GitHub

Categories: 開源, 模型, Qwen, NVIDIA, 框架, 工具, Mac, 蘋果

騰訊混元開源 AuK:1.5B 模型統一語音生成與編輯

騰訊混元把零樣本 TTS、語音編輯、分離與增強收進同一個自然語言指令介面,並同步釋出追求速度的蒸餾版本 AuK-Flash。

AuK performance across speech generation, editing, enhancement, and separation benchmarks

語音模型一直存在一個尷尬:零樣本合成、語音克隆、音色替換、分離、降噪往往是幾套獨立系統,要串起來就得堆 pipeline。騰訊 Hunyuan 開源的 AuK 想打破這個分工,以 1.5B 參數的基礎模型為核心,讓一句自然語言指令直接對應到編輯後或生成的音訊。

AuK 由三部分組成:負責語義條件的多模態語言模型、提供聲學潛在空間的 50 Hz VAE,以及一個混合 rectified-flow Transformer,用雙流 MMDiT 塊融合兩種條件後再做單流 DiT 生成。訓練數據規模相當可觀——約 30.3 億條指令-音訊配對,加上約 195 萬小時的有效監督,覆蓋五大任務族:語音生成、內容編輯、增強與分離、副語言資訊編輯、聲學編輯。

同步釋出的 AuK-Flash 走速度路線:透過一致性初始化加上任務路由的 Decoupled DMD 蒸餾,做到 NFE=4、無 CFG 的 4 步推論,官方指在匹配條件下對比完整 AuK 有約 4.5 倍 wall-clock 加速,質量接近教師模型。這個分層策略對需要即時語音生成的應用場景(如對話 agent、實時配音)有直接意義。

部署層面,官方同時提供 Hugging Face Space、ModelScope Space、Gradio 互動介面、ComfyUI 節點、Python API,以及 uv 和 Conda 兩種依賴管理方式,並已獲 SGLang-Omni Day 0 支援。對於本地資源有限的團隊,AuK-Flash 配合 SGLang-Omni 是較合理的切入點;如果追求最高質量、且不在意推論延遲,則可選 AuK Base,並透過可配置的 NFE 與 CFG 做品質/速度取捨。

重點摘要:

  • 1.5B 統一模型:用自然語言指令統一零樣本 TTS、語音編輯、分離、增強、副語言與聲學編輯。
  • 三模組架構:多模態語言模型 + 50 Hz 音訊 VAE + 混合 rectified-flow Transformer,採雙流 MMDiT 接單流 DiT。
  • AuK-Flash 蒸餾:一致性初始化 + 任務路由 DMD,4 步推論無需 CFG,wall-clock 加速約 4.5 倍。
  • 後訓練策略:語音生成用獎勵強化學習,開放式編輯用人類偏好優化。
  • 部署支援完整:Hugging Face、ModelScope、Gradio、ComfyUI、Python API、SGLang-Omni 齊備。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, 文字轉語音, ComfyUI, Agentic, 模型, 多模態模型, 模型訓練, API, Audio, Python, 語音

SyncWorld:用一段影像校準,讓世界模型零樣本遷移到新機械人

同一個數值動作換了鏡頭或機械人就失效?SyncWorld 以「視覺校準片段」作為提示,讓單一世界模型即時推斷動作與畫面嘅對應關係,毋須再為每個環境重新微調。

SyncWorld teaser

動作數值喺像素空間其實唔係通用語言——換鏡頭、換機械人位置、換機械結構,同一個動作指令就會產生唔同嘅視覺效果,亦即係點解用混合數據訓練出嚟嘅動作條件世界模型(action-conditioned world model)喺新場景入面成日失效。SyncWorld 嘅切入角度係:既然動作同畫面嘅對應因環境而異,不如用一段包含每個可控自由度(DoF)嘅短影像校準片段(visual calibration episode)做 in-context prompt,等模型喺推論時即場估計呢套環境嘅 Action–Visual Mapping,從而把單一 checkpoint 變成零樣本(zero-shot)模擬器,毋須額外訓練。

基於 NVIDIA Cosmos-Framework 改寫而成,並非由零開始砌嘅新網絡。對比一般針對單一機械人做 fine-tuning 嘅做法,SyncWorld 用視覺證據取代權重記憶;訓練時混入 calibration context 之後,模型仲學識喺冇 calibration 嘅情況下落返去用互動歷史做預測。程式庫提供分散式 FSDP trainer、typed TOML 食譜同原生 DCP checkpoint,可以直接匯出 HuggingFace safetensors;評估就用全段自回歸 rollout,配合 PSNR、SSIM、LPIPS 量度像素相似度。

直接受惠:需要喺多款 xArm、ARX5、KUKA、Franka Panda、UR5e 等異質平台上做 sim-to-real 想像嘅機械人研究團隊;做測試時策略改進(test-time policy improvement)而唔想再花錢訓練嘅 RL 團隊;以及想避開「每個新 setup 都要重新標註動作」呢個樽頸嘅數據團隊。Demo 顯示佢能準確模擬未見過嘅設定入面嘅動作後果,並令策略喺測試階段靠 rollout 改善而毋須再訓練。

重點摘要:

  • 以視覺校準片段作為 in-context prompt,免去 per-deployment fine-tuning
  • 訓練同時令模型能喺冇 calibration 時回退用互動歷史
  • 基於 NVIDIA Cosmos-Framework 改寫,提供 FSDP 訓練同 DCP checkpoint
  • 評估用全段自回歸 rollout,配 PSNR、SSIM、LPIPS 指標
  • 模型權重同評測集已開喺 HuggingFace:yyuncong/SyncWorldyyuncong/SyncWorld-Evaluation

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, NVIDIA, Image, Robotic, 框架, AGI, Dataset 數據集

Show-Harness:VLM 極簡語意操縱機械臂

Show-Harness 把機械人控制壓縮成一組離散語意動作單位,讓視覺語言模型直接負責物理決策,省去針對特定硬件的預訓練與額外參數。

Show-Harness

機械人領域一直有個尷尬落差:底層視覺語言模型(VLM)識睇識講,但要佢實際控制一隻機械臂,往往要再預訓練、加 VLA 頭或寫一大堆適配層。Show-Harness 嘗試用另一種方式切入──直接把動作壓縮成一組細粒度、離散的語意單位(例如 MV_FWD、GRASP、ROTATE_CW),由 VLM 逐個 token 推理,再交俾硬件專屬嘅 interpreter 去 deterministically 落地成實際機械動作。換句話,VLM 唔再需要理解「毫米」或「關節角度」,只需揀語意單位。

你可以用兩種方式跑:直接接駁前沿閉源 VLM 做 zero-shot 控制,又或者拎幾個 GPU 小時微調小型開源 VLM,產出每秒 12 至 33 Hz 嘅本地執行版本。Franka、AgileX Piper(單臂同雙臂)、ManiSkill、Isaac Lab 都共用同一套詞彙同一個 prompt,唔使逐隻 robot 寫 prompt。項目同時附帶 GUMI:一個瀏覽器內嘅 GUI 操作介面,等你可以用鍵盤滑鼠親身「玩」機械人收 demonstration,完全唔需要專業遙操作硬件。

  • 極薄中介層:VLM 只負責揀語意 token,所有 metric 細節由 interpreter 處理,避免額外模型容量開支
  • 跨硬件共用詞彙:Franka、AgileX、ManiSkill、Isaac Lab 共用同一套動作字典與 prompt
  • 兩種部署路徑:前沿閉源 VLM zero-shot,又或者 LoRA 微調小型開源 VLM,本地即可執行
  • GUMI 無硬件收數據:瀏覽器內 GUI 操作即收 demonstration,省去 teleoperation 設備
  • 插件式消融設計:一個目錄、一個 boolean flag,閂咗就等同冇裝

相對於 π0.5 同 GR00T 呢類 VLA 路線,Show-Harness 嘅取捨偏向「interface 解耦」──唔再要求模型本身內化硬件物理量,而是把 metric 還返俾環境層解讀。對做具身研究、想快速換 embodiment 驗證嘅團隊,或者資源有限、要靠 LoRA 微調部署嘅實驗室都幾實用;研究 embodied agent 同 VLM 接駁嘅開發者都可以直接拎去試 prompt 同詞彙設計。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 模型訓練, VLA, Robotic, Dataset 數據集

MiniMax H3 首尾幀工作流:ComfyUI 一張面板切換三模式、輸出帶聲影片

這個 ComfyUI 工作流把 MiniMax H3 的首尾幀、Turbo LoRA、影片與音訊 VAE 全部封進子流程,外層直接選模型、改步數與時長,最後由 SaveVideo 輸出 24fps 的帶聲短片。

MiniMax H3 总控面板使用指南

想用兩張圖片框住一段六秒帶聲音的影片,再順手在 ComfyUI 面板上換模型、改步數,這個工作流把這件事收得很緊。整套流程把 MiniMax H3 的基礎模型、Qwen3-VL 文本編碼器、影片與音訊 VAE,以及四步 Turbo LoRA 全部塞進一個子流程,常用參數留在外層,內層只負責解析度對齊 32 倍數、計算幀數、把影片與音訊解碼後合成輸出。

跟一般 ComfyUI 影片節點相比,它最直接的差異是「首尾幀可選」:上方節點接首幀、下方節點接尾幀,兩個都填就是首尾幀生成,只填首幀就退回傳統圖生視頻,兩個都跳過則變成純文生視頻,三種模式不用複製工作流,直接在同一張畫布切換。音訊方面也省事,音訊 VAE 跟影片 VAE 分開載入,輸出端靠 SaveVideo 一次寫入 mp4,不用再手動合成聲道。

部署門檻主要在三個地方:ComfyUI 要支援子圖功能、要額外安裝 ComfyUI-MiniMax-H3-Turbo 節點包以取得 MiniMaxH3TurboLoRA,以及 Hugging Face 上的五個權重檔案要放到對應的 diffusion_modelstext_encodersvaeloras 目錄。JSON 內只記錄檔名而非圖片本體,使用前要把首幀、尾幀重新上傳;工作流也沒有附帶顯存或速度數據,必須自己測試本地硬體夠不夠撐得起 int8 基礎模型加 Qwen3-VL 32B 文本編碼器。

對已經在跑 ComfyUI、又想試 MiniMax H3 首尾幀能力的人,這個工作流算是最低摩擦的入口:不用自己接駁一堆節點,也不用研究子流程內部的取樣細節,外部面板就涵蓋了模型選擇、步數、目標時長、種子、寬高比與百萬像素等設定。對只想快速驗證概念或做短影音素材的內容創作者,這種「拉進畫布、換圖、寫 prompt、執行」的流程會比從零搭建省下不少時間。

重點摘要

  • 類型:ComfyUI 工作流 JSON,屬於模型整合與流程封裝類工具,目標是簡化 MiniMax H3 帶聲影片生成。
  • 核心能力:首尾幀、首幀圖生視頻、文生視頻三種模式可切換,並內建音訊解碼與合成。
  • 關鍵依賴:ComfyUI 需支援子圖,另需安裝 ComfyUI-MiniMax-H3-Turbo 節點包與五個 Hugging Face 模型檔案。
  • 輸出規格:24fps,寬高自動對齊 32 倍數,時長與步數可在外層調整。
  • 限制:未提供顯存峰值、速度與相容性測試,需自行驗證本地硬體;JSON 內只存圖檔名,圖片要重新上傳。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, Video, Image, Audio, 工具, Content Creator, MiniMax

PWM(Programmable World Model) 以世界模型驅動影片生成

AlayaLab 開源的 Programmable World Model 把世界狀態與畫面生成拆開管理,讓角色、事件與鏡頭外的物件都能被查詢、修改與驗證,不再只靠潛在影像記憶。

Programmable World Model overview

影片世界模型能夠即時渲染出像真的畫面,但畫面背後其實欠缺一部「世界引擎」——狀態藏在影像序列裡,難以檢查、編輯或驗證,鏡頭一轉,鏡頭外的角色與潛在事實就會被悄悄遺忘。AlayaLab 開源的 Programmable World Model(簡稱 PWM)正正針對這個痛點,把世界狀態的維護與視覺生成徹底解耦,由一個 state executor 負責推進世界狀態,再由 deterministic compiler 把以 state-augmented 3D OBB 描述的狀態投影成 pixel-aligned controls,最後才交給影片模型渲染畫面。

這個框架真正解決的問題,是讓世界「可被編程」。同一份世界狀態可以驅動任意鏡頭、任意視覺風格,角色即使離開畫面依然存在,事件具備不可逆性,亦可由規則觸發;使用者可以用類似 WASD 的方式操控,並預先以語言定義世界規則。一個 VLM-based agent 會讀取參考圖與開放式文字,自動寫出可執行的世界規格。

PWM 屬於框架類項目,定位接近研究原型。與 Genie 3、GameNGen 等同類做法相比,PWM 的取捨在於放棄純端到端的潛在表達,換取可查詢、可驗證、可長時序的狀態;對於遊戲開發者、需要可控互動世界的模擬研究者,以及想用程式化方式生成可控影片內容的團隊,這種顯式狀態設計明顯更貼近「世界引擎」的真正需求。

目前 PWM 已釋出技術報告,推理程式碼與預訓練權重尚未開源,因此暫時只能從紙面層面理解並等待官方補上權重。從架構看,這個方向對於追求可控性與持久性的應用場景會有明顯吸引力。

重點摘要:

  • 狀態與畫面解耦:狀態由 executor 維護,畫面由影片模型渲染,互不綁定
  • 可查詢、可驗證的世界事實:角色、事件與鏡頭外實體都能被檢查與修改
  • 持久世界:鏡頭外的物件與潛在狀態不再被遺忘,長時序互動更可靠
  • VLM agent 自動生成世界規格:以參考圖加文字描述即可寫出可執行的世界規則
  • 尚待補完:推理程式碼與預訓練權重仍未釋出,目前以技術報告形式呈現

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 世界模型, Video, Image, 框架, 3D

RoboSPA 用 280 個難度變體幫你壓力測試

RoboSPA 是浙江大學團隊針對 Vision-Language-Action 模型推出的診斷式基準,透過逐步拉高空間歧義與程序步數,揭開現有機器人策略在精準定位與長程規劃上的短板。

Repository image for fanzhenxuan/RoboSPA

當 VLA(Vision-Language-Action)模型在乾淨、短任務的環境中跑出不錯的成功率,要怎樣才知道它是真正「理解」指令,還是只是剛好蒙對?RoboSPA 給出的答案是:把場景弄得更亂、把步驟拉得更長,然後看模型從第幾關開始崩潰。這是一個基準與數據集項目,建基於 RoboTwin 2.0 模擬框架(SAPIEN + CuRobo),由浙江大學主導,已獲 EMNLP 2026 收錄。

它把 56 個基礎任務各衍生出五個難度級別(L1–L5),共 280 個變體,覆蓋五種機械臂實體(Franka、Piper、UR5、Aloha-AgileX、ARX-X5),總計 527K 條軌跡、約 108M 步數、997 小時互動影片。Spatial 維度持續加入外觀相近的候選物,Procedural 維度則逐步疊加子目標、執行順序、重複次數與記憶需求。

與只看最終二元成敗的傳統做法相比,RoboSPA 額外提供兩個診斷指標:空間任務用 ONTA(Object-Normalized Target Accuracy) 衡量模型能否在「看起來都像」的物件中選對目標,並以 chance-corrected 方式扣掉隨機命中;程序任務則用 Progress Score(PS) 計算實際完成的子目標比例,反映模型在中途卡住或跳步的真實狀況。

適合機器人實驗室、VLA 模型開發者,以及需要評估策略可擴展性的團隊。支援自帶策略接入,數據與代碼均已公開。研究端在多個代表性 VLA 模型上的結果顯示,空間關係、低階精細動作與長程記憶仍然是明顯瓶頸。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, Video, VLA, 框架, 中國, Dataset 數據集

Marigold V2:把擴散 Transformer 改成一步深度估計模型

只要一張普通 RGB 相片,就即時輸出高質素深度圖,連毛髮和髮絲等幼節都保留到。Marigold V2 把預訓練擴散 Transformer 改造為單步密集預測模型的開源項目,一張消費級 GPU 一星期內就能完成微調。

Project website

過去做單目深度估計,要麼靠傳統監督學習,要麼用擴散模型疊好多步去噪,兩者都唔易兼顧細節同效率。華為 Bayer Lab 開源 Marigold V2 走第三條路:直接把預訓練嘅擴散 Transformer(DiT)當成單步密集預測器,重新微調之後輸出深度、透視深度、法線、反照率等多種密集模態,毋須反覆去噪。對從業人員嚟講,呢個改動意味住一張普通 RGB 相可以即時變成帶細節嘅深度圖,毋須等幾秒去疊步驟,毛髮邊緣同髮絲呢類幼節都保留得到,貼近 SOTA 水準。

模型家族同訓練成本:每個 checkpoint 包含一組 rank-128 LoRA 適配器,配合 4-bit 量化嘅 DiT 主體,個別任務仲會附帶微調過嘅 VAE 解碼器。底層凍結嘅基礎模型會另外下載。整個微調流程用單張消費級 GPU 少於一星期就完成到,對個人開發者同細型實驗室都係可觸及嘅範圍。

程式碼結構清晰,方便二次開發:倉庫用 manifest graph 加 transform list 嘅方式定義數據集,網絡組件同損失函數都係讀寫 batch dict 嘅有序步驟,數據集定義、網絡圖、損失圖、優化排程四個層次分得幾開。對想擴展到新任務嘅人嚟講,只要跟住呢個結構加步驟就得,唔使由零砌起。

對比傳統多步擴散深度估計,Marigold V2 犧牲咗迭代式去噪嘅靈活性,但換嚟一步推理嘅速度同細節還原度;對比純監督方法,佢借用咗擴散模型對紋理同邊界嘅先天理解力,再加 LoRA 保持輕量。同一批權重仲可以用喺 metric depth completion 等下游任務,一個模型覆蓋多個密集預測場景。

**適合做 AR/VR、3D 重建、影像合成嘅中小團隊,或者想低成本試驗新密集預測任務嘅研究者,都會覺得呢個 setup 幾啱手。HuggingFace 上有對應嘅 demo 空間可以直接試,權重同訓練推理碼都已開源。

項目主頁 · GitHub · 模型

Categories: 開源, 華為, 模型, 模型訓練, Qwen, Image, 3D, , Dataset 數據集

Page 5 of 92
1 3 4 5 6 7 92