HRM-Text 把基礎模型預訓練門檻壓到千美元級

想自己預訓練文字模型,通常先被算力同數據成本勸退。HRM-Text嘗試把呢道門檻大幅壓低,連完整訓練流程都一併開放。

banner

最值得留意的地方,不是又多一個 1B 級文字模型,而是有人把「由零開始預訓練 foundation model」整理成一個可落地的開源項目。HRM-Text 屬於模型加訓練框架類型,處理的是中小團隊想自建文字生成模型時,算力、數據量同工程門檻都過高的問題。

它採用 Hierarchical Recurrent Model(HRM)架構,並加入 task completion 同 latent space reasoning,重點不是單純追更大參數,而是用 hierarchical recurrent architecture、PrefixLM sequence packing、FlashAttention 3 同 PyTorch FSDP2,把預訓練成本壓到傳統做法的 130 至 600 倍更低算力需求,以及 150 至 900 倍更低數據需求。呢個取捨很鮮明:換來的不是萬能部署環境,而是一條偏向研究與訓練端、對 Hopper-class GPU 仍有明確要求的路線。

部署同測試方式亦算完整。儲存庫已包含 training、checkpointing、evaluation,同 checkpoint 轉成 Hugging Face Transformers 格式的工具,配合 companion 的 data_io 管線準備 tokenized data 後,就可以按單節點或多節點方式開跑;不過 native Transformers 支援要等下一個 release,native vLLM 支援亦仍在進行中,所以現時較適合想重現訓練流程、驗證成本結構,或者研究 HRM 架構本身的團隊。

參考跑分不算保守:0.6B 版本用 8 張 H100、約 50 小時,GSM8k 有 77.6%,MATH 51.2%;1B 版本用 16 張 H100、約 46 小時,GSM8k 提升到 84.7%,MMLU 60.7%,ARC-C 81.9%。呢啲數字未必代表它已經適合所有產品化場景,但足以證明這條路不是紙上談兵,尤其對大學實驗室、國家語言模型計劃,或者想為小語種、自有語料建立 base model 的團隊,有相當現實的吸引力。

  • 把 foundation model 預訓練成本壓到約千美元級,重點在完整流程而不只是一個模型權重
  • 同時提供訓練、評估、checkpoint 轉換工具,方便重現與延伸研究
  • 目前較依賴 H100 等 Hopper-class GPU,部署彈性未算完全成熟
  • 適合研究機構、語言科技團隊,同要自建基礎模型能力的項目
  • 原生 Transformers 與 vLLM 支援仍在補齊,短期內較偏訓練端使用

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Python, Dataset 數據集

LittleLearner 把語言模型的知識邊界控制在小學五年級

LittleLearner 透過受控課程資料訓練模型,研究能力究竟來自學習,還是只是被提示引出。

Hero image preview

模型能否回答問題,不一定代表它真正學過相關知識。LittleLearner 將語言模型(Language Models,LMs)的預訓練資料限制在美國小學 K–5 課程,建立一個可觀察知識邊界的研究沙盒,讓研究者分辨能力是從資料中獲得,還是只是在提示下被引出。

項目的核心是 LittleCurriculum,一個由 FineWeb-Edu 蒸餾而成、約 880 億個 token 的語料庫。資料經過五階段篩選,並按照 Common Core standards 對齊,明確排除五年級以上教授的概念、事實和詞彙;模型則從零開始訓練,並配備使用相同架構、token 數量和訓練配方的 Unfiltered control,方便作出乾淨比較。

LittleLearner 提供 0.6B、1.3B 和 5B 三種規模,另有 Base、GRPO 及 Chatty 版本。研究測試 scaling、SFT+GRPO post-training 和 in-context learning 後發現,這些方法可以放大課程範圍內的能力,卻未能明顯提升範圍以外的表現,顯示預訓練資料可能設定了有效能力上限。

重點包括:
– 88B-token LittleCurriculum 將知識暴露範圍控制在 K–5 課程
– 三種模型規模均設有匹配的 Unfiltered control
– scaling 可改善課程範圍內表現,外推能力只有限度增加
– SFT+GRPO 和 in-context learning 未能突破知識邊界
– 網頁提供 5B 模型的瀏覽器聊天介面、Dataset 和 Model checkpoints

對研究模型能力來源、知識遷移和 post-training 效果的人,LittleLearner 提供了較容易重現和比較的實驗基礎;對一般使用者而言,瀏覽器內的 live chat 則可直接感受一個受控知識範圍模型的回答方式。

項目主頁 · 模型

Categories: 開源, 模型, 模型訓練, Dataset 數據集, Skill 技能

SimpleOPD 把長思維蒸餾帶到異 tokenizer 學生模型

長上下文教師模型唔難找,難的是點樣穩定轉移到短上下文學生模型。SimpleOPD聚焦呢個落差,做法比一般蒸餾更貼近訓練現場。

Repository image for hhnqqq/SimpleOPD

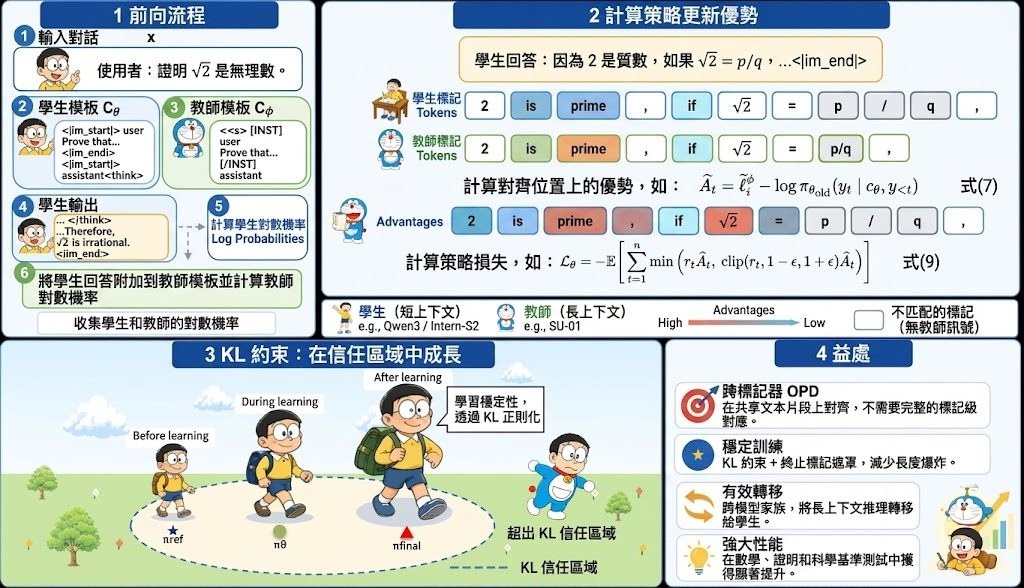
想把長上下文推理能力交到較細、較短上下文的學生模型,卡位往往唔係只有模型強弱,而是 tokenizer 不同、輸出愈蒸餾愈長,最後連訓練都變得唔穩。SimpleOPD屬於模型訓練方法項目,處理的是 long-context reasoning teacher 到 short-context student 之間的 On-policy distillation(OPD)轉移,重點放在跨 tokenizer 仍然可以學到推理能力。

它冇硬做 token-level 對齊,而是改在 shared text space 對齊,只監督師生 tokenizer 剛好切出相同文字跨度的位置。呢個取捨很務實:少了強行對齊帶來的噪音,代價是可監督位置會收窄,但換來 arbitrary teacher-student tokenizer combinations 也能成立,對 Qwen3、Qwen3.5、Intern-S2、GLM-4.7、Gemma4 這類不同家族學生模型都更有通用性。

另一個關鍵,是它直接處理「答案愈生愈長」這個訓練現象。SimpleOPD加入 student-reference KL loss,再對 </think><|im_end|> 這類終止 token 做 advantage masking,目的不是單純加正則化,而是壓住學生模型偏離初始 policy 太遠,減少 teacher-student distribution mismatch、截斷率上升與訓練失穩。

  • 支援 long-context teacher 產生 100K+ token reasoning chains
  • 以 shared text space 對齊,避開 tokenizer 不一致帶來的蒸餾障礙
  • 透過 student-reference KL loss 與終止 token masking 控制長度膨脹
  • 在 ProofBench 對 Intern-S2-Preview 帶來 +21.2 分,升至 55.2
  • 結果已超過 Gemini-2.5-Pro,並提到對 HLE、HiPhO 也有外溢收益

它不是即裝即用的線上服務,而是偏研究與訓練流程的開源項目;環境依賴 SLIME 0.2.3、Python 3.10+、PyTorch 2.0+,並為 GPU、HTTP-based teacher inference、timeout、concurrency、batch processing 留好接口。受益最大的會是做蒸餾訓練、想把強教師推理能力壓到較易部署學生模型的團隊,尤其是要跨 tokenizer、又不想被超長 reasoning chain 拖垮訓練穩定性的情境。

項目主頁 · GitHub

Categories: 開源, Qwen, OpenAI, Gemini, Python

S²VOPD 讓小模型看少一點,Qwen3.5-4B 反而看得更準

S²VOPD 透過削弱學生模型的視覺資訊,在零標註下提升細粒度感知與數學推理表現。

UC San Diego

小模型面對圖片時,減少它能看到的資訊,竟然可以帶來更好的學習訊號。Self-Supervised Visual On-Policy Distillation(S²VOPD)是一種視覺模型訓練方法,透過讓學生模型觀看低解析度、加入隨機 Gaussian noise 的圖片,處理沒有標註、獎勵或更強教師模型可用的限制。

訓練期間,學生模型會根據受干擾的圖片產生回答;採用 Exponential Moving Average(EMA)的教師模型則以原始圖片評分相同的生成前綴,再利用 top-k generalized Jensen-Shannon divergence(JSD)把較完整的 token 分佈傳給學生。教師與學生之間的資訊差異,來自學生少看一點,而不是額外加入 privileged information。

• Qwen3.5-4B 在六項細粒度感知基準的平均準確率,由 70.7% 升至 77.4%
• 4B 模型表現高於 Qwen3-VL-Instruct-235B 的 75.8% 和 GPT-5.4 的 72.8%
• 不需要 labels、rewards、region annotations 或更強教師模型
• 4B 同時提升感知表現 5.7% 和數學推理 3.7%

S²VOPD 使用學生視角縮放至原圖 0.3 至 0.6 倍,並加入 stochastic Gaussian noise。結果顯示,這種做法不只改善視覺感知,也能避免部分 privileged-information 方法在數學推理上的退步;例如 Oₚₛd 和 ZwZ 在部分 MathVision、MathVerse 測試中出現明顯下降。

這項方法較適合研究小型多模態模型訓練、視覺推理和自監督學習的讀者。現有結果集中於六項細粒度感知基準及數學推理測試,能否穩定延伸至其他資料、模型架構和更複雜影像任務,仍需要進一步驗證。

項目主頁

Categories: 開源, 模型訓練, Qwen, Image, Dataset 數據集

MMDiff 以特徵差分操控多模態模型行為

MMDiff 把文字模型同多模態版本之間嘅差異拆開,找出受視覺訓練改寫嘅特徵,再用嚟削弱或引導模型行為。對做多模態安全、空間推理同 OCR 嘅團隊,佢提供咗一條可解釋又可干預嘅路。

MMDiff

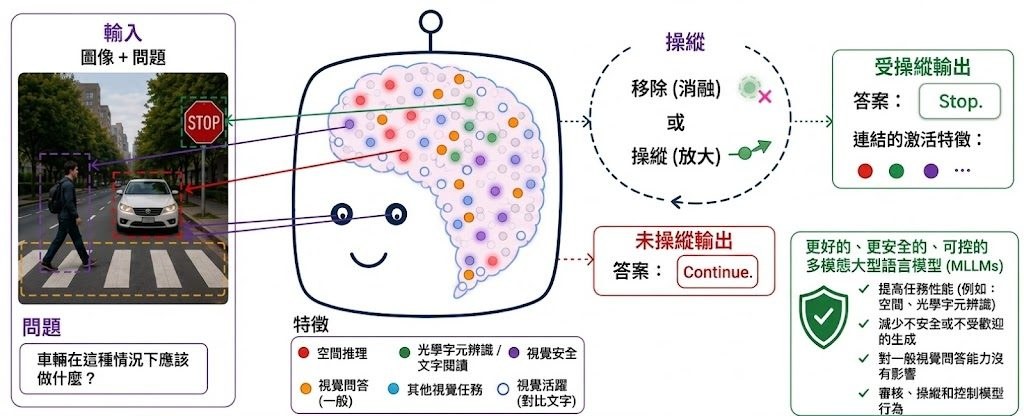
MMDiff(Multimodal Model Diffing)係一套研究型方法,處理嘅問題唔係再訓練模型,而係先睇清楚多模態大型語言模型(Multimodal Large Language Models, MLLMs)入面邊啲特徵因為視覺訓練而改變,再將呢啲特徵移除或引導。對要做審核、除錯、對齊行為嘅團隊,呢種做法比單靠黑盒輸出更實用。

佢嘅核心做法係將基礎語言模型嘅 sparse autoencoder(SAE)同多模態 SAE 對齊比較,再用 contrastive per-token firing 去揀出任務相關特徵。之後可以做 causal removal,或者用 MMDiff-CAA 喺相關層面 steering,直接改變模型喺空間推理、OCR 同安全場景嘅輸出傾向。

項目提供咗對應嘅 SAE checkpoints,亦有針對 LLaVA-MORE、PaliGemma 2 同 InternVL3.5 嘅結果。作者做咗視覺空間理解、多模態安全同 OCR 評測,指出移除單一特徵可令目標能力下降,同時一般 VQA 受影響好細,顯示呢套方法唔係純觀察,而係真係可以做定向控制。

  • 可用嚟定位多模態訓練改寫咗邊啲特徵
  • 可以將特定行為削弱,而唔一定要重訓整個模型
  • 對做 OCR、空間推理、模型安全審查嘅團隊特別有用
  • 測試結果顯示,目標能力下降明顯,一般 VQA 干擾相對細
  • 方法可跨幾個 MLLM 家族轉用,唔只限單一模型

項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 微軟

MobileMem 把手機長期記憶放入真實場景測試

手機助手要記住一年的生活,難點不只是搜尋資料,更要理解跨應用、跨模態的長期脈絡。

logo

手機助手若要回答「女兒七歲生日有哪些照片」或核對過敏藥物,單靠短對話記憶很快會失準。MobileMem 屬於端側長期記憶(on-device long-term memory)的評測框架與資料集,將一年手機經歷整理成可重現的測試環境,檢驗記憶系統能否跨應用保留、連結及找回重要資訊。

它涵蓋 365 天、12 個應用程式,以及每位使用者平均 1.72M tokens 的資料規模,來源包括對話、日曆、筆記、瀏覽紀錄和相片等異質內容。與只測單輪問答或獨立文件檢索的做法相比,MobileMem 更接近長期使用情境,但同時令資料整理、隱私處理和推理成本變得更複雜。

資料分為兩條 benchmark track:text 供文字記憶系統處理長期對話與結構化 mobile-app events;omni 則加入 screenshots 和 photos,測試多模態記憶。它本身不是模型,而是用來比較不同 memory systems、分析失敗原因及建立 leaderboard 的測試基礎。

  • 支援文字與多模態兩類測試
  • 涵蓋跨應用、長期且知識密集的 mobile agent trajectories
  • 可從 HuggingFace 下載資料集
  • Dataset Explorer branch 提供互動式資料瀏覽
  • 現有資訊未列出具體模型分數,需查看 leaderboard 或自行重跑測試

研究人員可先下載 HuggingFace 資料集,按 text 或 omni 軌道接入自己的記憶模型,再利用網站和 Dataset Explorer 檢查案例。適合開發 mobile agents、personalized assistant、長期 RAG 或 multimodal memory 的團隊;涉及健康紀錄、家庭相片等私人內容時,仍要自行確認資料授權、匿名化和端側部署要求。

項目主頁 · GitHub

Categories: 開源, Agentic, RAG, 多模態模型, Medical醫學, 中國, Dataset 數據集

HumanTracker 想解決人形動作評測失真

影片睇落穩唔穩,未必等於關節誤差低。HumanTracker把人類偏好納入評測,補回人形動作追蹤最常被忽略的一段。

HumanTracker

只看關節角度誤差,往往會把腳滑、落地時機錯、支撐不穩這些觀感上很明顯的問題沖淡。HumanTracker屬於資料集加評測工具類型,核心不是再做一個追蹤模型,而是替 humanoid motion tracking 建立更貼近人眼判斷的 benchmark,讓 teleoperation 與 whole-body imitation 的結果不只「數值過關」,影片也更可信。

它的價值在於同時補兩個缺口:一邊擴大測試覆蓋,另一邊重寫評分方法。項目收錄約 153 小時光學動作資料、來自 24 位專業表演者,整理成四類動作家族,專門拉開日常步態、高動態、互動動作與接地穩定性之間的差異;再用 12K human-labeled preference pairs,訓練出偏好對齊的 HumanScore,去判斷哪條 tracker trajectory 更接近人會接受的效果。

跟 MPJPE 這類逐幀 kinematic 指標相比,HumanScore 重點不在每一幀有幾準,而在整段軌跡有沒有出現長時間滑步、抖動、漂移與失去平衡。官方提供的結果顯示,HumanScore 在測試集對人類偏好的對齊率達 90.83%,比較強的傳統診斷指標高 6.78 分;README 亦保留 Succ、MPJPE 與 HumanScore 幾種分數,代表它不是取代舊指標,而是把「物理上站不站得住」這件事補回評估流程。

  • 約 153 小時新採集 optical motion,涵蓋 25K 級別標註片段
  • HumanScore 來自 trajectory reward model,學的是人對整段動作的偏好
  • 儲存庫提供 evaluation harness、HumanScore reward model 同數據處理工具
  • 適合做人形機械人追蹤、模仿學習、teleoperation 評測的研究團隊使用

這個 GitHub 儲存庫比較像研究評測基建:重點是下載資料集、跑 evaluation harness、再用 HumanScore 與傳統指標一起看結果,而不是即開即用的終端產品。受益最大的會是做人形控制、動作追蹤與模仿策略比較的團隊,因為它能幫你分辨模型究竟只是把姿勢角度擬合得好,還是真的把接觸、穩定與動作連貫度處理好。限制也很明確:它主要提升的是評測可信度,不等於直接改善 tracker 本身能力。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, World-Action Model, Dataset 數據集

RA-Bench 直指危機假影片檢測盲點

危機事件影片最麻煩之處,不是合成得花巧,而是看起來太像真。RA-Bench把檢測器拉回真實傳播場景,專門測試這個落差。

RA-Bench: Can we defend against generated crisis videos?

當一段災難、戰事或公共事故影片本身已有真實事件做錨點,檢測器往往無法只靠內容違和感分辨真偽。RA-Bench屬於影片檢測基準資料集,針對的正是 AI 生成危機影片貼近真實新聞片段後,現有偵測方法還能否守得住。

它的做法有一個關鍵判斷:不再拿脫離情境的合成片去測,而是把真實危機影片與對應生成版本配對,並且涵蓋四個開源與五個閉源生成器。資料規模有 17,886 段影片,當中包括 1,830 段 real anchors、16,056 段生成片,另設 RA-Bench-HumanProof 與 RA-Bench-LastMile,前者收錄連人工審查者都一致誤判為真的 633 段影片,後者再測試影片經過連續傳播處理後,檢測器會否失準。

這個項目把「像真」、「會誤導人」、「經社交傳播後失真」三件事放在同一套測試裡。相對於只看配對樣本的資料集,它多了一層來源泛化與傳播鏈穩健性的要求;代價是資料權限較複雜,完整版本有部分 real anchors 只提供原始 URL,未必人人都能直接重跑 full 軌道。

  • public-media 只評估可重新分發的真實錨點配對,較適合公開重現與初步比較
  • full 依照完整論文清單評估,也要求處理只提供 URL 的真實來源
  • Hugging Face 釋出公開媒體約 93.8 GB,生成影片完整提供,真實素材則經權利審核後部分保留來源連結
  • 評估採用 source-matched evaluation,會把每個生成來源放回其對應真實錨點脈絡判斷

對做影片鑑識、內容審核、新聞驗證與多模態安全研究的團隊,RA-Bench的價值很直接:它不是教模型辨認「很像假片的假片」,而是逼它面對會在人類審查與傳播流程中混過去的片段。限制也同樣清楚,這仍是 benchmark,不是現成檢測器;要得出可比較結果,仍要先準備預測輸出、下載資料,並處理部分真實來源無法重分發的存取條件。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 多模態模型, OpenAI, Video, Dataset 數據集

playwright-skill 技能讓代理即寫即跑瀏覽器流程

這個項目把 Playwright 自動化包進 Agent Skill,適合要把瀏覽器操作變成可重跑程式的場景。它偏向 code-first,重點是把測試、截圖、網絡攔截和多步流程直接交給代理生成。

Repository image for lackeyjb/playwright-skill

面對要反覆驗證頁面流程、抓截圖、做網絡攔截,或者把操作保留下來重跑的情境,這個項目提供的是一套給 coding agents 用的 Playwright 自動化技能,並同時包成 Claude Code Plugin,安裝與接入都比較直接。

它不是單純的瀏覽器控制工具,而是讓代理按需要寫出真正的 Playwright 程式,再即場執行。官方也明講,若只是一般互動式瀏覽,Playwright CLI 或 playwright-mcp 會更合適;這個項目更適合 code-first 工作流,當自動化本身就是要保留的產物。

安裝方式以 Vercel 的 skills CLI 為主,支援全域或指定項目安裝;結構上把 skill 放在 plugin 的 skills 目錄,方便不同 agent 讀取。它也主打可見瀏覽器預設開啟、穩定的模組解析、臨時檔安全清理,以及按需載入完整 API,減少代理一次讀入太多內容。

  • 適合要寫、執行、重跑 Playwright 腳本的工作流
  • 支援單步頁面測試,也支援多步流程與多個 context
  • 可用於 screenshot、video、network interception 等任務
  • 和純工具式控制相比,更重視可保存的程式碼結果
  • 受益較多的通常是做自動化測試、爬取流程驗證、代理工作流的人

整體看來,這個項目把「讓代理操作瀏覽器」提升成「讓代理產出可維護的 Playwright 程式」。它的價值不在於包辦所有瀏覽器需求,而在於把可視化執行、程式化控制和可重用性放到同一條工作流裡。

GitHub

Categories: 開源, Agentic, MCP, API, 編程, Skill 技能

MiniMax-H3-Text-Embeddings ?

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。

Og image

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。MiniMax-H3-Text-Embeddings 實際上是 DiffSynth-Studio 團隊為 MiniMax-H3 影片生成大模型所設計的「視覺特效/風格控制向量(Diffusion Templates / Textual Inversion)」。

MiniMax-H3 是一個高達 33B 參數的大型多模態生成模型,若要透過訓練 LoRA 來控制風格或特效,顯存與算力成本非常高。DiffSynth-Studio 團隊採用了類似 Textual Inversion(文字翻轉/概念嵌入) 的做法:

  1. 極輕量替代方案:將特定特效(如火爆、風暴、環繞鏡頭等)預先訓練或編碼成特徵 Tensor。
  2. 直接注入文字特徵層:這些檔案體積非常小,能在推理階段直接替換或疊加到 MiniMax-H3 的 Text Encoder 輸出上。
  3. 模組化與組合:使用者可以像掛載外掛一樣,組合多個特效 Embedding 來控制生成的影片視覺效果。

3. 總結建議

  • 如果你是在找 RAG / 知識庫 / 搜尋用的文本嵌入模型:請忽略此模型,這不是向量檢索工具。
  • 如果你是在使用 DiffSynth-Studio 進行 MiniMax-H3 影片生成:這是用來快速套用影片特效、節省顯存並替代重型 LoRA 的控制模組。

項目主頁

Categories: 開源, RAG, Embedding, 視頻模型, MiniMax

Page 19 of 92
1 17 18 19 20 21 92