想交低指示後由 AI 繼續處理雜務,Gemini Spark 就是朝這個方向而來。它把電郵、文件、搜尋與排程串連起來,減少你反覆催促。
最易理解 Gemini Spark 的方式,是把它看成一個會在背景持續運作的 Agentic AI 助手:你先交代目標,它再慢慢把零散工序接起來,處理那些花時間、又不想不停重複提示的工作。Google 已在香港推出這項服務,定位很清楚,就是幫用家把日常行政與資料整理自動化。
它接上的重點,不是單次問答,而是整段工作流。Gemini Spark 運行於 Google 的雲端基礎設施,能原生連接 Workspace 工具,例如 Gmail 和 Docs,毋須另外設定,就可以整理混亂的電郵往來、彙整行業消息、從舊文件抽資料做後續安排,甚至進行網上資料搜集、比較選項與完成預訂。
Google 提到,系統以 tasks、custom skills 和 schedules 這類機制去安排工作,讓用家用自然語言交代規則、例行事項與時間觸發條件,毋須寫程式。另一個分別在於,它不會因為你闔上手提電腦或鎖上手機就停下來,背景流程仍可繼續運作,較適合需要長時間跟進的文書與研究工作。
支援背景持續執行,不用反覆重新提示
可原生連接 Gmail、Docs 等 Workspace 工具
能處理資訊整理、排程準備、網上研究與預訂類工作
高風險動作前會先要求明確同意
控制權仍然留在用家手上。Google 表示,Gemini Spark 會按照用家指示運作,用家可決定何時啟用,以及容許它接觸哪些應用程式;遇到交易或發送電郵等高風險操作,系統亦會先徵求明確授權。現時香港由 Google AI Ultra 訂閱用家率先使用,Google AI Pro 用家的開放時間會在未來數星期逐步擴展。
想知道大型語言模型點解會用某種語氣答你、點樣處理敏感內容,最直接的方法之一,就是看它背後的 system prompt。這個 GitHub 項目整理了疑似來自 Anthropic Opus 的提示詞內容,重點不在功能展示,而在於把模型行為規則攤開,讓人看到回應風格、安全邊界與工具使用指令可能如何被設定。
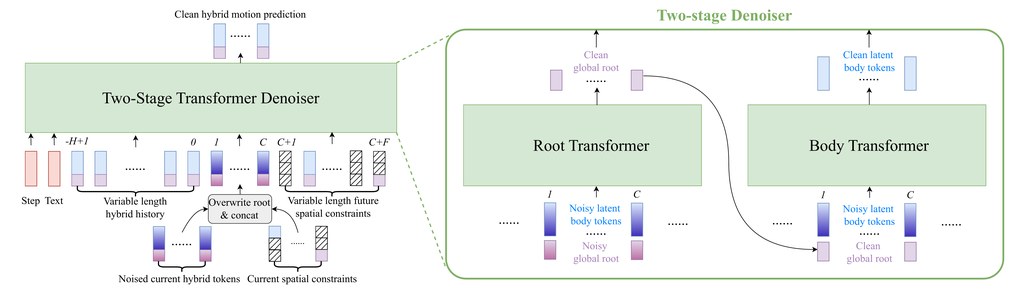
一邊輸入文字、一邊指定角色要去邊、幾時抬手或者身體要擺成咩姿勢,系統仍然可以即時生成自然動作;ARDY瞄準的正正是呢種互動式 3D human motion generation 場景。呢類能力對動畫、模擬同 humanoid robotics 都重要,因為傳統離線方法雖然控制精準,但速度未必跟得上互動需求;純即時方法又常常在語意理解、長距離目標同約束服從度上打折扣。
ARDY 採用 autoregressive diffusion model,同時配合 hybrid representation,把角色移動軌跡相關的 root features 同 latent body embedding 結合。咁樣做的用意很直接:一方面保留對路徑與朝向的明確控制,另一方面維持生成模型學習複雜全身動作時的效率與彈性。配合 two-stage autoregressive transformer denoiser,同一套框架可以處理 online text prompting,亦能接住較長時間範圍的 kinematic constraints。
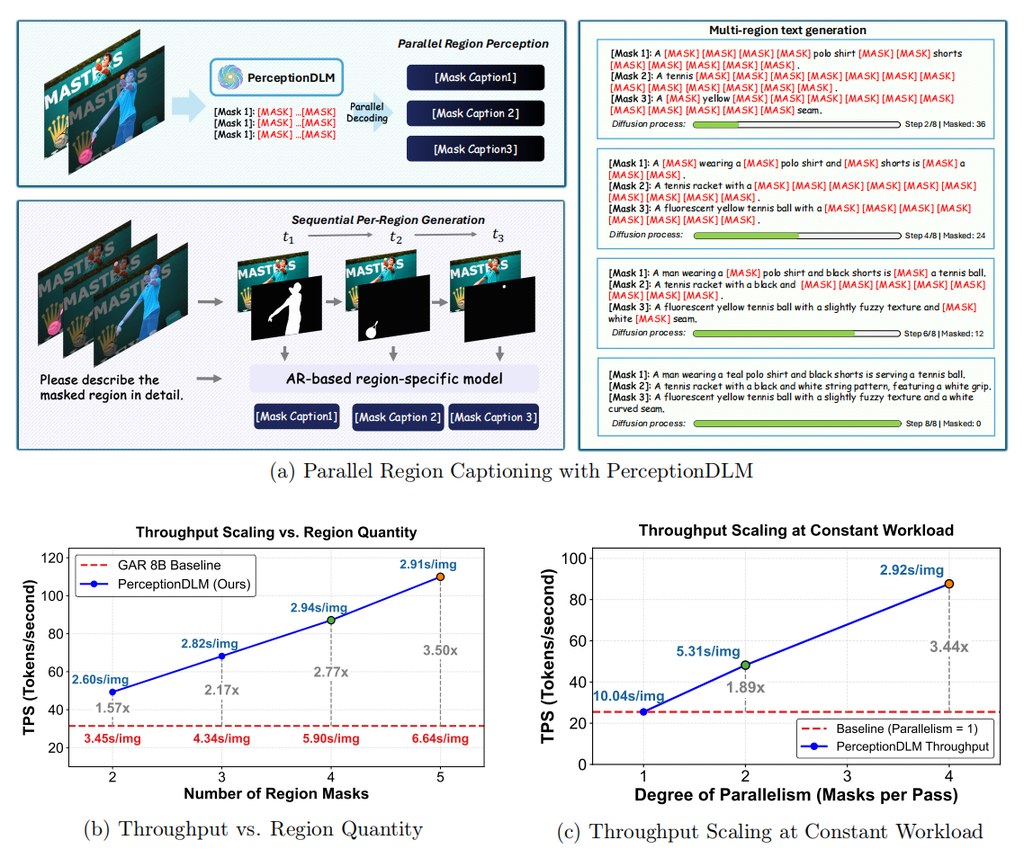
現時不少 Multimodal Large Language Models (MLLMs) 做區域描述時,仍然依賴 autoregressive (AR) 逐段生成:一張圖有幾多個 mask,就要逐個區域慢慢解讀。PerceptionDLM 提出的方向很明確,改用 Multimodal Diffusion Language Model,同一輪 denoising process 內同時輸出多個區域描述,目標是解決多區域感知在延遲上隨數量線性上升的問題。