OmniShotCut 在鏡頭邊界偵測任務的最新技術

OmniShotCut 以其多功能的轉換器模型革新了鏡頭邊界偵測。對於追求精確度的影片編輯師和研究人員來說,這是理想的選擇。

logo

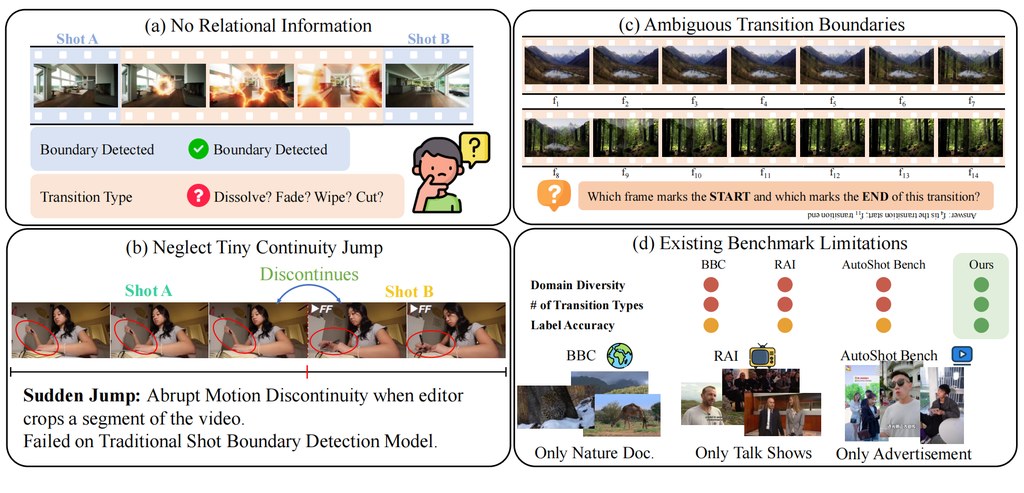
OmniShotCut 作為一種先進的解決方案,在各種類型的影片中都能出色地偵測鏡頭邊界,從動畫到體育轉播皆適用。該工具採用基於鏡頭查詢的影片轉換器,與傳統方法相比,提供了更高的靈敏度和資訊豐富性。處理多樣化影片來源的影片編輯師、內容創作者和研究人員應該考慮使用 OmniShotCut,因為它能夠準確識別突兀的跳接和微妙的轉場如溶解和漸變。對於初次使用該工具的人,首先理解鏡頭查詢機制的核心概念可以提供堅實的基礎。這種方法使模型能夠有效地分析和分類影片中的不同類型的鏡頭變化,特別適合需要對影片編輯過程進行精確控制的專業人士。

實際上,OmniShotCut 通過其複雜的轉換器架構處理影片幀來運作。模型學習根據視覺線索和時間關係區分不同的鏡頭類型。用戶可以從這項技術中獲益良多,特別是在處理需要細緻編輯的大批量影片內容時。自動偵測這些邊界可以節省大量的時間和精力,讓編輯師能夠專注於創意方面而非手動分割。此外,本地 Gradio 介面的加入簡化了實驗和與現有工作流程的整合,即使對那些程式設計經驗有限的人也同樣易於使用。

OmniShotCut 的主要受益者是媒體製作專業人士、研究影片內容的學術研究人員以及從事影片分析應用的開發人員。這些群體可以利用該工具的能力來提升他們項目的品質和效率。然而,需要注意潛在的權衡。雖然 OmniShotCut 在準確性和多功能性方面表現優異,但用戶必須確保擁有足夠的計算資源以高效運行模型。此外,底層轉換器架構的複雜性可能對不熟悉深度學習概念的用戶構成挑戰。因此,基本的機器學習原則理解將會很有幫助。

為了最大化 OmniShotCut 的效益,用戶應從探索提供的 Gradio 示範開始。這種親手實踐的體驗可以提供對模型性能的洞察,並有助於理解其輸出。觀察的重點包括模型如何處理不同類型的影片以及其鏡頭變化偵測的準確性。透過實驗各種輸入影片,用戶可以對將 OmniShotCut 應用於特定需求充滿信心。此外,在推理過程中考慮 clean_shot 模式可以簡化結果,提供僅聚焦於有效鏡頭而無轉場或突兀跳接的乾淨輸出。

OmniShotCut 代表了鏡頭邊界偵測技術的重大進步。其堅固的設計和多功能應用使其成為任何處理影片內容的人的無價資產。儘管在計算需求和技術知識方面存在某些考量,但使用 OmniShotCut 的好處遠遠超過這些小障礙。隨著影片分析領域的不斷髮展,像 OmniShotCut 這樣的工具無疑將在塑造未來創新中發揮關鍵作用。

Source: https://github.com/UVA-Computer-Vision-Lab/OmniShotCut
Categories: 開源, 視覺模型, 視頻模型, 影像模型, 影像處理

NVlabs/Sana:SANA:使用線性擴散變換器進行高效高解析度影像合成:快速專案概覽

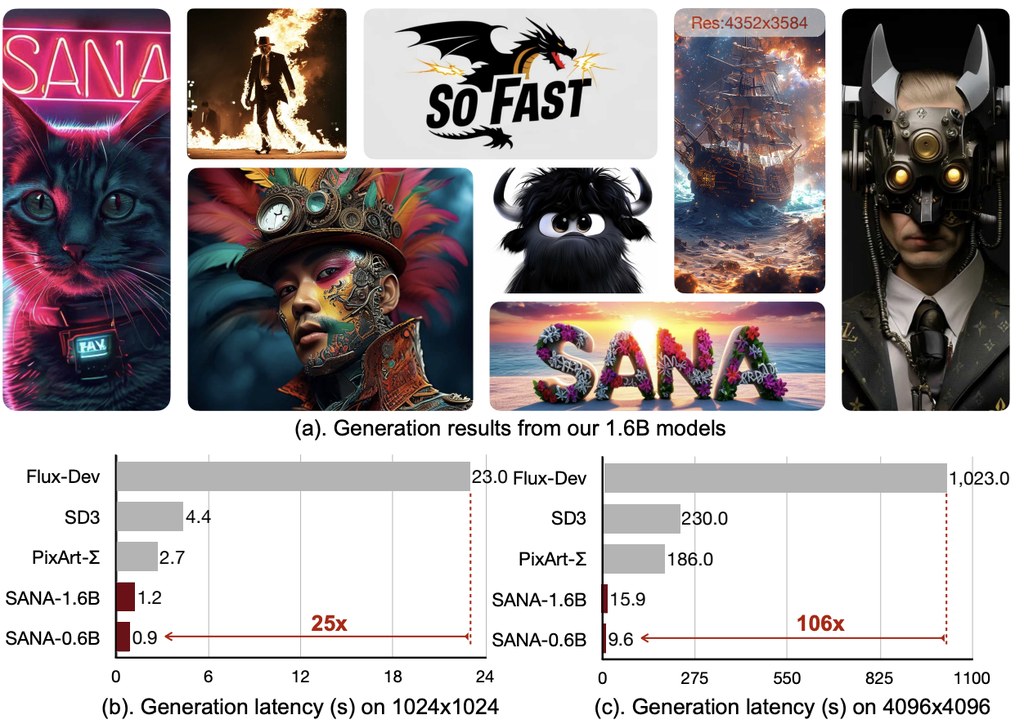
SANA 是一個以效率為導向的代碼庫,用於高解析度影像和視訊生成,提供完整的訓練和推理管道。此儲存庫包含 SANA、SANA-1.5、SANA-Sprint 和 SANA-Video 的代碼。

logo
來源:GitHub 上的 NVlabs/Sana

SANA 是一個以效率為導向的代碼庫,用於高解析度影像和視訊生成,提供完整的訓練和推理管道。此儲存庫包含 SANA、SANA-1.5、SANA-Sprint 和 SANA-Video 的代碼。更多詳細資訊可以在我們的 📚 文件中找到。

我們介紹 SANA ,一系列用於高解析度影像和視訊生成的高效擴散模型:

  • SANA :生成高達 4K 解析度的文本到影像,比 Flux-12B 小 20 倍且快 100 倍。
  • SANA-1.5 :在訓練時間和推理時間進行高效的計算擴展,以獲得更好的品質。
  • SANA-Sprint :透過 sCM 蒸餾進行一步/少步生成,在 H100 上每張 1024px 影像只需 0.1 秒。
  • SANA-Video/LongSANA :使用區塊線性注意力 / 配合 LongLive 進行高效的視訊生成。
  • 線性注意力 :在 DiT 中用線性注意力替換傳統注意力,以在高解析度下提高效率。
  • DC-AE :32× 影像壓縮(與傳統的 8× 相比)以減少潛在令牌。

來源:https://github.com/NVlabs/Sana (NVlabs/Sana)

Source: https://github.com/NVlabs/Sana

Categories: 開源, 香港大學, NVIDIA, 影像模型, 新聞

Gen-Searcher 準確同貼近現實圖片

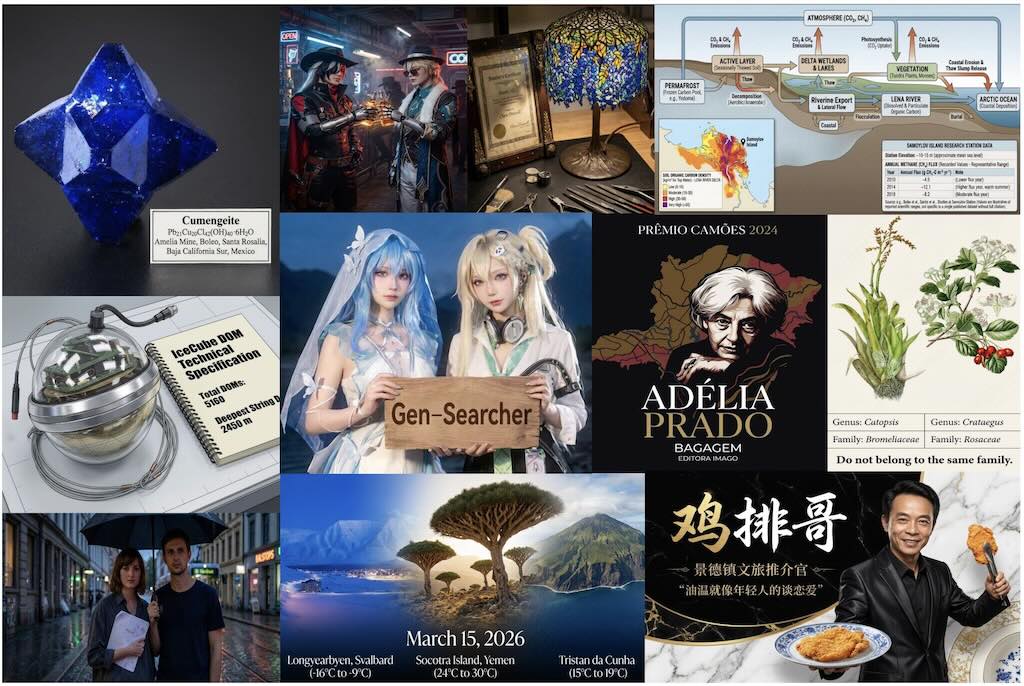
Gen-Searcher 係全球首個專為圖像生成設計嘅多模態深度研究代理,佢會先上網搜尋資料、瀏覽證據同埋搵視覺參考,先至開始繪圖。呢個模型透過專門嘅訓練數據同強化學習,令生成嘅圖片更準確同貼近現實。佢喺多個測試基準上表現出色,仲可以輕鬆轉移應用到唔同嘅圖像生成模型上。所有代碼、模型同數據都已經完全開源,方便開發者直接使用。影像產生使用Qwen/Qwen-Image-Edit-2509 和 FastAPI 進行服務。(MMLab, CUHK)

Gen-Searcher 係全球首個專為圖像生成設計嘅多模態深度研究代理,佢會先上網搜尋資料、瀏覽證據同埋搵視覺參考,先至開始繪圖。呢個模型透過專門嘅訓練數據同強化學習,令生成嘅圖片更準確同貼近現實。佢喺多個測試基準上表現出色,仲可以輕鬆轉移應用到唔同嘅圖像生成模型上。所有代碼、模型同數據都已經完全開源,方便開發者直接使用。影像產生使用
Qwen/Qwen-Image-Edit-2509 和 FastAPI 進行服務。(MMLab, CUHK)

Categories: 開源, 香港中文大學, 影像模型, , 中國

Matrix-Game 3.0 記憶增強世界模型

Matrix‑Game 3.0 是一個基於 Diffusion Transformer(DiT)的記憶增強世界模型,目標是做 720p 解析度、可達 40 FPS 的實時長序列互動視訊生成,用於第一人稱、第三人稱等遊戲/虛擬世界場景。它能根據滑鼠+鍵盤輸入一邊生成新畫面,一邊維持場景長時間的一致性(例如分鐘級序列),並可擴展到 2×14B 甚至 28B MoE 規模。 三大技術層面

Matrix‑Game 3.0 是一個基於 Diffusion Transformer(DiT)的記憶增強世界模型,目標是做 720p 解析度、可達 40 FPS 的實時長序列互動視訊生成,用於第一人稱、第三人稱等遊戲/虛擬世界場景。它能根據滑鼠+鍵盤輸入一邊生成新畫面,一邊維持場景長時間的一致性(例如分鐘級序列),並可擴展到 2×14B 甚至 28B MoE 規模。

三大技術層面

  1. Data Engine
    • 用 Unreal Engine 生成合成資料,加上對 AAA 遊戲的大規模自動錄製、與真實影片資料增強,產出高品質的 Video–Pose–Action–Prompt 四元資料
    • 這種「工業級無限資料機器」讓模型能學習大量互動式行為與視角變化。
  2. 記憶增強模型(Memory‑augmented DiT)
    • 基礎模型是一個統一的雙向 DiT,把過去的潛在畫面、當前加噪畫面與動作輸入(滑鼠/鍵盤)放在同一個架構裡。
    • 用 residual error buffer 收集預測殘差,再以「error injection」把誤差加回訓練,讓模型學會在長時間序列上自我修正,增強長時一致性。
    • 加入 camera‑aware memory retrieval,只撿選視角相關的歷史畫面作為記憶條件,用 Plücker 編碼處理幾何關係,並用一個「sink latent」(第一幀)錨定場景整體風格。
  3. 高效實時推論(Distillation + Quantization)
    • 採用多段式的自生成 few‑step distillation(基於 Distribution Matching Distillation),讓「學生模型」在訓練時就模擬實際的少量步數 autoregressive 推論流程,做到訓練與推論對齊。
    • 搭配 INT8 量化、輕量化 VAE 解碼器(MG‑LightVAE)以及 GPU 加速的記憶檢索,單個 5B 模型可在 8 張 GPU 上達到 720p @ 40 FPS,而 2×14B 模型則在更長時間和更複雜場景下表現更好。
Categories: 開源, 視頻模型, 影像模型

RealRestorer – 通用真實世界影像復原

RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。

RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。

Categories: 開源, 影像模型, 影像處理

Utonia – Point Cloud 的單一編碼器

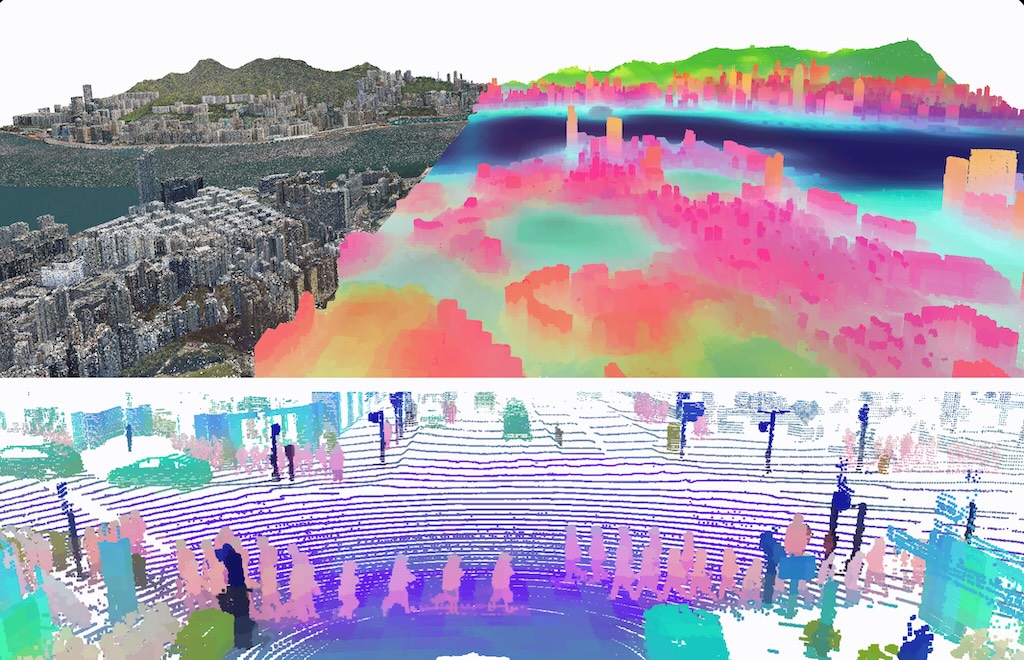
Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。 Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。 跨域資料混合:研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。

Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。

跨域資料混合
研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Categories: 開源, 香港中文大學, 影像模型, 影像處理

InteractAvatar 互動數字人

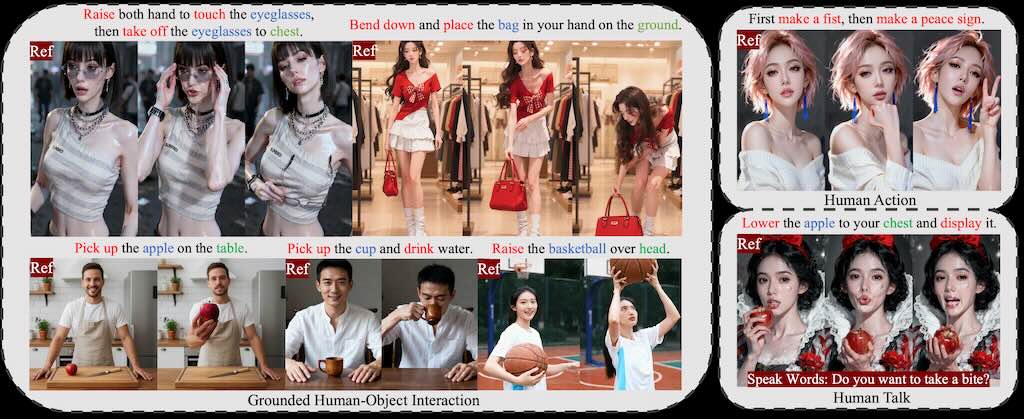
InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。 雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。

InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。

雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。

Categories: 開源, 騰訊, 數字人, 視頻模型, 影像模型, 影像處理

LongVie 2 – 可控超長影片生成

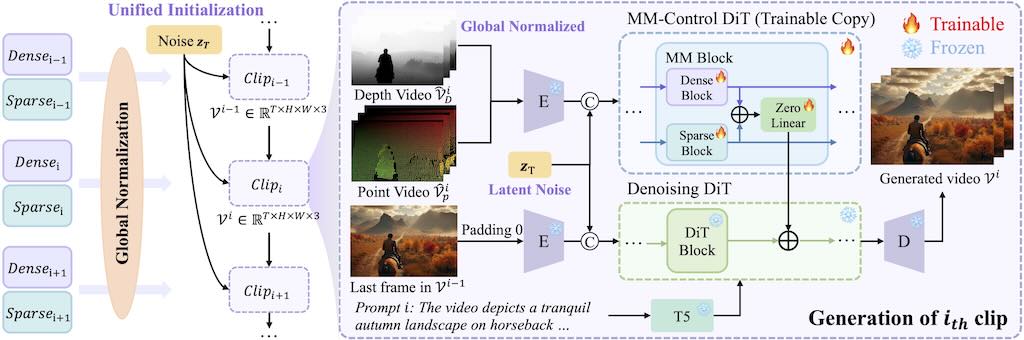
可控的超長影片生成是一項基礎但具有挑戰性的任務,因為現有的方法雖然對短片段有效,但由於時間不一致和視覺品質下降等問題而難以擴展。 LongVie 2 的核心設計可確保時間一致性:1)統一雜訊初始化策略,在各個片段之間保持一致的生成;2)全域控制訊號歸一化,可在整個視訊的控制空間中強制對齊。為了減輕視覺品質下降,LongVie 2 採用密集(例如深度圖)和稀疏(例如關鍵點)控制訊號,並輔以一種退化感知訓練策略,可以自適應地平衡模態貢獻以保持視覺品質。

可控的超長影片生成是一項基礎但具有挑戰性的任務,因為現有的方法雖然對短片段有效,但由於時間不一致和視覺品質下降等問題而難以擴展。

LongVie 2 的核心設計可確保時間一致性:
1)統一雜訊初始化策略,在各個片段之間保持一致的生成;
2)全域控制訊號歸一化,可在整個視訊的控制空間中強制對齊。為了減輕視覺品質下降,LongVie 2 採用密集(例如深度圖)和稀疏(例如關鍵點)控制訊號,並輔以一種退化感知訓練策略,可以自適應地平衡模態貢獻以保持視覺品質。

LongVie 2 : Multimodal Controllable Ultra-Long Video World Model
Categories: 開源, 模型, 多模態模型, 視頻模型, NVIDIA, 影像模型

DreamActor-M2 基於時空上下文動畫

DreamActor-M2 是一個通用的角色圖像動畫框架,它將運動條件化重新定義為時空上下文學習任務。我們的設計利用了視訊基礎模型固有的生成先驗訊息,同時實現了從原始視訊直接進行無姿態、端到端運動遷移的關鍵演進。這種範式消除了明確姿態估計的需求,使得DreamActor-M2 能夠在各種複雜場景中實現卓越的泛化能力和高保真度的結果。

DreamActor-M2 是一個通用的角色圖像動畫框架,它將運動條件化重新定義為時空上下文學習任務。我們的設計利用了視訊基礎模型固有的生成先驗訊息,同時實現了從原始視訊直接進行無姿態、端到端運動遷移的關鍵演進。這種範式消除了明確姿態估計的需求,使得
DreamActor-M2 能夠在各種複雜場景中實現卓越的泛化能力和高保真度的結果。

Categories: 開源, 字節跳動, 視頻模型, 影像模型, 影像處理

RBench and RoVid-X 機器人影片生成

RoVid‑X 號稱是目前最大規模的機器人影片生成開源資料集,約 400 萬 clips,覆蓋 1300+ skills / tasks,解析度達 720p,同時支援多樣機器人形態與多樣文字描述。RoVid‑X 主要解決現有 SOTA video diffusion / transformer 模型,在一般影片生成指標上不錯,但面對需要「因果一致、物理連貫」的機器人操作影片時,常出現物理錯誤、目標物體消失/瞬移、關節極限違反等問題。 RBench 旨在評估面向機器人的視訊生成的表現。它評估任務層面的正確性和視覺保真度。 雖然RBench為識別這些缺陷提供了必要的視角,但要實現物理上的真實性,還需要超越評估層面,解決高品質訓練資料嚴重短缺的問題。基於這些,他們引入了一個改進的四階段數據管道,由此誕生了 RoVid-X——迄今為止最大的開源機器人視頻生成數據集,涵蓋數千個任務,並富含全面的物理屬性標註。這項協同的評估和資料生態系統為視訊模型的嚴格評估和可擴展訓練奠定了堅實的基礎,加速了具身人工智慧向通用智慧的演進。

RoVid‑X 號稱是目前最大規模的機器人影片生成開源資料集,約 400 萬 clips,覆蓋 1300+ skills / tasks,解析度達 720p,同時支援多樣機器人形態與多樣文字描述。RoVid‑X 主要解決現有 SOTA video diffusion / transformer 模型,在一般影片生成指標上不錯,但面對需要「因果一致、物理連貫」的機器人操作影片時,常出現物理錯誤、目標物體消失/瞬移、關節極限違反等問題。

RBench 旨在評估面向機器人的視訊生成的表現。它評估任務層面的正確性和視覺保真度。 雖然RBench為識別這些缺陷提供了必要的視角,但要實現物理上的真實性,還需要超越評估層面,解決高品質訓練資料嚴重短缺的問題。基於這些,他們引入了一個改進的四階段數據管道,由此誕生了 RoVid-X——迄今為止最大的開源機器人視頻生成數據集,涵蓋數千個任務,並富含全面的物理屬性標註。這項協同的評估和資料生態系統為視訊模型的嚴格評估和可擴展訓練奠定了堅實的基礎,加速了具身人工智慧向通用智慧的演進。

Categories: 開源, 視頻模型, 影像模型, Robotic

Page 7 of 12
1 5 6 7 8 9 12