由一張相片、相片集合到影片片段,OneSearch-VL 會先定位視覺線索,再檢索外部知識,將相關證據組合成答案。它屬於多模態 deep research agent,處理的是影像內容理解與資料查證之間難以銜接的工作。
核心是 Visually Grounded Evidence Graph(VGEG),把視覺錨點、來源支持的事實和產生答案所需的操作連在一起。VGEG 亦支援資料建立及驗證;Evidence-aware Visual-Grounded Rubric reward(EVGR)則在強化學習中監督證據是否可追溯,以及答案有沒有真正對應影像內容。
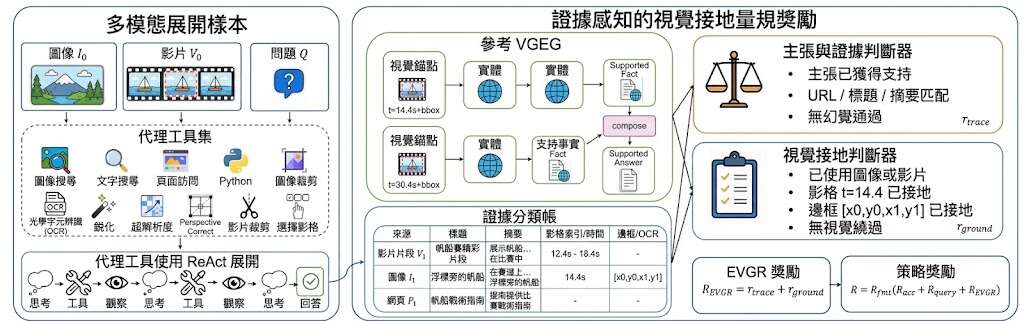
項目提供 OneSearch-MI-Bench 和 OneSearch-Video-Bench,分別面向多圖及影片研究能力。輸入資料未列出具體分數或模型名稱,因此不能把它描述成已全面勝過其他視覺研究方案;它較適合用作研究原型、訓練資料管線和 agentic workflow 的基礎。
OneSearch-VL 包含 Agentic SFT、Agentic RL、推理及評估相關目錄,並標示 Python 3.11+;先準備模型、資料集和外部工具,再執行訓練或評估流程。對需要查核圖片來源、比較多張圖片,或從影片整理證據的研究團隊,這種統一處理方式較容易整合到既有工作流,但部署成本和工具依賴仍要自行確認。
• 同時支援單圖、多圖集合及影片
• 以 VGEG 統一視覺線索與外部證據
• EVGR 強調證據可追溯及視覺對齊
• 提供多圖與影片專用 benchmark
• 支援 SFT、RL、推理和評估流程