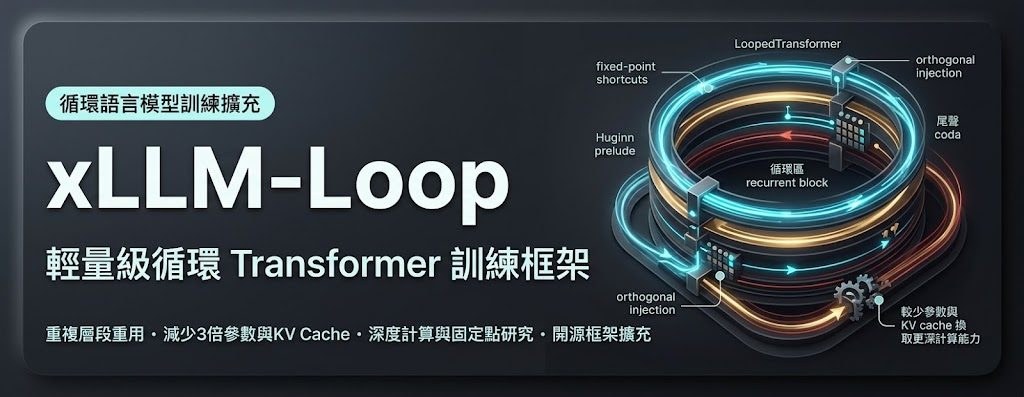
想用較少模型參數和 KV cache,換取更深的計算能力,xLLM-Loop 提供了一條可直接研究的路線。它屬於開源語言模型訓練框架擴充,處理的是循環語言模型如何重用層、控制深度,以及評估固定點帶來的效率取捨。
LoopedTransformer 會重複執行指定層段,Huginn 則把模型分成 prelude、recurrent block 和 coda,並支援單一或階層式 recurrent state。Part II 進一步研究 fixed-point shortcuts、learned depth prior 和 orthogonal injection,目標是在增加 FLOPs 時維持近乎固定的記憶體需求;相關說法包括較標準 Transformer 少約三倍參數和 KV cache,但不能視為所有任務都能達成的保證。
項目已接入 xLLM,提供兩篇研究工作的 training、evaluation 和 checkpoint 程式碼,並有 49 個 Hugging Face checkpoints。Part I 涵蓋 Dense 和 MoE 共 17 種 recipes、25 個 checkpoints;Part II 涵蓋 depth priors、input-injection variants 和 distilled prefill,共 24 個 checkpoints。
- 適合研究循環架構、固定點推理和參數效率的模型團隊
- 可比較固定、抽樣及 learned depth 的訓練方式
- 支援 LoopedTransformer、Huginn 和 DepthControlledHuginn
- 需要 PyTorch 2.11、CUDA 12.8、Python 3.12,實驗曾使用 NVIDIA H200
安裝方式沿用 xLLM,但硬件和軟件版本要求偏新,訓練成本亦不低,論文實驗是在 NVIDIA H200 上完成。對想在本地直接使用成熟聊天模型的人,它不是即裝即用的產品;對需要重現研究、載入 checkpoints 或改造訓練流程的團隊,程式碼、評估及 checkpoint 配套就更有價值。