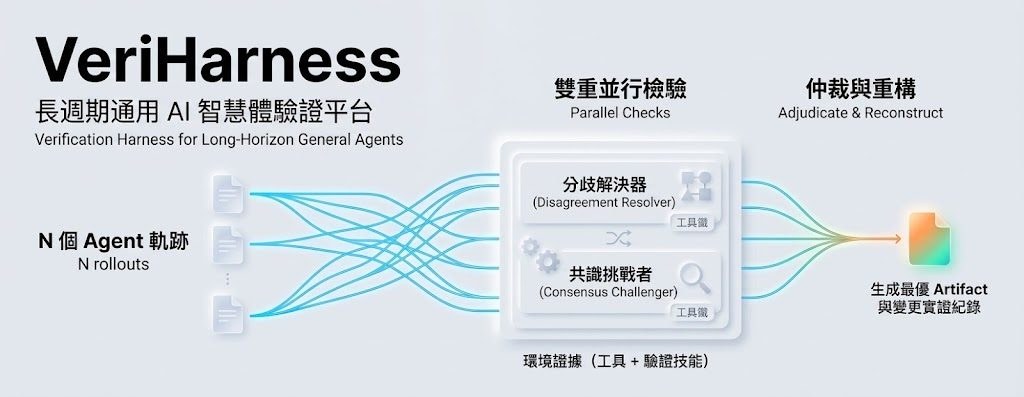
長時間 AI 任務容易在細節中累積錯誤,單靠一次 rollout 或多數票未必能找出共同誤判。VeriHarness 是一個面向 long-horizon general agents 的 verification harness,讓產生答案的同一個模型檢查環境證據、修訂成果,並記錄每項改動的原因。
它會把 N 次獨立 rollout 交給兩條調查流程:disagreement resolver 核對不同嘗試提出的主張,consensus challenger 則專門反查所有嘗試都同意的內容。兩邊取得文件、資料或可重新計算數值後,再由 adjudication 選取或重建 artifact,處理了「分歧不等於錯誤、共識也可能共同出錯」的取捨。
透過 Gemini on Vertex AI 或 Claude on Vertex AI 執行驗證;wb 與 wsb 評分器則在網絡容器中處理文件、試算表、程式碼及多檔案工作區任務。項目同時公開約 26,000 次 rollout,方便研究團隊重現流程或比較自己的 verifier。
結果顯示,Gemini 3.5 Flash 作為 generator 和 verifier 時,證據支援的修訂比單次 rollout 平均高 6.2 分;Claude Opus 4.8 則高 6.4 分,五個 benchmark 的十個 model–benchmark settings 均取得最高 primary selection score。這些數字反映選擇與修訂能力,不能直接等同完整 artifact 必然正確。
- 適合長流程工作:文件、試算表、程式碼及多檔案任務均可納入檢查。
- 核心差異:同一模型負責產生與驗證,優勢來自 rollout pool 結構及環境證據,而非更強的 judge。
- 研究價值:分開測試 disagreement 與 consensus,能定位模型反覆犯下的共同錯誤。
- 使用限制:需要模型服務、評分容器及可檢查的任務環境,配置成本高於單次生成。