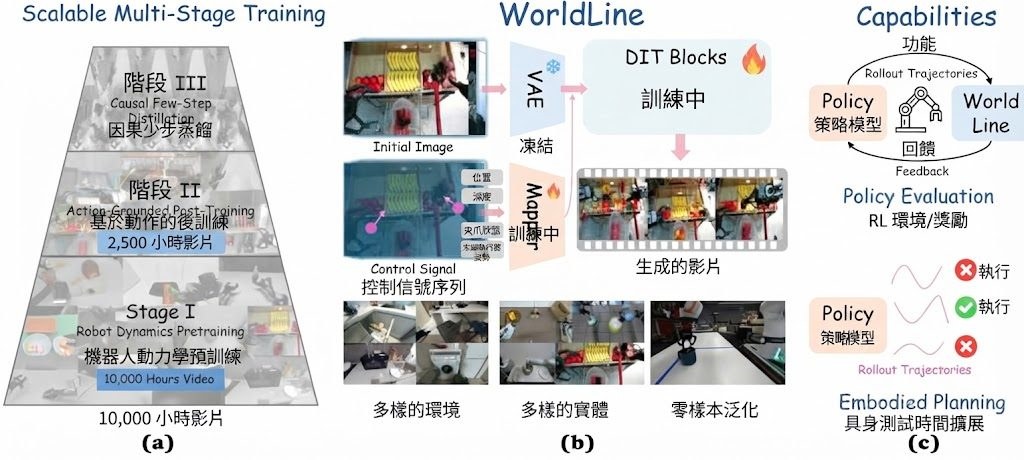
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。
WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。
WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。
- 用於 policy evaluation、embodied planning 及實體操作前的預測
- 以 image-space action 統一不同機械人的視覺控制介面
- 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
- 以 few-step distillation 減少 rollout 所需計算
研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。