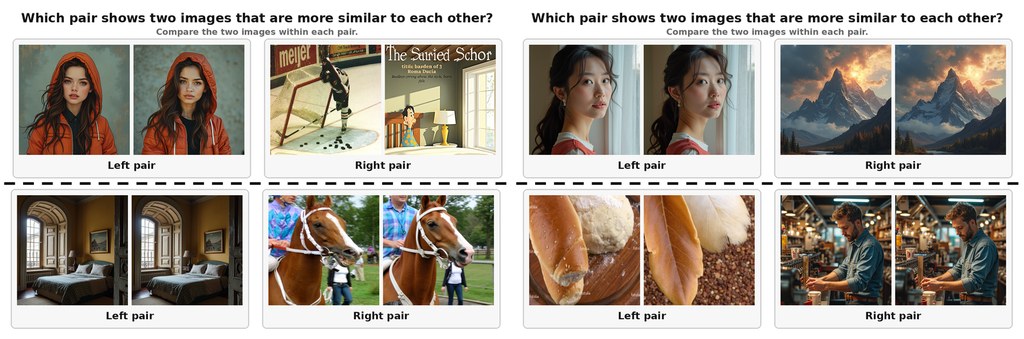
比較原圖與修改版本時,像素差異未必等於人眼感受到的差異。FoMo 以 reference-based perceptual distance metrics(參考式感知距離模型)處理這個問題,透過 FLUX.1-dev 的 img2img 軌跡製造有次序的影像變體,並以此訓練影像品質評估(image quality assessment,IQA)模型,屬於開源模型項目。
它的關鍵做法,是在 diffusion model 的去噪流程中,於不同 denoising steps 重新接回生成軌跡。重新接入得越早,生成圖與原圖的感知偏離通常越大;這個 forking moment 便提供了密集而有排序的監督訊號。項目用 480k 組影像資料配合 pairwise ranking objective,減少依賴人手逐張標註的成本。
項目提供七個模式,涵蓋 LPIPS、DISTS、DreamSim,以及以 frozen DINOv3、CLIP、MAE backbone 配合 prediction head 的版本。DreamSim 透過 LoRA adapters 微調,而 dinov3、clip、mae 會把兩張圖片按次序讀入同一組 token;預設會計算兩個方向的平均分,處理輸出可能不對稱的問題。
- lower score 代表兩張圖片更相似,raw 輸出也是公開評估採用的數值
- output=’loss’ 可提供以 identity pair 為錨點的 perceptual loss
- CNN 類模型使用固定 256px crop,DreamSim 使用固定 224px crop
- DINOv3、CLIP、MAE 支援 64 至 256px 隨機裁剪,並以 zero-padding 和 attention masking 組批
- 項目可透過 Python 套件 fomo-iqa 載入預訓練模型,直接比較參考圖與測試圖
FoMo 適合需要自動判斷生成圖片、編輯版本或重建結果相似程度的研究者與影像工具團隊。它的限制也很清楚:訓練訊號來自 FLUX.1-dev 的生成軌跡,不能直接等同人類偏好;不同 backbone 的輸出形式、裁剪策略與對稱處理亦會影響比較結果,因此應按工作流程選擇模型並自行驗證。