Work Agents 將數碼工作拆成可驗證成果

跨應用程式完成工作,不能只看模型答得對不對;Work Agents 把代理流程、能力與可驗證成果放進同一研究脈絡。

Work Agents: Systems, Capabilities, and Optimization

當 AI 要跨應用程式完成多步工作,交付可核實、能供後續使用的成果,比單次答對更重要。Work Agents 是配合調查研究整理的開源閱讀清單,收錄數碼工作代理的系統、訓練、環境、記憶、基準與官方資源,並非可直接安裝的代理軟件。

研究以工作持續性(work persistence)和工作開放性(work openness)描述工作條件,並分成對話(Conversation)、單一步驟(Atomic Action)、多步(Multi-step)、工作流程(Workflow)及工作區(Workspace)五類。它也梳理 foundation models(基礎模型)與 runtime harnesses(執行時框架)的單獨或協同優化,評估則聚焦成果能否符合要求並供下游使用。

你可由 GitHub 清單挑選論文、基準和工具;暫未有可直接執行的代理或統一安裝、測試流程,不能當成部署指南。

  • 整理代理系統、訓練方法、環境與記憶研究
  • 涵蓋五類數碼工作及相關評測資源
  • 比較模型、執行框架及兩者的協同優化
  • 以可驗證、能供下游使用的成果作評估焦點

產品團隊和自動化流程負責人可用它整理能力缺口與評測方法。清單沒有同一環境下的性能數字,具體效果仍要回到各研究與工具核實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, 框架, 香港, 軟件, 工具, 庫

CLI-Anything 讓 AI 代理直接操控軟件

CLI-Anything 把圖像、CAD、3D 等軟件包裝成可供 AI 代理操作的 CLI,打通代理與既有工具之間的斷層。

icon

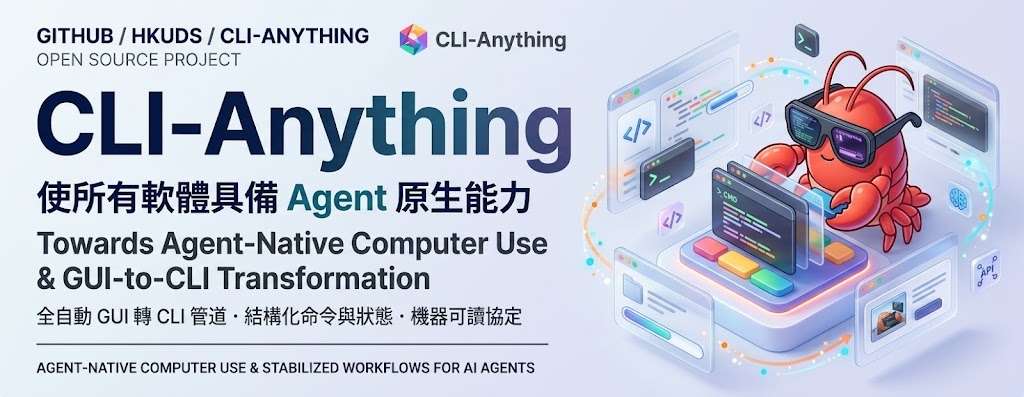
當 AI 代理需要製作 CAD、3D 場景、圖表、遊戲或字幕,CLI-Anything 會把原本面向人類操作的軟件轉成可調用的 CLI。它屬於開源的 Agentic 工具與 CLI 生成框架,處理的是代理缺乏一致介面、難以持續操作軟件及產出可驗證成果的問題。

項目以 /cli-anything 作為主要入口,並配合預覽、即時預覽及 trajectory loops,讓代理不只發出指令,還能逐步產生和檢查真實 artifact。README 亦列出 Cursor plugin、Hub 及 skills,反映它同時照顧 CLI 生成端和代理使用端;舊版本則可能要改用 /cli-anything:cli-anything。

和只依賴 GUI 操作或個別 API 整合的做法相比,CLI-Anything 嘗試為不同軟件建立較統一的代理介面,方便重用流程,但效果仍取決於每個軟件的 CLI harness 是否完整,以及代理能否正確理解工具狀態。項目提供 CLI-Hub,使用者可瀏覽、安裝及管理社群建立的 CLI;原始資料未交代各 harness 的詳細安裝步驟、資源要求或一致的性能基準。

CLI-Anything: Turn ANY App into a CLI for Claude Code & Codex (GIMP, Blender, LibreOffice & More!)

• 支援把多類軟件轉成 AI 代理可調用的 CLI
• 以預覽與 trajectory loops 協助產生可檢查的成果
• 提供 CLI-Hub 管理社群 CLI
• 適合需要串連設計、製作及自動化流程的團隊
• 仍需逐一確認各軟件 harness 的成熟度

對熟悉 Cursor 或其他代理工作流的開發者,這套方法適合用來延伸圖像處理、CAD、3D 製作及內容生產流程;對只想即時使用單一軟件的使用者,則要先確認所需 CLI 是否已建立及可用。

GitHub

Categories: 開源, 香港大學, Agentic, API, Image, World-Action Model, 框架, 軟件, 工具, IDE, 3D, 編程, Skill 技能

SimVTA 為自動駕駛補上替代路線的視覺訓練

SimVTA 用模擬器生成不同駕駛路線的未來畫面,讓模型不只學習紀錄中的單一路徑。

From logged futures to candidate-matched supervision

自動駕駛模型需要判斷轉線、直行等替代路線,但行車紀錄通常只保留當時真正採取的路徑,其他選擇缺乏對應影像。SimVTA 屬於 driving world action model 的 post-training framework,處理的正是軌跡規劃與未來視覺監督不匹配的問題。

項目會在以 3D Gaussian Splatting(3DGS)重建的真實場景中,為候選軌跡渲染相配的未來影片,再以 Group Relative Policy Optimization(GRPO)優化軌跡,並加入 flow-matching video loss 更新共享表示。高回報候選之中,系統會優先挑選誤差較大的未來,減少有限渲染資源被低價值樣本消耗。

相較只依賴 logged trajectories 的訓練方式,SimVTA 補上了替代行動的視覺訊號;代價是需要 3D 場景重建與模擬渲染,訓練流程較複雜。推理階段則直接預測軌跡,不需再次呼叫模擬器,較適合納入自動駕駛規劃流程。

  • NAVSIM v1:PDMS 由初始化模型的 86.2 提升至 91.3
  • NAVSIM v2:取得 88.2 EPDMS
  • HUGSIM 閉環測試:平均 HD-Score 為 38.8
  • 消融結果支持共享表示更新及高誤差樣本優先策略

研究團隊包括 OpenDriveLab at HKU、Shanghai Innovation Institute、Li Auto、Tongji University 與 Tsinghua University。這個項目較適合研究自動駕駛、world action model 或模擬訓練的團隊;目前儲存庫仍標示 code 和 checkpoints 尚待發布,因此未能當作即裝即用的工具測試,重現結果仍需等待相關資源。

項目主頁 · GitHub

Categories: 開源, 香港大學, 清華大學, AI productions, 模型, 模型訓練, Video, Image, World-Action Model, 框架, 香港, 工具, 3D, 庫, 自動駕駛

ViRA 讓視覺表徵真正改善自動駕駛

ViRA 把視覺基礎模型的表徵帶入端到端駕駛訓練,提升規劃表現之餘,不增加部署時的推理成本。

teaser

端到端自動駕駛需要由鏡頭直接產生駕駛規劃,但更強的視覺表徵未必自然帶來更好決策。ViRA 是一個 planner-agnostic visual representation alignment framework,於訓練期間把規劃器特徵對齊至凍結的 visual foundation models (VFMs),保留原有 planner 架構,部署時亦不增加推理成本。

項目由香港大學 OpenDriveLab、東南大學及 Shenzhen Loop Area Institute(SLAI)等團隊共同開發。它主要處理「視覺表徵強不等於駕駛表現強」的落差。研究測試多款 end-to-end planners,發現 VFM 目標的選擇會影響規劃效果;加入 auxiliary perception supervision 後,五個目標之間的 EPDMS 差距由 2.7 分收窄至 0.5 分,反映訓練訊號與目標模型需要一併考慮。

ViRA-Diffusion 以 DINOv3 alignment 訓練,毋須 auxiliary perception supervision,在 NAVSIM v2 navtest 取得 92.3 EPDMS,較比較中的近期方法至少高 1.9 分;在較具挑戰的 navhard,Rap* 配合 ViRA 亦錄得改善。HUGSIM 結果則屬 zero-shot,規劃器只在 NAVSIM 訓練,未在 HUGSIM 重新訓練。

項目的適用範圍:
– 適合研究 camera-only 端到端自動駕駛及 VFM 對規劃的影響。
– 可在不改動已部署 planner 架構的前提下,加入訓練期表徵對齊。
– 評測指標包括 NAVSIM 的 EPDMS,以及 HUGSIM 的 HD-Score。
– 儲存庫目前列出結果與示範已發布,但程式碼及 checkpoints 仍在待辦清單,未有足夠資料支持直接安裝或下載模型。

ViRA 更適合作為研究和模型訓練方法閱讀,而不是即時可用的駕駛軟件;它展示的是如何選擇 VFM 目標及監督方式,並非保證所有規劃器都會得到相同幅度的提升。

項目主頁 · GitHub

Categories: 開源, 香港大學, 模型, 模型訓練, 框架, 香港, 軟件, 庫, 自動駕駛

Multics:開源多玩家世界模型

Multics 是騰訊 ARC Lab 與港大合作的多玩家影片生成世界模型,靠分層通訊機制讓同一個訓練版本直接推廣到 6、8、10 人,玩家與鏡頭控制互不干擾。

Repository image for TencentARC/Multics

打機時如果有 4 個、6 個甚至 10 個玩家走在一起,畫面要保持連貫,又要讓每個人各自控制鏡頭與動作,舊做法往往一加人就 O(N²) 爆計,或出現互相干擾。Multics 正是針對這個卡位:來自騰訊 ARC Lab 與香港大學的開源世界模型,採用 Player → Group → Global 的分層通訊,動態根據最近鏡頭軌跡分組,限制無關事件直接混合。共享的 group-token 參數令用 4 人數據訓練的模型,可以直接推廣到 6、8、10 人而毋須重新訓練。

對於做多人遊戲原型、模擬訓練環境或敘事影片的團隊,這個項目直接省掉「人數一變就要重訓模型」的麻煩,同時降低自注意力計算量,GPU 開銷壓得較低。它的代價是依賴 NVIDIA GPU、CUDA 12.8 與 Linux 環境,安裝需用 uv 同步依賴,並從 Hugging Face 下載包含 VAE、tokenizer 與 4-player checkpoint 的完整推理包。

Repository 提供 inference.py 配合 YAML 配置,可選擇 4-player 範例或擴展到多人數測試,原始資料未列出具體的玩家數上限驗證結果,只說明同一個 4 人 checkpoint 能支援 10 人輸出。代碼以 Apache 2.0 授權,研究與商業應用皆可改作。

重點摘要:

  • 騰訊 ARC Lab 與香港大學共同開發的多玩家影片生成世界模型
  • 分層通訊機制降低注意力計算成本,避免無關玩家互相干擾
  • 共享參數設計讓 4 人訓練版本直接支援 6、8、10 人,毋須重新訓練
  • 推理需 Linux + CUDA 12.8 + NVIDIA GPU,模型權重經 Hugging Face 發佈
  • 適合多人遊戲畫面合成、模擬訓練、互動敘事等需要可擴展多視角的工作場景

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 騰訊, 模型, 世界模型, 模型訓練, NVIDIA, Video, 香港, Linux, Tokenize

GroundAnything 以並行解碼提升視覺定位速度

GroundAnything 把多種視覺定位任務放進 4B 模型,嘗試同時處理精準座標與推理速度的取捨。

GroundAnything

要在圖片中找出物件、位置和空間關係,GroundAnything 可一次處理多類 visual grounding 任務,減少逐個輸出座標帶來的延遲。它屬於 4B 級視覺基礎模型,實際處理的是影像內容與文字查詢之間的精準定位問題,適合影像標註、視覺搜尋及多模態分析工作流。

模型以 GroundAnything 的 diffusion decoding 配合 parallel decoding,讓空間假設可以並行生成;GroundAnything-VLM 則是獨立的 autoregressive checkpoint。前者針對序列生成的速度限制,後者保留自回歸模型路線,兩者均使用 GAM evaluation mode,並非同一模型的不同介面。

項目透過 grounding pretraining、AR-to-diffusion conversion、joint objectives、supervised fine-tuning 和 GRPO-based reinforcement learning 建立模型。30 個基準測試中,GroundAnything 勝過同級自回歸模型的整體最佳結果,亦超越較大的 Qwen3.7-Max;GroundAnything-VLM 在同級別取得新的整體最佳結果,並與 GPT-6 Astra 保持競爭力。

適合需要精準視覺定位、又要控制推理延遲的研究團隊和影像處理項目,硬件需求、實際吞吐量及不同圖片任務的穩定性仍需自行驗證。

  • 速度取捨:以 diffusion decoding 和並行輸出減少空間預測的序列等待。
  • 模型關係:GroundAnything 是 diffusion 路線,GroundAnything-VLM 是獨立 autoregressive checkpoint。
  • 評估範圍:涵蓋 30 個 benchmarks,並比較 MTP-based generation 與多階段基礎設施優化。
  • 適用場景:影像定位、批次標註、視覺搜尋及需要座標輸出的多模態工作流。

項目主頁 · GitHub

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, 香港, 強化學習

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

Representation Guidance(RG):以低維引導 Pixel Diffusion Transformer 生成影像

Representation Guidance 把生成所需資訊壓縮到低維表示,再直接引導像素生成,為大型 pixel diffusion Transformer 提供更有效率的改良方向。

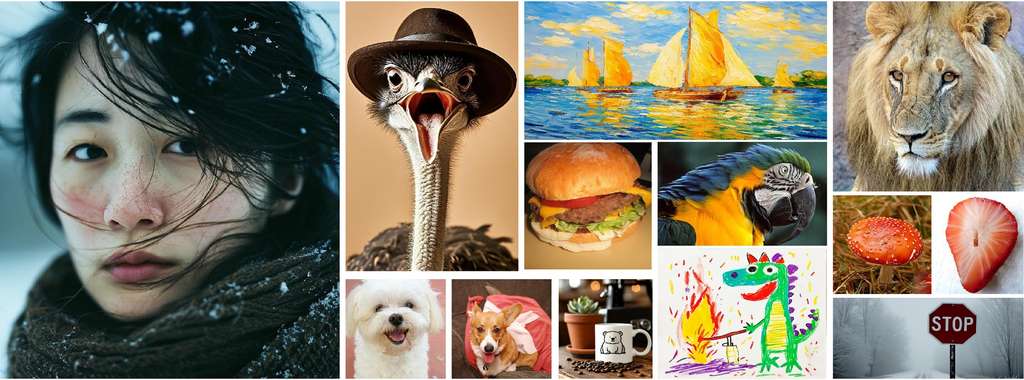
Samples generated by RG

由像素直接生成高質素影像,往往要在語義理解、空間細節與模型計算量之間取捨。Representation Guidance (RG) 屬於影像生成模型方法,針對 pixel diffusion transformers 加入可被生成流程主動利用的內部表示,同時保留 plain Transformer 架構,處理表示學習與像素合成未能有效銜接的問題。

RG 先用 low-dimensional bottleneck 將與生成相關的資訊集中到緊湊表示,再按照該表示帶來的 prediction offset,修改 flow-matching target,直接引導 decoder 生成。它沒有依賴外部 autoencoder 預先建立 representation space,而是由 raw pixels 端到端學習;相較加入專用 pixel decoder 的架構,RG 嘗試避免只重新分配語義及空間建模工作,並以較簡單的 Transformer 結構擴展。

在 ImageNet 256×256 測試中,RG-L/16 使用 459M 參數,在 600 epochs 達到 1.79 FID;RG-XL/16 以 724.9M 參數取得 1.55 FID、293.8 IS。項目亦報告 512×512 的 1.74 FID,並延伸至 text-to-image,在 GenEval 取得 0.89、DPG-Bench 取得 87.1;這些結果顯示方法適合研究高解析度像素生成及文字生圖,但較大型模型仍需要相當計算資源。

你可從以下幾點理解它的實際價值:
– 低維 bottleneck 將生成相關資訊集中,減少表示與生成流程各自學習的落差。
– RG-L/16 以較少參數超越更大型的 pixel diffusion transformers。
– plain Transformer 方便研究內部表示如何形成及影響像素合成。
– 項目資料提供結果與模型規模,但未交代完整安裝、下載或推理流程,測試前仍需查看 Project Page 或後續程式碼。

較適合研究 pixel diffusion、生成式表示學習,以及希望比較 flow matching 架構的團隊。它的價值不在於提供即時可用的生圖工具,而在於把「學到表示」與「利用表示生成」放入同一個訓練機制;模型參數和 GFLOPs 仍然偏高,未必適合資源有限的個人電腦。

項目主頁 · GitHub

Categories: 開源, 香港大學, 阿里巴巴, 模型, 模型訓練, Image, World-Action Model, txt2img, 香港, 工具

Compo:以 Spatial Canvas 編排海報中的文字、人物與圖像

Compo 讓你用畫布安排文字、人物與圖像位置,再交由模型生成海報,減少只靠文字描述構圖的反覆試錯。

Compo Teaser

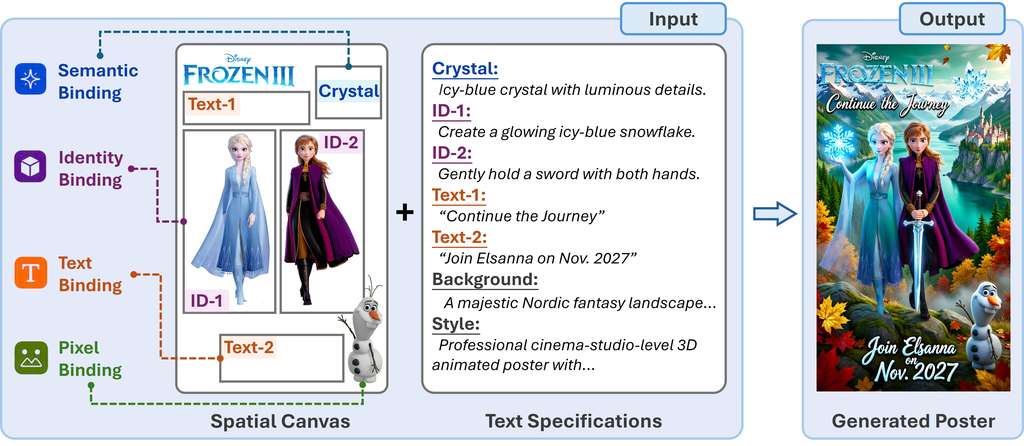
海報生成最難控制的往往不是主題,而是文字、人物和裝飾元素應該放在哪裏。Compo 屬於海報生成模型及介面項目,將 Spatial Canvas Interface 與 Text Specifications 結合,讓使用者直接在畫面中表達二維構圖意圖。

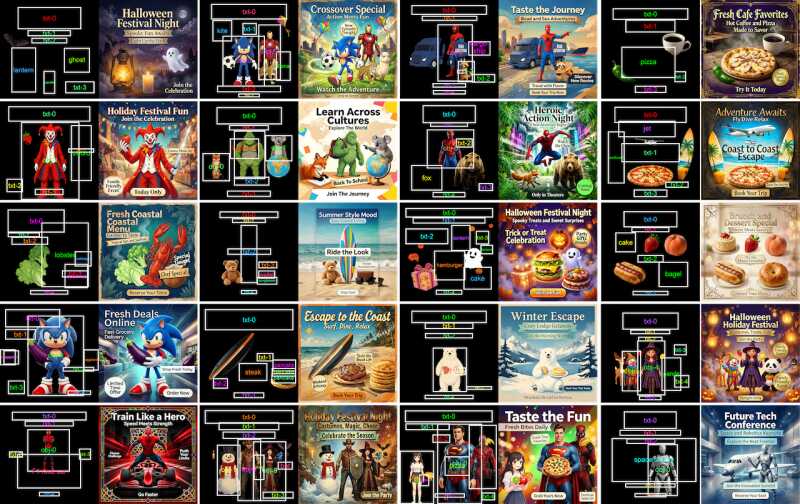
Spatial Canvas 支援四種綁定方式:Semantic Binding 指定文字概念及目標區域,Identity Binding 以參考圖保留視覺身份,Text Binding 同時交代準確字句與位置,Pixel Binding 則放入需要保留的像素內容。Bounding boxes、參考圖片和文字識別資料會一併渲染到畫布,形成模型接收的統一影像輸入。

  • 以畫布補足單靠文字提示難以交代的空間關係
  • Compo 由預訓練 image editing model 改編而成,毋須另建 task-specific architecture
  • 支援 direct inference,也支援 agentic mode 自動規劃畫布
  • 可用於海報、宣傳圖及需要精確排版的視覺內容

Compo 的模型改編重點,是令現有 image editing model 理解不同綁定方式及其組合,而不是從零訓練專用 poster generator。項目亦建立自動產生監督數據的流程,協助模型學習各類 Spatial Canvas 輸入;這比純文字提示更容易控制位置,但使用者仍要準備畫布內容,agentic mode 的自動規劃亦未必取代人工微調。

適合研究人員、設計工具開發者和需要批量製作宣傳海報的內容團隊作為試驗起點,而非直接視作成熟的製作平台。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, 視覺模型, 模型訓練, 微軟, Image, 影像處理, 香港, 工具, 中國, Dataset 數據集

RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

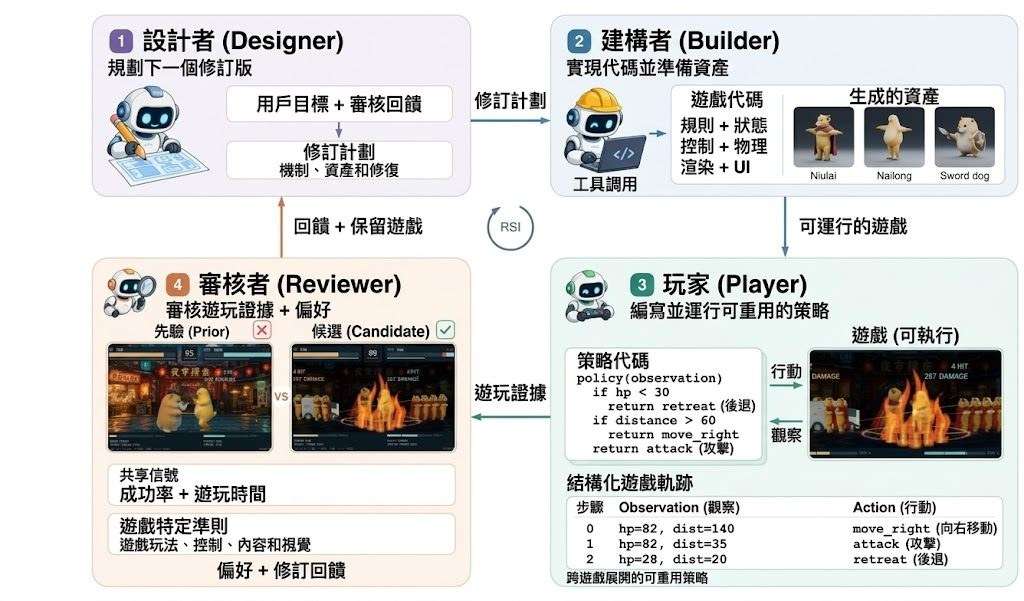
Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。
項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

Page 1 of 5
1 2 3 … 5