SWE-Explore-Bench:拆解編碼代理如何理解你的程式碼

這個基準將編碼代理的探索能力獨立評分,以 848 個真實議題為基礎,衡量代理能否在動手修改前找對行級上下文。

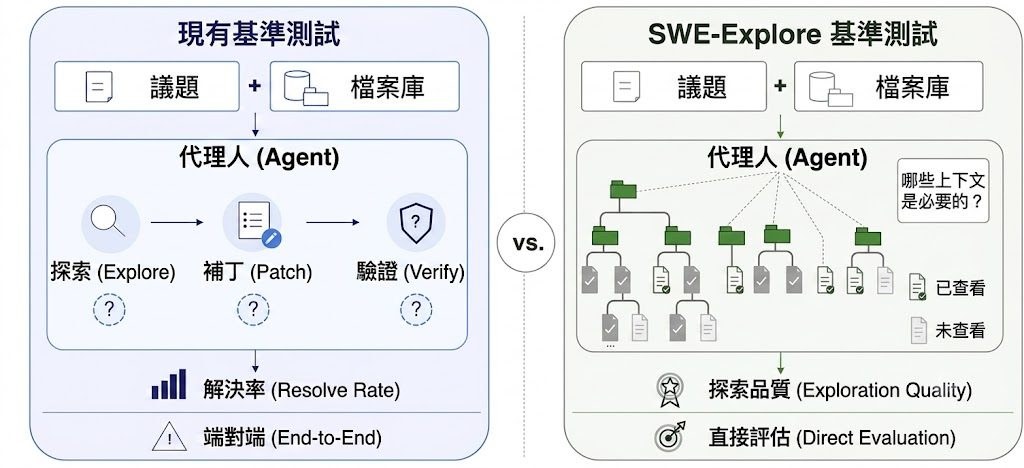
SWE-Explore evaluates repository exploration directly instead of only end-to-end repair.

SWE-Explore-Bench 由上海交通大學、香港中文大學等團隊推出,專門考核編碼代理在「真正落筆修改前」探索程式碼庫的表現。現有的 SWE-bench 等基準只給出最終通過與否的二元結果,難以分辨代理是因為找對位置而成功,還是碰巧蒙對。這個項目把探索這一步抽離出來單獨計分,更貼近診斷代理能力的本質。

具體做法是收集同一議題的多條成功修復軌跡,從中抽取代理實際讀取的程式碼行範圍,整合出共識的核心上下文,再保留部分模型獨有的可選上下文。代理需要輸出一份按行範圍排序的程式碼區域清單,評分涵蓋覆蓋率、排序品質、上下文效率,以及下游受限修補驗證四個維度。這種行級監督比傳統的檔案級定位更細緻,能揭示代理的真正瓶頸。

資料集涵蓋 10 種程式語言、203 個開源項目中的 848 個議題,並提供 OpenAI 相容的端點,方便接駁不同 LLM 進行行範圍精修。實測結果顯示,具備代理能力的探索器明顯領先傳統檢索器,現代方法在檔案層級已相當成熟,但行級覆蓋與高效排序仍是區分頂尖方案的分水嶺。

適合關注 SWE-agent、AutoCodeRover、OpenHands 等代理框架的研究者、開發者及基準設計者使用。對想了解自家代理「讀碼環節」強弱的團隊而言,這是一個值得放入評測管線的參考項目。
GitHub: https://github.com/Qiushao-E/SWE-Explore-Bench

Paper: https://arxiv.org/pdf/2606.07297

Categories: 開源, 香港中文大學, 框架, 編程

AffordanceVLA:為機械臂加入「先想再做」的能力

這項目把視覺、語言與動作三者之間的落差,透過三段式可供性預測串起來,讓機械臂在執行指令前先理解該碰哪裡、怎麼碰。

AffordanceVLA overview

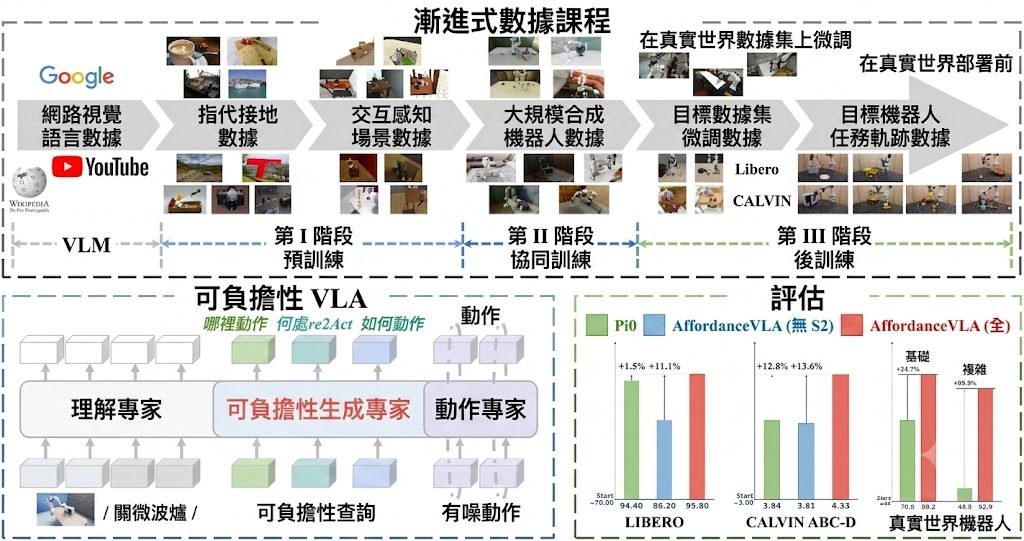
機械臂聽到「把杯子拿起來」這類指令時,傳統的視覺語言動作模型(Vision-Language-Action Model, VLA)往往要直接把影像和文字翻譯成關節角度,中間欠缺一個「思考」步驟。AffordanceVLA 嘗試在這個鴻溝上架一道橋:先讓模型預測結構化的可供性(affordance),再據此生成動作。

整個框架由三個專家模型組成,按單向的 UAA 注意力串接。Understanding Expert(M_und)以 PaliGemma(SigLIP + Gemma)為骨幹,把畫面、指令與機械臂自身狀態融合成統一的語意表示。Affordance Generation Expert(M_gen)以 Gemma 搭配可學習查詢,把上述表示解碼為三種可供性標記:Which2Act 判斷要操作的物件、Where2Act 標出二維互動熱區、How2Act 則推估三維幾何資訊。最後 Action Expert(M_act)以 flow matching 方式輸出整段動作序列(action chunk)。這個設計呼應了論文「Affordances serve as a perfect bridge」的核心想法。

由於現成機器人數據集中缺乏密集的可供性標註,作者額外提供了一條自動化標註管線,並以三階段漸進式課程訓練 MoT 架構。訓練時須留意 model.chunk_size 與 data.chunk_size 保持一致,否則動作 attention mask 會錯位;Which2Act 的 Flux loss 預設為 MSE,可在 src/models/which2act_decoder.py 頂端切換。

這個項目適合研究 VLA、機器人操作策略,或對可供性表示有興趣的開發者。需要一支能跑 PaliGemma 與 flow matching 的 GPU 環境,並準備好仿真或實機評測流程。論文中的模擬與真機實驗橫跨多種操作場景,顯示加入可供性中間層能提升泛化與精確度,但具體數字仍以官方報告為準。

重點摘要

  • 以 Which2Act、Where2Act、How2Act 三段式可供性作為視覺、語言與動作之間的中間橋樑。
  • 採用 MoT 架構,串接 PaliGemma 為基礎的 Understanding、Gemma 為基礎的 Affordance 與 Action Expert。
  • 配套自動化可供性標註管線,緩解機器人數據標註不足的問題。
  • 訓練採三階段漸進式策略,flow matching 輸出整段動作序列。
  • 模型、訓練與標註腳本皆隨開源項目釋出,歡迎社群延伸。

GitHub: https://github.com/Skywalker-yqz/AffordanceVLA

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, 模型, 多模態模型, 模型訓練

Audio-Interaction:讓 AI 像真人一樣即時聽與回應

Audio-Interaction 是一款全新的開源音訊語言模型,採用感知-決策-回應的循環機制,統一處理即時與離線音訊任務。

Audio-Interaction teaser

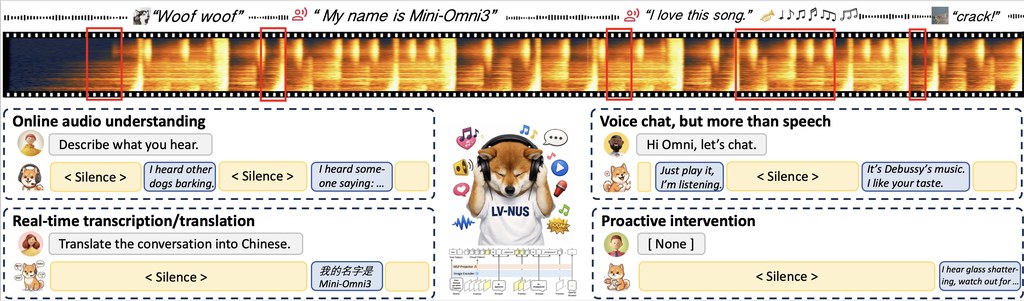
Audio-Interaction 是一款由南洋理工大學(NTU)、新加坡國立大學(NUS)及香港中文大學(CUHK)共同研發的全開源音訊語言模型,屬於新一代的 Audio Interaction Model(音訊互動模型)。它以一個始終運行的感知—決策—回應循環(perceive-decide-respond loop)為核心,能即時聆聽環境聲音與指令,並自行判斷何時應該開口回應。

傳統的大型音訊語言模型大多只支援離線處理,而現有的串流模型一般只能做單一任務,例如即時語音辨識(streaming ASR)或語音聊天。Audio-Interaction 以單一架構同時覆蓋離線與即時任務,把辨識、翻譯、對話等不同功能統一在同一條串流中。這意味著開發者只需要一套模型,就能應付多種音訊互動場景。

這個項目的核心創新在於其訓練流程 SoundFlow。它能把短音訊片段拼接成長互動資料,並以「塊級決策訓練」(chunk-level decision training)配合歷史回顧與語意感知的靜音處理,讓模型學會「該不該說話」。在推論階段,SoundFlow 採用異步 FIFO 推論(asynchronous FIFO inference),使首幀延遲降低約 4.5 倍,帶來更流暢的即時體驗。

使用時,開發者可以直接從官方頁面取得技術報告與程式碼,並透過微信群組加入社群討論。該項目亦提供了即時試聽 Demo,可與 OpenAI 的 gpt-realtime 及字節跳動的 Seeduplex 進行同條件比較,在重複聲響計數、咳嗽辨識及音樂風格判斷等場景中,Audio-Interaction 能逐輪輸出有意義的回應。

Audio-Interaction 重點摘要:

  • 統一架構:以單一模型同時支援離線與即時音訊任務,涵蓋辨識、翻譯及對話。
  • 感知—決策—回應循環:模型自行判斷回應時機,貼近真實人機互動節奏。
  • SoundFlow 訓練流程:結合資料拼接、塊級決策訓練與靜音感知,提升即時判斷能力。
  • 低延遲推論:異步 FIFO 推論使首幀延遲降低約 4.5 倍。
  • 完全開源:提供技術報告、程式碼及即時試聽 Demo,方便研究與應用。

這個項目特別適合從事語音 AI、對話系統及多模態互動研究的開發者與團隊,能為需要即時音訊理解的產品,例如智能助手、會議記錄、聽障輔助等,提供一個統一且靈活的基礎模型。

項目: https://xzf-thu.github.io/Audio-Interaction/

Categories: 開源, 香港中文大學, 模型, 模型訓練, 語音

DRDD:用兩階段拆解擴散模型,更省數據的圖像轉譯方案

港大團隊提出的 DRDD 把擴散過程拆成兩段獨立階段,統一處理多種圖像修復任務,並在配對數據有限時仍維持穩定表現。

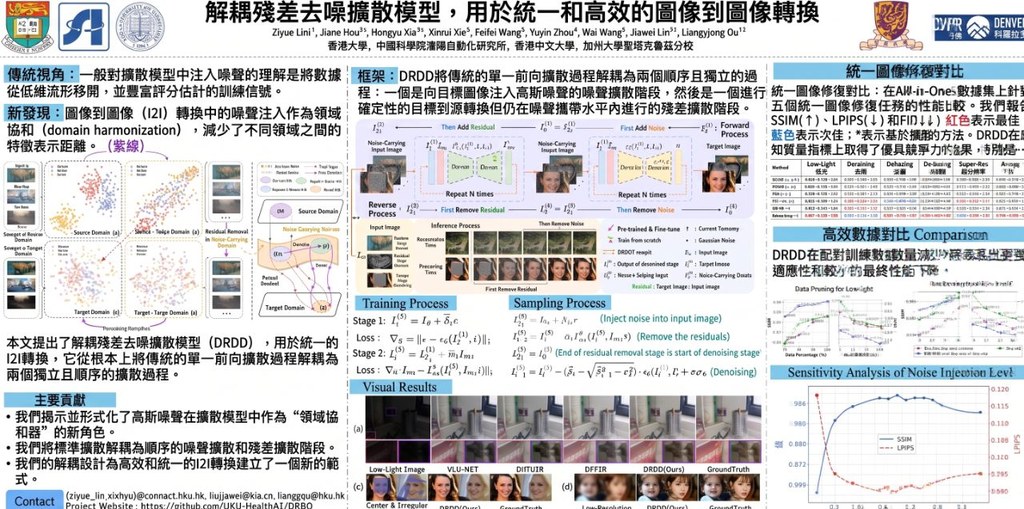
Main figure

圖像到圖像轉譯(Image-to-Image Translation, I2I)涵蓋去雨、去霧、低光增強、去噪、去模糊等多種任務,傳統做法往往需要為每個場景單獨訓練模型。HKU-HealthAI 提出的 Decoupled Residual Denoising Diffusion models(DRDD)嘗試用一套架構同時處理這些任務,並減少對大量配對數據的依賴。

DRDD 的核心做法是把擴散過程拆成兩個獨立階段:第一階段負責加入雜訊,達到所謂的「域調和」(domain harmonization)與流形抬升(manifold lifting);第二階段則在固定雜訊下做決定性的殘差擴散,專注學習語意對應。這種解耦設計避免了傳統擴散模型在去噪過程中提早耗散域調和效果的問題,因此能在一個模型內統一處理多個修復任務。

由於第一階段的雜訊擴散只使用目標域的非配對圖像訓練,DRDD 在配對數據稀缺時仍能保持表現,這對醫療影像或特殊場景數據蒐集成本高的領域特別有用。團隊在 all-in-one-5 設定下測試,涵蓋 Rain100L、GoPro、Dehaze、CBSD68 與 LOL 等數據集,並使用 LPIPS 等指標評估。論文亦提供理論與實證分析,說明其設計相容於主流擴散模型架構。

這個項目適合從事圖像修復、影像增強或風格轉換的研究者與工程師,尤其關心多任務統一、數據效率的團隊。使用前需要 Linux 環境、NVIDIA GPU、Python 3.7 以上,以及 Conda。預訓練權重可從 Quark 或其他途徑取得,並依說明放入 ./pretrained_models 目錄。

重點摘要:
– 將擴散拆成「雜訊擴散」與「殘差擴散」兩階段,保留域調和效果。
– 支援去雨、去霧、低光、去噪、去模糊等多種 I2I 任務的統一訓練。
– 第一階段僅用非配對目標域數據,降低對配對樣本的依賴。
– 相容主流擴散模型,可作為插件式改良方向。
– 適合醫療影像、遙測或數據稀缺場景的研究團隊。

DRDD 已在 GitHub 公開代碼與數據集結構,鼓勵社群以現有擴散骨幹(如 DDPM 系列)進一步測試與延伸。

GitHub: https://github.com/HKU-HealthAI/DRDD

Paper: https://arxiv.org/pdf/2606.01048

Categories: 開源, 香港中文大學, 香港大學, 模型, 視覺模型, 影像模型, 影像處理, Dataset 數據集

UI-KOBE:幫手機代理先認路再操作

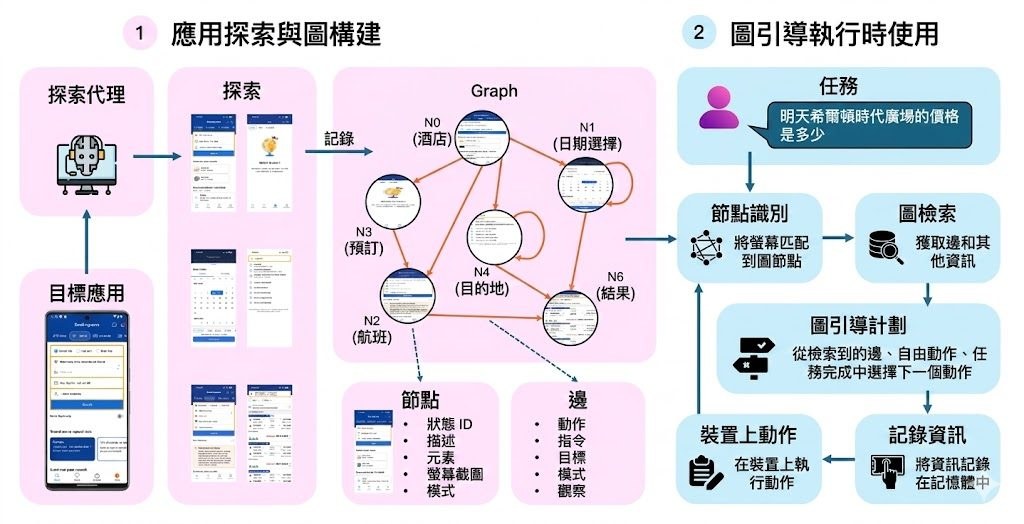
UI-KOBE 先探索 Android App,再建立畫面狀態圖。之後交給代理使用,導航會更穩定。

Repository image for YuxiangChai/UI-KOBE

UI-KOBE 是一個面向手機圖形介面代理的項目,核心做法是先探索 Android app,再把畫面與操作路徑整理成狀態轉移圖。對非研究背景的讀者來說,可以把它理解成先替代理畫好地圖,之後代理就不用每一步都盲撞。

動手使用這個項目,需要先備好 Python 3.10、uv、Android SDK、adb、emulator,以及已安裝目標 app 的 Android Virtual Device,另外還要提供 VLM 服務憑證。它依賴 AITK,並可把產生的圖拿去配合 AITK 或 Android World 使用,所以較適合已經有 Android 自動化或代理測試流程的人。

這個項目解決的問題很明確:手機代理在 app 內工作時,容易因畫面變化、按鈕位置或流程分支而迷路。UI-KOBE 會先開啟 app、觀察畫面、選擇探索動作,再記錄結果;每個 app 狀態成為圖節點,能把狀態改變的操作變成邊,之後執行階段可先匹配當前畫面,再從附近路徑選下一步,必要時也可用 free-form fallback action 補位。

  • 先建立 UI knowledge graph,再交給下游代理導航
  • 可接到 AITK 與 Android World 代理流程
  • 依靠 state-transition graphs 減少盲目點擊與重複探索
  • 內含 explore、audit_graph、plot_graph 等腳本,方便檢查圖內容

從設計看,UI-KOBE 的創新點不在單一模型,而在把探索與執行拆成兩段:先累積 app 結構知識,再於 runtime 重用。儲存庫亦提到 UI-KOBE v2 runtime 會載入圖、比對當前畫面節點,再根據圖邊決策;這種做法在多步驟 app 任務中,理論上比純即時決策更穩。

就用途而言,這個項目很適合研究 Computer-use agents(CUAs)、mobile GUI agents、Android 任務代理。

GitHub: https://github.com/YuxiangChai/UI-KOBE

Categories: 開源, 香港中文大學, Agentic, 框架

GenClaw 用寫程式方式改造 AI 生成圖

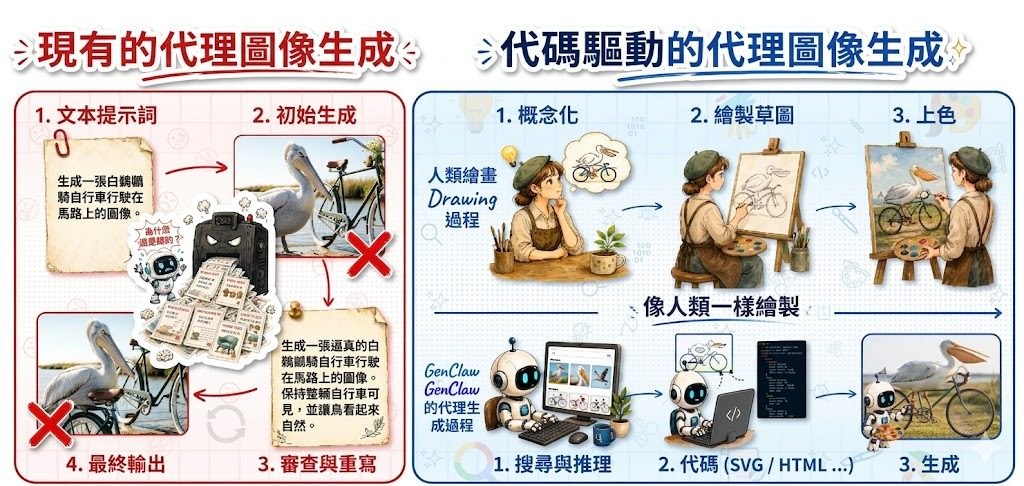
GenClaw 不只改提示詞,而是先用程式起草畫面再生成圖片。這種做法令構圖、文字與場景控制更清晰。

teaser

GenClaw 是一個研究中的項目,核心不是不停改 prompt,而是把程式碼變成可控制的視覺草稿,再交給圖像模型完成渲染。對一般讀者來說,可以把它理解成先畫草圖、定位置、排文字,之後才交由 AI 上色和補質感。

這個項目想處理的痛點很明確:很多 image generation 流程仍然像黑盒,生成失敗時只能反覆重寫提示詞碰運氣。GenClaw 將流程拆成 concept、sketch、render 幾步,令畫面中的物件數量、空間配置,甚至文字排版,都有機會透過可執行程式直接調整。

這做法結合搜尋、推理與程式繪圖,使用 SVG、HTML/CSS、Python,亦提到 Three.js 這類輕量 3D 方式來建立中間畫布;最後再調用 image generation model 補上材質、光影與真實感。這種設計比單次生成更容易檢查、修改,亦較貼近人類由草稿到完稿的創作步驟。

  • 把程式碼當成視覺畫筆,而非只靠文字提示
  • 適合複雜場景、海報文字、空間佈局等要求較高的畫面
  • 中間結果可檢查與回退,降低黑盒生成的不確定性
  • 論文提到可配合 GPT-Image、Qwen-Image、Nano-Banana 一類模型理解其定位

現階段要留意的是,儲存庫已公開 technical report,但 code 和 demo 仍在準備中,所以目前較適合先讀論文了解方法,再觀察後續釋出。從論文描述看,它較適合做視覺生成研究、代理系統開發,或者需要高控制度圖像流程的團隊;至於效能評估,公開頁面以方法與示例為主,較完整的量化表現仍需以論文內容和日後程式發布為準。

GitHub: https://github.com/yejy53/GenClaw

Paper: https://arxiv.org/pdf/2605.30248

Categories: 開源, 香港中文大學, 清華大學, Agentic

EvalVerse 評估電影畫面美感、演出、鏡頭語言評測

EvalVerse 用專家標註重整生成影片評測。它由「是否正確」走向「是否夠好看」。

Hero image preview

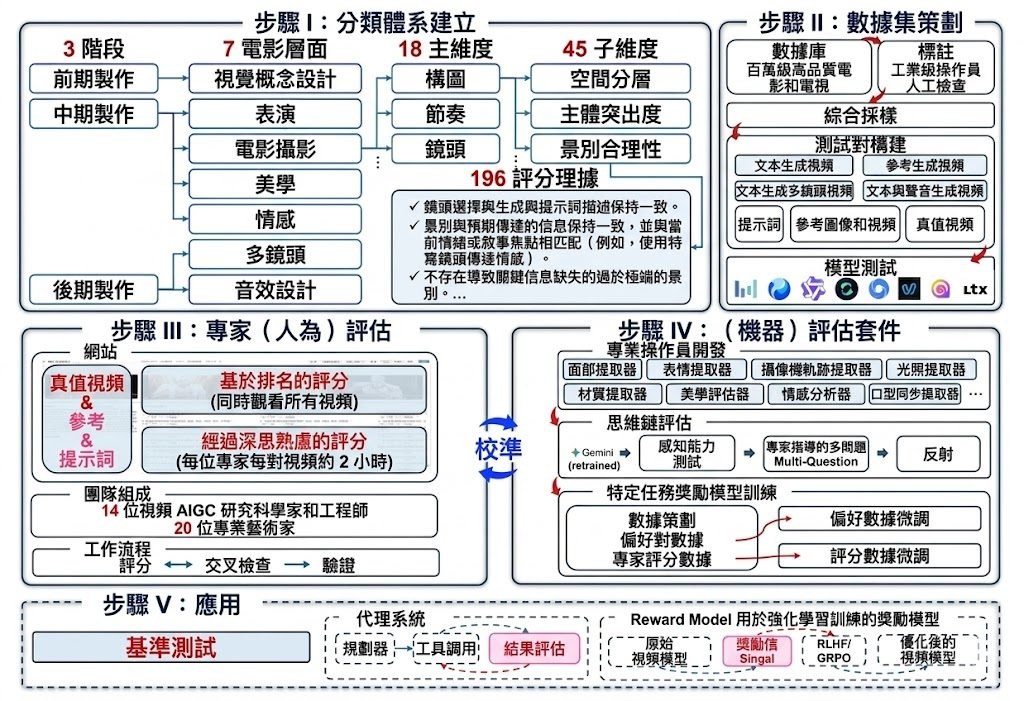
EvalVerse 是一個用來評估電影感生成影片的項目,重點不只看結果是否跟提示詞相符,亦會檢查畫面美感、演出、鏡頭語言和聲畫配合。對近年愈來愈多生成影片項目來說,它補上了「生成得對」與「生成得好」之間的落差。

EvalVerse 會先按電影製作流程理解評分架構,再用提示詞、參考圖或參考影片建立測試組合,之後配合人工標註與機器評估比較結果。論文把指標拆成前期、拍攝、後期三個階段,覆蓋 7 個面向、18 個主維度、45 個子維度和 196 條判準。

評分更細:不只看是否跟題,亦會看構圖、鏡頭大小、節奏、表演與聲音設計。
覆蓋更廣:支援文字生成影片、參考生成影片、多鏡頭影片及帶聲音影片。
可信度更高:加入大規模人工標註,再用專家判斷校準 VLM,縮窄機器評分與人眼感受差距。
用途更實際:除了排名,亦能提供診斷訊號,方便後續調整模型、獎勵模型或評估代理。

這項目特別適合做生成影片模型、影片工作流程工具或品質評測的人參考;如果你想比較不同系統,它也比單純看排行榜更有資訊量。論文重點在評估方法和資料整理,未見大量公開的生成表現數字,所以較適合作為評測基建,而不是單一分數工具。

EvalVerse 主要使用兩類模型:生成影片基礎模型,以及 Vision-Language Models(VLMs)。後者在這個項目中負責吸收專家評分經驗,作為機器評估的核心。

Paper: https://arxiv.org/pdf/2605.23271

Categories: 香港中文大學, 香港科技大學

MobileGym:手機操作測試搬到瀏覽器

項目把手機操作測試搬到瀏覽器,重點是可重設、可驗證、又能大規模並行。對研究手機 GUI 代理的人來說,方向相當清晰。

MobileGym — Program Mobile Worlds. Train GUI Agents. Verify by State. A verifiable and highly parallel simulation platfo

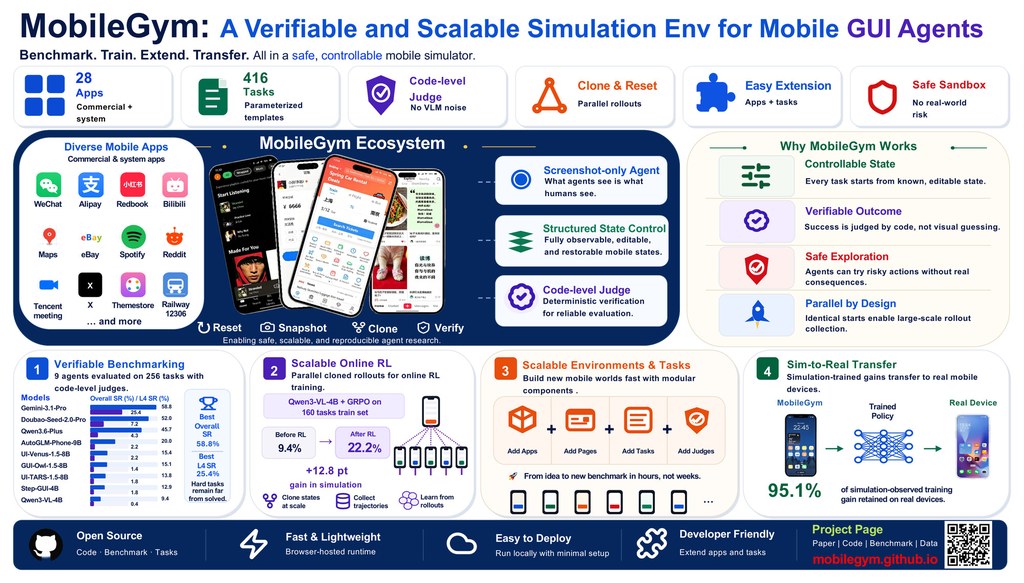
MobileGym 是一個放在瀏覽器內運行的手機模擬環境,重點不是做出一部「像真手機」,而是讓研究者可以穩定測試手機操作代理。它針對真機與模擬器常見的難題,例如狀態難以重現、評分不穩、成本高,提供一套較可控的做法。

使用相當直接:先開啟模擬環境,再把代理接上去執行任務,之後用內建評分函式檢查有沒有完成目標。這個項目提供 28 個模擬 app、416 個任務模板,也支援把整個環境狀態存成 JSON,方便重設、比較與重跑同一組測試。

MobileGym 在「結果驗證」不靠模糊文字比對,也不依賴視覺模型做人手味很重的判斷,而是直接檢查結構化狀態。這代表系統不止能知道任務是否成功,還能發現副作用,例如錯誤追蹤了某個帳戶,或誤發訊息,這類情況在真機流程往往較難完整看見。

  • 支援 256 個並行實例,同一台伺服器可同時跑大量測試
  • 每個實例約 400 MB 記憶體,冷啟動約 3 秒
  • 評分為可程式化且具決定性,官方稱可達亞毫秒級
  • 已展示模擬到真機的轉移效果,保留約 95.1% 的訓練增益

性能數字是這個項目的另一個賣點:官方資料指 256 個任務的完整評估可在約 6 分鐘完成,而且 CPU 佔用不高。對需要反覆訓練、比較不同策略或模型的人,例如 Qwen3-VL-4B 搭配 GRPO 這類流程,這種可並行、可重現的設計比單靠真機測試更實際。

整體來看,MobileGym 適合做手機 GUI 代理研究、評測流程設計,以及強化學習訓練驗證。它未必取代真機,但作為前期迭代與大規模評估平台,定位十分明確;尤其當你重視可重現性、成本控制,以及能否清楚知道代理到底做對了甚麼、又做錯了甚麼,這個項目值得留意。

GitHub: https://github.com/Purewhiter/mobilegym

Categories: 開源, 香港中文大學, 北京大學, 框架

Pi-Bench 點評:測試主動型助手夠唔夠醒

Pi-Bench唔係教你做助手,而係用嚟檢驗助手有幾主動。它特別重視長流程、多輪互動同隱藏需求。

Pi-Bench Overview

OpenClaw 等個人助理代理的興起凸顯了大型語言模型在支援使用者日常生活和工作方面日益增長的潛力。這些環境中的一個核心挑戰是主動協助,因為使用者通常從未明確說明的請求開始,而未說明重要的需求、限製或偏好。

Pi-Bench 不是一般聊天問答,而是評測檢查個人助手型代理在長流程工作中,能否及早察覺用戶未講出口的需要。這類情境很常見,因為不少人一開始只會講大方向,細節、限制同偏好往往在後續對話才慢慢浮現。

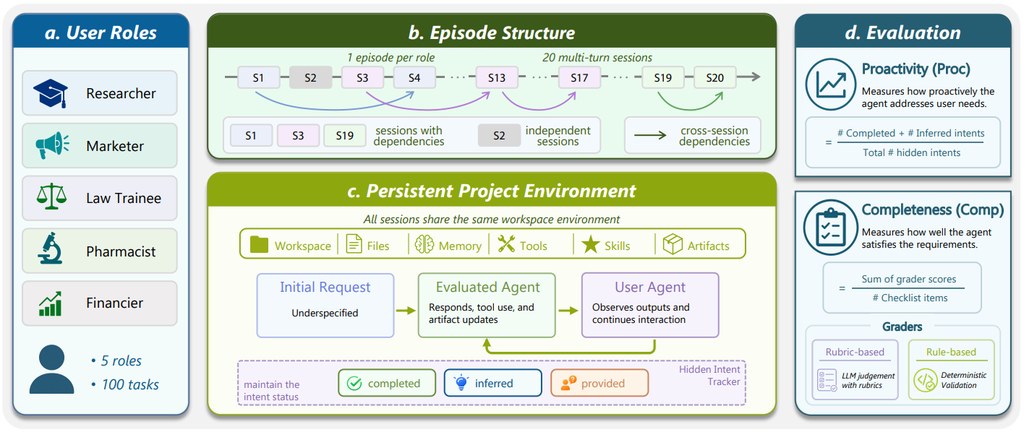
這個項目收錄了 100 個多輪任務,涵蓋 researcher、marketer、pharmacist、law trainee、financier 五類角色,並且把任務放進可持續保存的工作空間,模擬跨時段處理事情的情況。相比只測短回合回答的基準,它更接近「一路做、一路補需求」的助手工作模式。

Pi-Bench 的特別之處,在於它同時看兩件事:助手夠不夠主動,以及最後交付是否完整。前者會看系統能否提早推斷隱藏意圖,或主動追問關鍵資訊;後者則檢查輸出是否符合清單要求。README 提到評分包含隱藏意圖判斷與 checklist 驗證,而且審核分歧低於 4%,顯示評估設計有一定穩定性。

對研究代理系統、評估 LLM 助手,或者想比較 OpenClaw、Nanobot、Claude Code 一類模型/系統表現的人,這個項目幾有參考價值。使用時重點不是「跑出高分」本身,而是觀察模型在哪些回合漏問、忘記前文,或者只懂被動完成指令。

  • 針對長流程、多輪互動,不只測單次回答
  • 納入隱藏需求、跨任務依賴與跨 session 延續性
  • 以主動性與完整度兩條線一齊評估
  • 包含 5 種角色、100 個任務,場景較立體
  • 適合比較個人助手型代理,而非純文字問答模型

整體來說,Pi-Bench 最有價值的地方,是把「助手是否主動幫到手」拆成可觀察、可比較的評測問題。它未必直接提升模型能力,但很適合作為檢查工具,幫團隊看清楚一個助手究竟只是跟指令做事,還是真正懂得提前補位。

GitHub: https://github.com/Simplified-Reasoning/Pi-Bench

項目: https://simplified-reasoning.github.io/Pi-Bench/

Categories: 開源, 香港中文大學, 框架, 中國, Dataset 數據集

NudgeRL:用更聰明方式訓練數學推理

NudgeRL嘗試用「策略提示」提升模型探索能力,減少單靠大量試錯的成本。對數學推理研究尤其值得留意。

Repository image for tally0818/NudgeRL

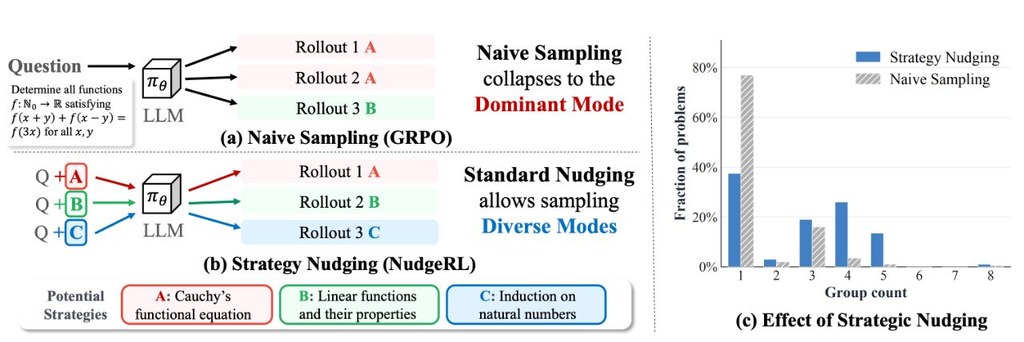
如果你有留意近年大語言模型點樣練習數學題,NudgeRL算係一個幾有方向感的研究型專案。佢主要針對一個常見問題:模型唔係唔努力,而係好多時只會喺自己熟悉的解題路線入面打轉,結果要靠大量重複抽樣先撞到更好答案。

NudgeRL的做法唔係一味加大運算量,而係先提供較輕量的「策略層面背景」,引導模型用唔同思路展開推理,再將當中有效的行為學返去原本模型。簡單講,即係先畀方向去探索,再將成功經驗整理吸收,呢點比純粹盲試更有系統。

實際上手方面,呢個儲存庫已經分好幾部分:資料建立、訓練基線、NudgeRL訓練,同埋評估流程。較適合本身已經會用 Python、PyTorch、CUDA 同 vLLM 的研究者;如果你係一般開發者,都可以先由評估腳本、資料格式同設定檔入手,理解整體流程先。

  • 針對數學推理中的探索不足,而唔係只求更大抽樣數量
  • 內置 GRPO 同 POPE 風格基線,方便比較方法差異
  • 提供 DAPO-Math-17k 相關資料建構工具,唔使由零砌流程
  • 評估涵蓋 AIME、AMC23、MATH500、Apex Shortlist 等數學基準
  • 核心特色係將多樣化策略探索同後續行為蒸餾結合

如果你想比較相關模型或訓練路線,呢個專案最直接涉及的包括以 GRPO 為代表的 RLVR 方法、POPE 風格 oracle-prefix 基線,以及可配合 Hugging Face 模型與 LoRA adapter 的訓練評估流程。整體而言,NudgeRL較適合做推理增強、數學能力研究、後訓練方法比較的人;對想了解「如何更有效探索」而唔係「如何堆更多算力」的讀者,尤其有參考價值。

網址: https://github.com/tally0818/NudgeRL

網址: https://arxiv.org/pdf/2605.15726

Categories: 開源, 香港中文大學, 模型訓練, 深度學習

Page 4 of 7
1 2 3 4 5 6 7