NexaSDK 全模型支持,全硬件兼容

NexaSDK 是一個高性能的本地推理框架,可以在 NPU、GPU 和 CPU 上運行最新的多模態 AI 模型,支持 Android、Windows、Linux、macOS 和 iOS 設備。它只需幾行代碼,就能在設備上搭建最智能、最快的 AI 應用。NexaSDK 支持最新的模型,比如 Qwen3-VL、DeepSeek-OCR、Gemma3n 等,且比其他框架提前幾周或幾個月支持。。 使用 NexaSDK 建立真正的裝置端 AI 應用,將有獲得獎勵。(詳情) 另外,NexaSDK 還提供了一個簡單易用的命令列介面(CLI),讓使用者可以快速測試不同的模型。例如,你可以用一行指令就開始與 Qwen3 模型聊天,或者進行多模態任務,比如拖曳圖片到 CLI 裡進行處理。

NexaSDK 是一個高性能的本地推理框架,可以在 NPU、GPU 和 CPU 上運行最新的多模態 AI 模型,支持 Android、Windows、Linux、macOS 和 iOS 設備。它只需幾行代碼,就能在設備上搭建最智能、最快的 AI 應用。NexaSDK 支持最新的模型,比如 Qwen3-VL、DeepSeek-OCR、Gemma3n 等,且比其他框架提前幾周或幾個月支持。。

使用 NexaSDK 建立真正的裝置端 AI 應用,將有獲得獎勵。(詳情)

另外,NexaSDK 還提供了一個簡單易用的命令列介面(CLI),讓使用者可以快速測試不同的模型。例如,你可以用一行指令就開始與 Qwen3 模型聊天,或者進行多模態任務,比如拖曳圖片到 CLI 裡進行處理。

Categories: 開源, , 編程

VINO 多模態模型對齊提示生成圖像與影片

VINO 是個統一的視覺生成工具,能同時處理圖像和影片的創作與編輯,無需針對每種任務去找不同的模型。它的核心架構是把視覺語言模型和多模態擴散轉換器(MMDiT)結合起來,讓文字、參考圖片或影片都能以同一套條件流動的方式被傳遞給擴散過程。 這裡的「可學習查詢 token」扮演的角色是把使用者的簡短指令轉化成模型能理解的細節向量,並在訓練時一起調整,讓指令更精確、模型更穩定。另一個關鍵在於把參考影像或影片所產生的特徵與它在 latent 空間的對應向量用同樣的開始與結束標記包起來,這樣模型就能在語意層面和潛在層面都把同一個參考資源針對地辨識出來,減少身份混淆或屬性遺漏的問題。

VINO 是個統一的視覺生成工具,能同時處理圖像和影片的創作與編輯,無需針對每種任務去找不同的模型。它的核心架構是把視覺語言模型和多模態擴散轉換器(MMDiT)結合起來,讓文字、參考圖片或影片都能以同一套條件流動的方式被傳遞給擴散過程。

這裡的「可學習查詢 token」扮演的角色是把使用者的簡短指令轉化成模型能理解的細節向量,並在訓練時一起調整,讓指令更精確、模型更穩定。另一個關鍵在於把參考影像或影片所產生的特徵與它在 latent 空間的對應向量用同樣的開始與結束標記包起來,這樣模型就能在語意層面和潛在層面都把同一個參考資源針對地辨識出來,減少身份混淆或屬性遺漏的問題。

Categories: 開源, 視覺模型, 視頻模型, 影像模型, 影像處理

InfiniDepth 解析二維深度圖

InfiniDepth 把傳統的深度圖想成一個可以在任何二維座標上即時查詢的隱式場(Implicit Field),而不是固定在像素格子裡。這樣的表示方式讓模型不再受到訓練解析度的限制,能夠直接輸出任意高解析度的深度圖,同時保留更細緻的幾何細節。  

InfiniDepth 把傳統的深度圖想成一個可以在任何二維座標上即時查詢的隱式場(Implicit Field),而不是固定在像素格子裡。這樣的表示方式讓模型不再受到訓練解析度的限制,能夠直接輸出任意高解析度的深度圖,同時保留更細緻的幾何細節。  

Categories: 開源, 視覺模型, 影像處理

NeoVerse 4D 世界模型

NeoVerse 是一種強大的 4D 世界模型,專門設計來處理現實環境中的單眼視頻,從而實現多種應用。這個模型的核心優勢在於它能夠進行無姿態限制的前饋 4D 重建,這意味著它可以從普通的單眼視頻中直接生成高質量的 4D 場景,而不需要複雜的多視角數據或預處理步驟。

NeoVerse 是一種強大的 4D 世界模型,專門設計來處理現實環境中的單眼視頻,從而實現多種應用。這個模型的核心優勢在於它能夠進行無姿態限制的前饋 4D 重建,這意味著它可以從普通的單眼視頻中直接生成高質量的 4D 場景,而不需要複雜的多視角數據或預處理步驟。

Categories: 開源, 視覺模型, 視頻模型, 世界模型, 影像模型, 影像處理

DreamID-V 開源換臉

DreamID-V 是一個專門為高保真度臉部交換設計的技術,它旨在縮短圖像到視頻之間的差距。這技術在處理各種挑戰性場景時表現出色,包括頭髮遮擋、複雜光照、多樣化的種族和顯著的臉型變化。DreamID-V 的應用範圍廣泛,可以應用於娛樂、廣告和電影製作等領域,考慮到了實際應用中的多種需求和挑戰。提供更加逼真的臉部交換效果。 對於使用者來說,DreamID-V 提供了單 GPU 和多 GPU 推理的選項,並且有詳細的安裝和使用指南。使用者需要準備好相應的模型文件和依賴庫,然後根據提供的腳本進行操作。此外,DreamID-V 還支持不同的模型版本,例如 DreamID-V-Wan-1.3B-DWPose,這進一步提升了姿態檢測的穩定性和魯棒性。

DreamID-V 是一個專門為高保真度臉部交換設計的技術,它旨在縮短圖像到視頻之間的差距。這技術在處理各種挑戰性場景時表現出色,包括頭髮遮擋、複雜光照、多樣化的種族和顯著的臉型變化。DreamID-V 的應用範圍廣泛,可以應用於娛樂、廣告和電影製作等領域,考慮到了實際應用中的多種需求和挑戰。提供更加逼真的臉部交換效果。

對於使用者來說,DreamID-V 提供了單 GPU 和多 GPU 推理的選項,並且有詳細的安裝和使用指南。使用者需要準備好相應的模型文件和依賴庫,然後根據提供的腳本進行操作。此外,DreamID-V 還支持不同的模型版本,例如 DreamID-V-Wan-1.3B-DWPose,這進一步提升了姿態檢測的穩定性和魯棒性。

Categories: 開源, 字節跳動, 數字人, 視頻模型


Conductor – Google 的 Spec Coding

Conductor 是 Google 推出的一個 Gemini CLI 擴充套件,目前處於預覽階段,它透過「脈絡導向開發」(context-driven development)改變開發流程,讓開發者在編寫程式碼前先建立正式規格與計劃,並將其儲存為持久化的 Markdown 檔案。

Conductor 是 Google 推出的一個 Gemini CLI 擴充套件,目前處於預覽階段,它透過「脈絡導向開發」(context-driven development)改變開發流程,讓開發者在編寫程式碼前先建立正式規格與計劃,並將其儲存為持久化的 Markdown 檔案。

Gemini Conductor Full Tutorial For Beginners
Categories: 開源, Google, Gemini, 教學, 編程

SimpleMem 高效終生記憶框架

SimpleMem 是專為 LLM 代理設計的高效終生記憶框架,透過語義無損壓縮來管理歷史經驗,提升長期互動效能。 SimpleMem 採用三階段管線:語義結構化壓縮(過濾冗餘並轉換為獨立記憶單元)、遞迴記憶整合(異步合併相關單元成抽象表示)和自適應查詢檢索(依查詢複雜度動態調整範圍)。 此設計受互補學習系統理論啟發,解決上下文膨脹和 token 浪費問題。

SimpleMem 是專為 LLM 代理設計的高效終生記憶框架,透過語義無損壓縮來管理歷史經驗,提升長期互動效能。

SimpleMem 採用三階段管線:語義結構化壓縮(過濾冗餘並轉換為獨立記憶單元)、遞迴記憶整合(異步合併相關單元成抽象表示)和自適應查詢檢索(依查詢複雜度動態調整範圍)。 此設計受互補學習系統理論啟發,解決上下文膨脹和 token 浪費問題。

Categories: 開源, Agentic, 編程

端到端小型 LLM 微調教學

示範如何在本地使用 NVIDIA DGX Spark 或 Google Colab 微調 Google 的 Gemma 3 270M 模型,從資料準備到模型部署與 Gradio 示範。

示範如何在本地使用 NVIDIA DGX Spark 或 Google Colab 微調 Google 的 Gemma 3 270M 模型,從資料準備到模型部署與 Gradio 示範。

End-to-End (small) LLM Fine-tuning Tutorial (from data to model to live demo) | On DGX Spark
Categories: 開源, 模型訓練, 教學

CoV 提升視覺語言的空間推理能力

CoV (Chain-of-View Prompting for Spatial Reasoning) 可以用於各種需要在複雜三維環境中進行精確空間理解的場景。例如 VR 和 AR,CoV 可以幫助系統更好地理解和響應用戶在虛擬環境中的查詢,提供更自然、更沉浸式的體驗。在自動駕駛領域,CoV 可以增強車輛對周圍環境的理解能力,提高其在複雜道路條件下的導航和決策能力。 CoV 提出一種創新方法,專門針對在三維環境中的具身問答(Embodied Question Answering, EQA)問題。傳統的視覺語言模型(Vision-Language Models, VLMs)受限於固定的輸入視角,這使得它們在推理過程中無法動態地獲取與問題相關的上下文信息,進而限制了複雜空間推理的能力。CoV 通過引入一種免訓練、僅在測試階段運行的框架來解決這一問題,該框架能夠讓 VLMs 變成主動的視角推理器。
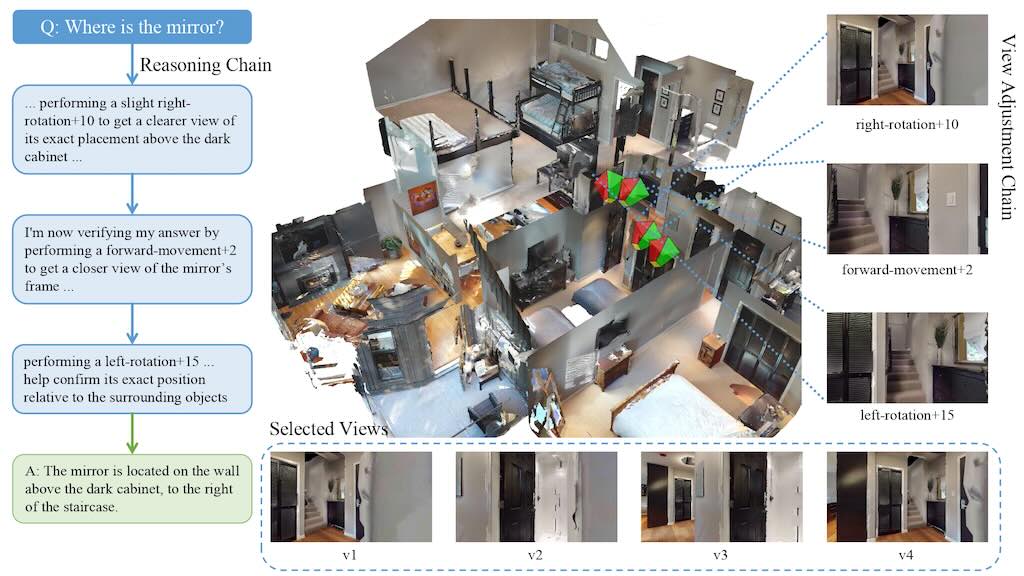
CoV (Chain-of-View Prompting for Spatial Reasoning) 可以用於各種需要在複雜三維環境中進行精確空間理解的場景。例如 VR 和 AR,CoV 可以幫助系統更好地理解和響應用戶在虛擬環境中的查詢,提供更自然、更沉浸式的體驗。在自動駕駛領域,CoV 可以增強車輛對周圍環境的理解能力,提高其在複雜道路條件下的導航和決策能力。

CoV 提出一種創新方法,專門針對在三維環境中的具身問答(Embodied Question Answering, EQA)問題。傳統的視覺語言模型(Vision-Language Models, VLMs)受限於固定的輸入視角,這使得它們在推理過程中無法動態地獲取與問題相關的上下文信息,進而限制了複雜空間推理的能力。CoV 通過引入一種免訓練、僅在測試階段運行的框架來解決這一問題,該框架能夠讓 VLMs 變成主動的視角推理器。

Categories: 開源, 視覺模型, Qwen

Page 75 of 90
1 73 74 75 76 77 90