Prompt-Relay:一種推論階段、即插即用的多事件生成時間控制方法

Prompt Relay 應對視頻生成中的時間控制挑戰,增強一致性與對齊。對於尋求精確敘事的視頻合成創作者來說,這是理想的選擇。

Prompt Relay 標誌
GordonChen19/Prompt-Relay 在 GitHub 上

Prompt Relay 是一種令人信服的解決方案,適用於那些應對視頻生成中時間控制複雜性的挑戰。這種由 Gordon Chen、Ziqi Huang 和 Ziwei Liu 開發的推論階段方法,解決了當前視頻擴散模型中的一個重要缺口:管理視頻中多個事件的精確時間、持續時間和順序的能力。通過在交叉注意力機制中引入時間路徑先驗,Prompt Relay 確保每個提示被定位到其預定的片段,從而改善時間對齊、轉場自然性和視覺質量。這對於需要連貫敘事的應用特別有價值,例如電影級合成或詳細動畫。

對於希望增強視頻生成能力的創作者和開發者,Prompt Relay 提供了一個簡單的起點。該方法專注於通過距離基於的懲罰修改交叉注意力機制,抑制潛在查詢和提示令牌在其指定區間之外的注意力。這種方法允許用戶在不需重新訓練基礎模型的情況下,微調視頻生成的時間方面。這種即插即用解決方案的簡單性意味著用戶可以快速將其整合到現有流程中,使其適用於廣泛的應用。

在實踐中,Prompt Relay 通過採用一個全局提示來條件整個視頻和一系列本地提示,每個本地提示對應一個特定的時間段。全局提示有助於在整個視頻中維持一致的角色、物件和場景上下文,而本地提示則為個別片段提供詳細指令。這種雙提示系統確保視頻的每個部分都由適當的指令引導,減少語義滲漏並改善整體一致性。用戶應專注於編寫清晰和具體的提示,以最大化這種方法的好處。

Prompt Relay 的創作者通過各種定性結果展示了其有效性。該方法顯著改善了時間對齊,確保每個事件在其預定的時間框架內發生。它還增強了轉場自然性,使不同事件之間的交接更為順暢和無縫。此外,Prompt Relay 通過最小化交叉注意力中的不必要的競爭,提升了視覺質量,從而實現更清晰和更穩定的多事件生成。這些改進在與基線提示策略和一些最近的強大模型如 Kling 3.0 相比時尤為顯著。

提示中繼功能改進:

  • 時間對齊,即將每條指令限制在其分配的段落內。
  • 透過確保事件在不同時間點之間的平穩交接,實現過渡的自然性
  • 透過減少不必要的注意力交叉競爭來提高視覺品質。

Prompt Relay 的性能始終優於基準提示策略,與Kling 3.0等近期推出的優秀模型相比也保持競爭力。尤其值得一提的是,Wan 2.2 + Prompt Relay通常比基礎 Wan 2.2 模型能夠產生更強大的視覺結構和更穩定的多事件。

指標(↓)索拉(故事板)Kling 2.6Veo 3.1Wan 2.2Wan 2.2 + 即時中繼(我們的)
時間對齊4.671.303.934.001.10
過渡自然性4.604.431.303.501.17
視覺品質3.672.502.04.002.83

對視頻生成的時間方面進行精確控制的內容創作者、動畫師和開發者。例如,電影製作者可以使用這種方法創建更連貫和引人入勝的敘事線,而動畫師可以產生更順暢和詳細的動畫。需要注意的權衡包括編寫詳細提示的潛在複雜性和為實現最佳結果而需仔細校準距離基於的懲罰。用戶應嘗試不同的設置和提示結構,以找到適合其特定需求的最佳配置。

雖然 Prompt Relay 中使用的具體模型沒有明確提及,但似乎與各種視頻擴散模型兼容,包括 Wan 2.2。這種兼容性允許用戶利用不同模型的優勢,同時受益於 Prompt Relay 提供的時間控制。該方法的靈活性和易於整合性使其成為任何希望增強視頻生成能力的人的寶貴工具。通過應對時間控制的挑戰,Prompt Relay 為視頻合成領域的創意和技術應用打開了新的可能性。

總之,Prompt Relay 提供了一種實用且有效的解決方案,用於改善視頻生成中的時間控制。其簡單的實現和顯著的好處使其成為內容創作者和開發者的有吸引力的選擇。通過專注於編寫詳細的提示和仔細校準該方法的參數,用戶可以實現更連貫、自然和視覺上更具吸引力的視頻。儘管可能需要考慮一些權衡,但 Prompt Relay 的整體優勢使其成為任何視頻生成工具包的值得添加的內容。
Source: https://github.com/GordonChen19/Prompt-Relay/

Categories: 開源, 視頻模型, 影像處理

SpatialEdit:精細圖像空間編輯的基準測試

SpatialEdit 提供對圖像空間編輯的精確控制,適合開發人員和研究人員使用。深入了解其在物件和相機操作方面的功能。

01
EasonXiao-888/SpatialEdit 在 GitHub 上

SpatialEdit 是一款開創性的工具,適用於對圖像進行精細空間編輯感興趣的人士。它特別適用於需要對物件運動、旋轉、3D視角、構圖和相機移動進行精確控制的開發人員、研究人員和愛好者。該工具不僅僅改變圖像的外觀,還能實現詳細的空間操作。對於任何想深入這一領域的人,首先應該關注 SpatialEdit 的核心功能,例如它處理3D點控制、基於條件幀的視頻生成、相機軌跡轉換、物件移動和物件旋轉的能力。這些功能通過倉庫中的各種應用示範,提供了該工具在實踐中可以實現的清晰視圖。

在實踐中,SpatialEdit 通過結合先進的模型和合成數據集來工作。例如,SpatialEdit-500K 數據集是一個使用可控制的Blender管道生成的合成訓練集。該數據集為物件中心和相機中心操作提供了精確的真實轉換,使其對於可擴展的訓練無價之寶。建立在這些數據上的 SpatialEdit-16B 模型,作為精細空間編輯的基線,不僅在一般編輯任務上達到競爭性表現,而且在空間操作上表現出色。用戶應注意運行代碼所需的先決條件和外部檢查點,例如用於相機級基準評估的VGGT和用於構圖評估的YOLO26x。

從中受益最大的人是那些從事計算機視覺、圖像處理和機器學習研究的人。研究人員可以使用基準測試套件 SpatialEdit-Bench 來評估他們的空間編輯模型的有效性。該基準聯合測量感知逼真度和幾何保真度,確保編輯的圖像不僅在視覺上可信,而且在幾何上準確。對於開發人員,SpatialEdit 提供了一個堅固的框架,用於創建需要對圖像進行精確空間控制的應用,例如在虛擬現實、增強現實和數字內容創作中。

然而,需要考慮一些權衡。設置過程可能很複雜,需要兼容的CUDA和PyTorch環境來運行閃電注意力機制。此外,一些配置文件包含需要在運行推理之前更新的佔位符或內部路徑。用戶還應注意,基準腳本假設可以訪問外部基準元數據、源圖像和模型檢查點。這些要求對於新入行的人可能構成挑戰,但倉庫中提供的詳細文檔和示例評估工具可以幫助減輕這些問題。

總之,SpatialEdit 是一個強大的空間基礎圖像編輯工具,提供對各種空間轉換的精確控制。它最適合需要進行精細空間操作的研究人員和開發人員。用戶應專注於了解該工具的核心功能和先決條件,同時注意其中的權衡。通過利用 SpatialEdit-500K 數據集和 SpatialEdit-16B 模型,可以在空間編輯任務中達到競爭性表現。對於計算機視覺和圖像處理領域的人來說,其好處是顯著的,但要充分利用該工具的潛力,需要仔細設置和配置。

  • 主要功能:3D點控制、基於條件幀的視頻生成、相機軌跡轉換、物件移動和物件旋轉。
  • 目標受眾:計算機視覺、圖像處理和機器學習領域的研究人員、開發人員和愛好者。
  • 權衡:複雜的設置過程、需要兼容的硬體和軟體環境,以及更新配置文件中的內部路徑。

Source: https://github.com/EasonXiao-888/SpatialEdit

Categories: 開源, 影像處理


Pulse of Motion 讓影片更自然

Pulse of Motion 讓你在觀看影片時「感覺更舒服」,但看不到技術本身。目前很多生成影片(如 SVD、Pika 等)的動作時間常常跑偏,作者稱這種現象為 chronometric hallucination,也就是「看起來平滑但實際上時間尺度錯亂」。 現在很多生成模型會「時間錯亂」角色走路太快/太慢;手勢、動作和音效不搭;看起來動作很順,但「感覺怪怪的」。這套技術可以用來:調整生成模型的輸出(例如:自動快慢放或重採樣),讓影片「更像真實拍攝」,看起來更舒服。自動檢測影片的 真實時間尺度;

Pulse of Motion 讓你在觀看影片時「感覺更舒服」,但看不到技術本身。目前很多生成影片(如 SVD、Pika 等)的動作時間常常跑偏,作者稱這種現象為 chronometric hallucination,也就是「看起來平滑但實際上時間尺度錯亂」。

現在很多生成模型會「時間錯亂」角色走路太快/太慢;手勢、動作和音效不搭;看起來動作很順,但「感覺怪怪的」。這套技術可以用來:調整生成模型的輸出(例如:自動快慢放或重採樣),讓影片「更像真實拍攝」,看起來更舒服。自動檢測影片的 真實時間尺度

Categories: 開源, 視頻模型, 影像處理, 中國

RealRestorer – 通用真實世界影像復原

RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。

RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。

Categories: 開源, 影像模型, 影像處理

Utonia – Point Cloud 的單一編碼器

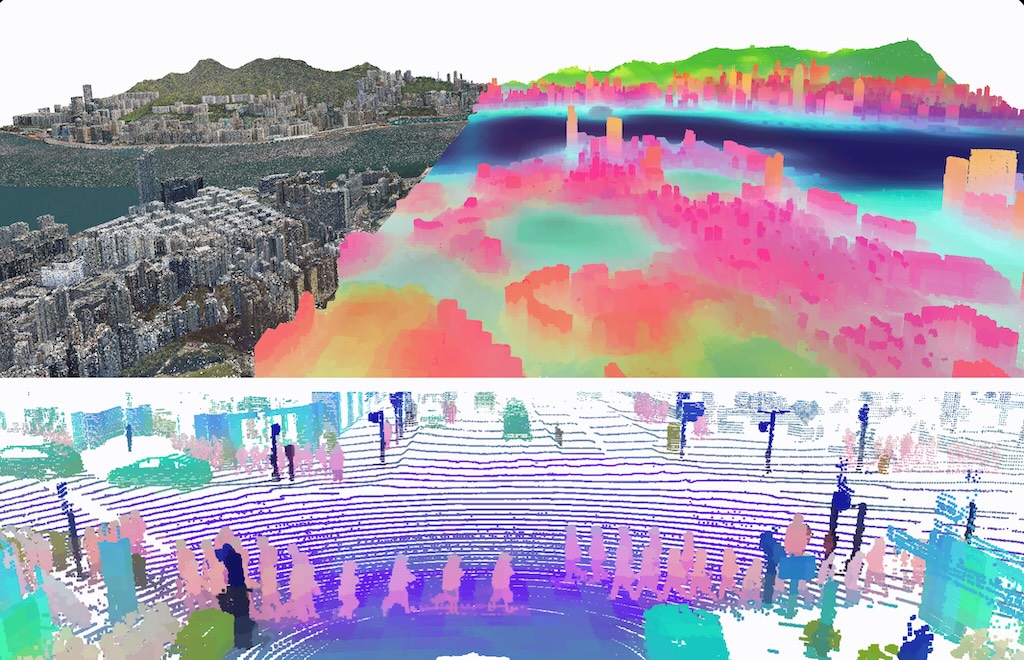
Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。 Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。 跨域資料混合:研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。

Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。

跨域資料混合
研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Categories: 開源, 香港中文大學, 影像模型, 影像處理

InteractAvatar 互動數字人

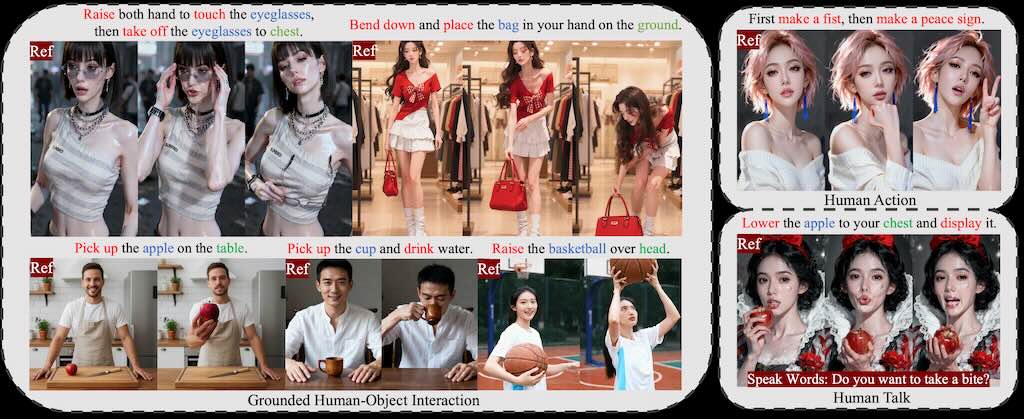
InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。 雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。

InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。

雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。

Categories: 開源, 騰訊, 數字人, 視頻模型, 影像模型, 影像處理

DreamActor-M2 基於時空上下文動畫

DreamActor-M2 是一個通用的角色圖像動畫框架,它將運動條件化重新定義為時空上下文學習任務。我們的設計利用了視訊基礎模型固有的生成先驗訊息,同時實現了從原始視訊直接進行無姿態、端到端運動遷移的關鍵演進。這種範式消除了明確姿態估計的需求,使得DreamActor-M2 能夠在各種複雜場景中實現卓越的泛化能力和高保真度的結果。

DreamActor-M2 是一個通用的角色圖像動畫框架,它將運動條件化重新定義為時空上下文學習任務。我們的設計利用了視訊基礎模型固有的生成先驗訊息,同時實現了從原始視訊直接進行無姿態、端到端運動遷移的關鍵演進。這種範式消除了明確姿態估計的需求,使得
DreamActor-M2 能夠在各種複雜場景中實現卓越的泛化能力和高保真度的結果。

Categories: 開源, 字節跳動, 視頻模型, 影像模型, 影像處理

ShapeR 隨拍可還原 3D 場景

ShapeR 是以 rectified‑flow 為基礎的生成模型,能直接從日常拍攝的影像序列(即「不規則」捕捉)重建高保真的三維物件。整體流程大致可以分成幾個步驟: 先用現成的視覺‑慣性 SLAM 演算法把鏡頭移動和稀疏點雲拿出來,接著再交給 3D 物件偵測器把每個目標物分割出來。每個偵測到的物件會得到幾張具備相機位姿的多視角圖片、一組稀疏的 SLAM 點,還有一段由視覺語言模型自動產生的文字說明。這些資訊(點雲、多視圖、文字)會被封裝成一個多模态的條件向量,送給訓練好的 rectified‑flow Transformer 去去噪。 Transfomer 輸出的 latent VecSet 接著經過一個 3D VAE 解碼,最後生成完整的三維網格。整個模型只需要在合成資料上先做大量的單物件預訓練,接著再在更具挑戰性的合成場景與真實場景資料上進行兩階段的訓練,過程中會不斷加入各種自然的背景、遮擋、噪聲以及 augmentations,讓模型學會在「雜亂」的環境下仍保持穩定。 研究團隊也釋出了一個專屬的評估資料集:裡面有 178 個真實世界的物件分布在七個場景中,配有完整的地面真值網格、配對好的多視圖影像、SLAM 點雲與文字描述。這筆資料專門用來測試在野外捕捉時的遮擋、雜亂、解析度變化等情況,讓模型在更貼近實務的條件下接受測試。 在測試結果上,ShapeR 在 Chamfer Distance 指標上比目前最好的方法提升了 2.7 倍,顯示出在「不規則」情境下的穩定性確實比先前的單視圖或全局場景重建方式更佳。相較於同樣流行的 SAM3D 方法,ShapeR 的特色在於它利用多視圖的幾何資訊(SLAM 點、相機位姿)來保證形狀的尺度與真實感,而 SAM3D 則依賴單張圖像與互動,對於規模和視角的一致性較弱。兩者其實可以互補——把 ShapeR 的幾何結果再送給 SAM3D 生成更豐富的材質或細節。 總結來說,ShapeR 透過把 SLAM 點雲、3D 偵測、多視圖影像和自動文字說明這幾種資訊全部結合起來,做出一個能在日常拍攝場景下產生高品質、具備度量真實性的單物件三維形狀的生成模型,並提供了完整的測試素材與模型資源讓研究者直接使用。 面向 ShapeR SAM3D 輸入 多視角序列 + […]

ShapeR 是以 rectified‑flow 為基礎的生成模型,能直接從日常拍攝的影像序列(即「不規則」捕捉)重建高保真的三維物件。整體流程大致可以分成幾個步驟:

先用現成的視覺‑慣性 SLAM 演算法把鏡頭移動和稀疏點雲拿出來,接著再交給 3D 物件偵測器把每個目標物分割出來。每個偵測到的物件會得到幾張具備相機位姿的多視角圖片、一組稀疏的 SLAM 點,還有一段由視覺語言模型自動產生的文字說明。這些資訊(點雲、多視圖、文字)會被封裝成一個多模态的條件向量,送給訓練好的 rectified‑flow Transformer 去去噪。

Transfomer 輸出的 latent VecSet 接著經過一個 3D VAE 解碼,最後生成完整的三維網格。整個模型只需要在合成資料上先做大量的單物件預訓練,接著再在更具挑戰性的合成場景與真實場景資料上進行兩階段的訓練,過程中會不斷加入各種自然的背景、遮擋、噪聲以及 augmentations,讓模型學會在「雜亂」的環境下仍保持穩定。

研究團隊也釋出了一個專屬的評估資料集:裡面有 178 個真實世界的物件分布在七個場景中,配有完整的地面真值網格、配對好的多視圖影像、SLAM 點雲與文字描述。這筆資料專門用來測試在野外捕捉時的遮擋、雜亂、解析度變化等情況,讓模型在更貼近實務的條件下接受測試。

在測試結果上,ShapeR 在 Chamfer Distance 指標上比目前最好的方法提升了 2.7 倍,顯示出在「不規則」情境下的穩定性確實比先前的單視圖或全局場景重建方式更佳。相較於同樣流行的 SAM3D 方法,ShapeR 的特色在於它利用多視圖的幾何資訊(SLAM 點、相機位姿)來保證形狀的尺度與真實感,而 SAM3D 則依賴單張圖像與互動,對於規模和視角的一致性較弱。兩者其實可以互補——把 ShapeR 的幾何結果再送給 SAM3D 生成更豐富的材質或細節。

總結來說,ShapeR 透過把 SLAM 點雲、3D 偵測、多視圖影像和自動文字說明這幾種資訊全部結合起來,做出一個能在日常拍攝場景下產生高品質、具備度量真實性的單物件三維形狀的生成模型,並提供了完整的測試素材與模型資源讓研究者直接使用。

ShapeR: Robust Conditional 3D Shape Generation from Casual Captures
面向ShapeR SAM3D
輸入多視角序列 + SLAM 點 + caption 等多模態單張影像 +(物件時多半要 mask / 互動)
任務重點場景級、物件為中心的度量重建與佈局單視圖高品質幾何 + 貼圖的物體/人體重建​
幾何精度強調 metric accuracy、相對尺度與佈局一致性可缺乏精確比例與 layout,特別是複雜場景​
紋理 / 外觀較偏幾何與場景結構(官網重點在 shape)​強調 photoreal 紋理與真實外觀 priors
互動需求不需要使用者互動,pipeline 自動處理需要物件 mask / prompt,屬於 promptable / interactive workflow​
訓練數據合成多模態場景(SLAM + 多視圖)大規模真實 image→3D(Objects/Body 各自的 dataset)
適合場景AR 眼鏡 / 機器人多視角感知、場景 mapping、學術評測商業應用:電商 AR、human pose & shape、單圖 3D content creation
Categories: 開源, 視覺模型, 影像處理

CoF-T2I 漸進式視覺推理模型

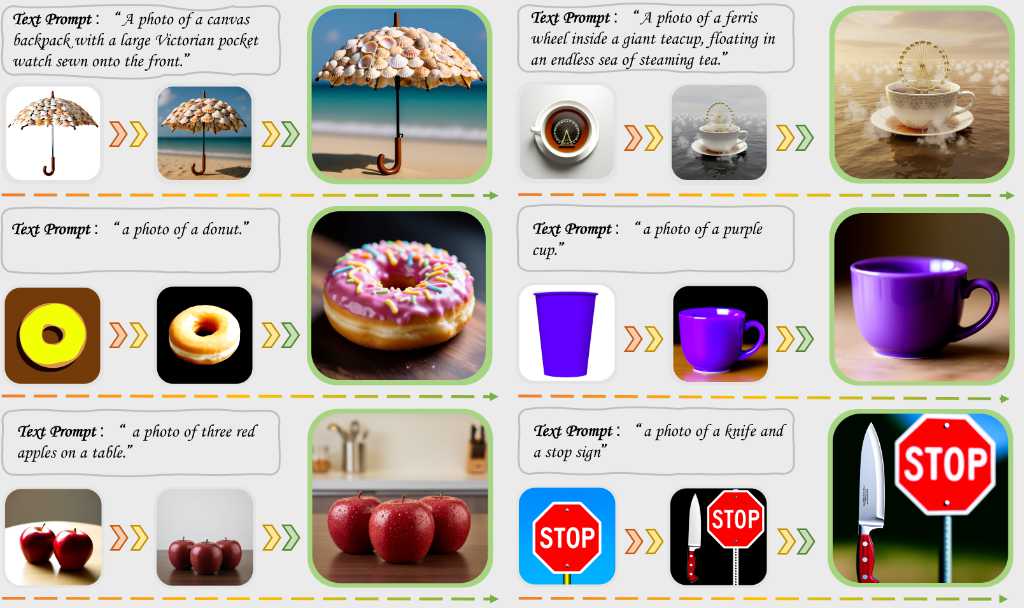
CoF-T2I 模型透過漸進式視覺細化,將 CoF 推理整合到 T2I 生成過程中,其中中間幀作為顯式推理步驟,最終幀作為輸出。為了建立這種明確生成過程,CoF-T2I 建立了CoF-Evol-Instruct 資料集,該資料集包含從語義到美學的 CoF 軌跡,用於建模生成過程。為了進一步提高品質並避免運動偽影,CoF-T2I 對每一幀都進行了獨立編碼。實驗表明,CoF-T2I 的性能顯著優於基礎視訊模型,並達到了具有競爭力的水平。

CoF-T2I 模型透過漸進式視覺細化,將 CoF 推理整合到 T2I 生成過程中,其中中間幀作為顯式推理步驟,最終幀作為輸出。為了建立這種明確生成過程,CoF-T2I 建立了CoF-Evol-Instruct 資料集,該資料集包含從語義到美學的 CoF 軌跡,用於建模生成過程。為了進一步提高品質並避免運動偽影,CoF-T2I 對每一幀都進行了獨立編碼。實驗表明,CoF-T2I 的性能顯著優於基礎視訊模型,並達到了具有競爭力的水平。

Categories: 開源, 視覺模型, 影像處理, 推理引擎

Page 10 of 21
1 8 9 10 11 12 21