RoboJudge:把影片的物理合理性與指令分開評測

RoboJudge 分開檢視具身影片的物理合理性與指令完成度,並以人類評分訓練模型,供團隊比較生成結果。

RoboJudge overview

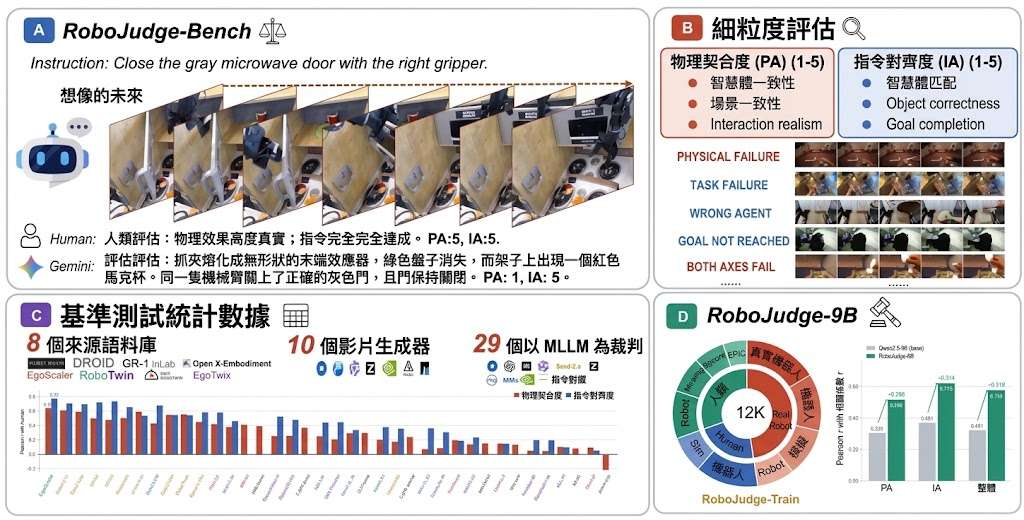
具身影片可能動作自然卻未完成指令,也可能完成任務但違反物理規律。RoboJudge 以 Multimodal Language Models (MLLMs) 評審生成影片,分開衡量 Physical Adherence (PA,物理遵循) 與 Instruction Alignment (IA,指令符合度)。

這有助機械人及具身世界模型團隊分辨動作可信度和任務完成度。RoboJudge-Bench 收錄 800 段人工標註影片,涵蓋 8 個語料來源、10 個影片生成器,以及夾爪、人手與靈巧手。

RoboJudge-Train 收錄 12,000 段影片及 25,000 筆人工評分與理由;RoboJudge-9B 經監督學習及強化學習訓練。Pearson 相關係數在 PA 為 0.645、IA 為 0.775、整體為 0.719,較測試中的最佳專有基線高 0.089;相關性不代表每次判斷都正確。

GitHub 提供推理和基準評估程式,並連結模型與資料集。README 列出依賴安裝及執行流程,但沒有硬件需求資料,採用前宜先確認設備能否負擔模型載入與影片處理。

  • PA 檢視影片是否符合物理與時間約束。
  • IA 檢視影片動作是否符合指令。
  • 基準可用於比較評分,不能取代人工核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, Dataset 數據集, 強化學習

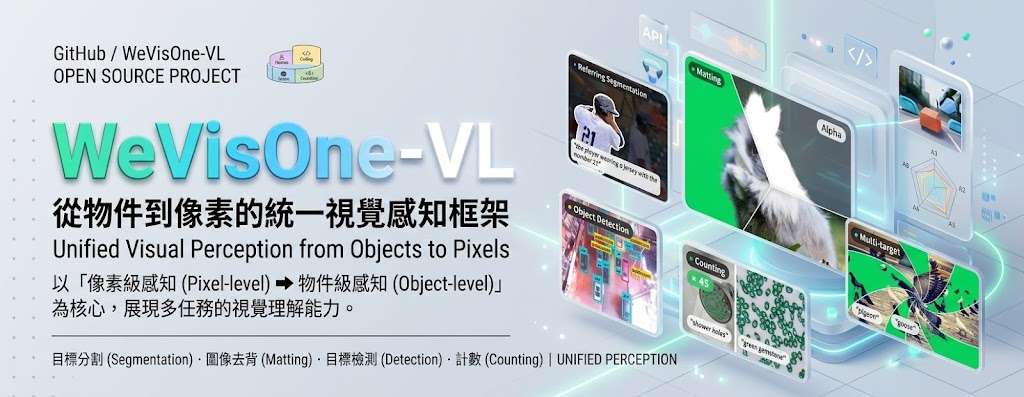
WeVisOne-VL 整合多種視覺任務

由座標定位延伸至遮罩與透明度摳圖,WeVisOne-VL 把多種視覺任務整合在一個模型,並以輕量解碼器處理像素輸出。

WeChat Vision

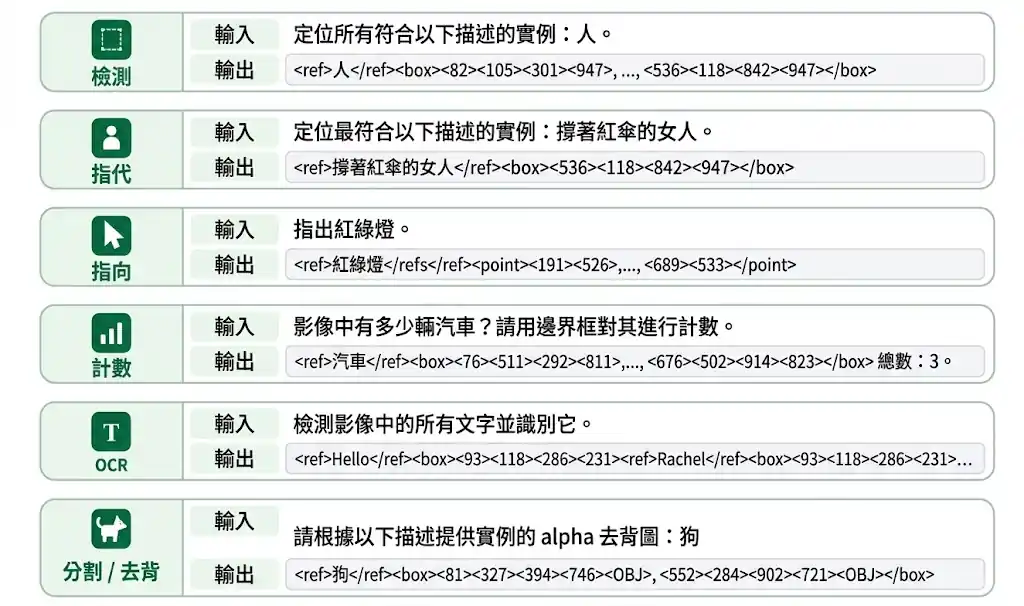
要在一張圖中找出物件、讀取文字,再按需要輸出座標、遮罩或透明度邊緣,WeVisOne-VL 把物件層級與像素層級工作整合為視覺語言模型(Vision-Language Model,VLM),適合標註及影像檢查流程。

模型建基於 Qwen3-VL,以 structured next-token prediction 生成定位結果:座標 token 表示點與框, token 則觸發像素解碼器。解碼器只有 9.6M 參數,重用 Vision Transformer(ViT)特徵,不需 Segment Anything Model(SAM)或外置分割骨幹,可輸出二值遮罩與連續 alpha matte。

任務涵蓋物件偵測、指稱定位、計數、指點、光學字元辨識(Optical Character Recognition,OCR)、指稱分割及 promptable alpha matting;找不到指定目標時會回傳 None,減少虛構定位。需要在同一流程處理定位、分割與前景摳圖的團隊,可評估它是否適合自身資料和任務。

  • 提供 2B、4B 模型權重、推理套件、Cookbooks、Gradio 示範及評測流程。
  • 微調程式碼尚未提供;資料亦未列出硬件需求或逐步安裝方式。
  • 項目在 30 多項基準測試領先。

項目主頁 · GitHub

Categories: 開源, 騰訊, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Image, Medical醫學

從影片理解世界:統一 Video World Models 的四種能力

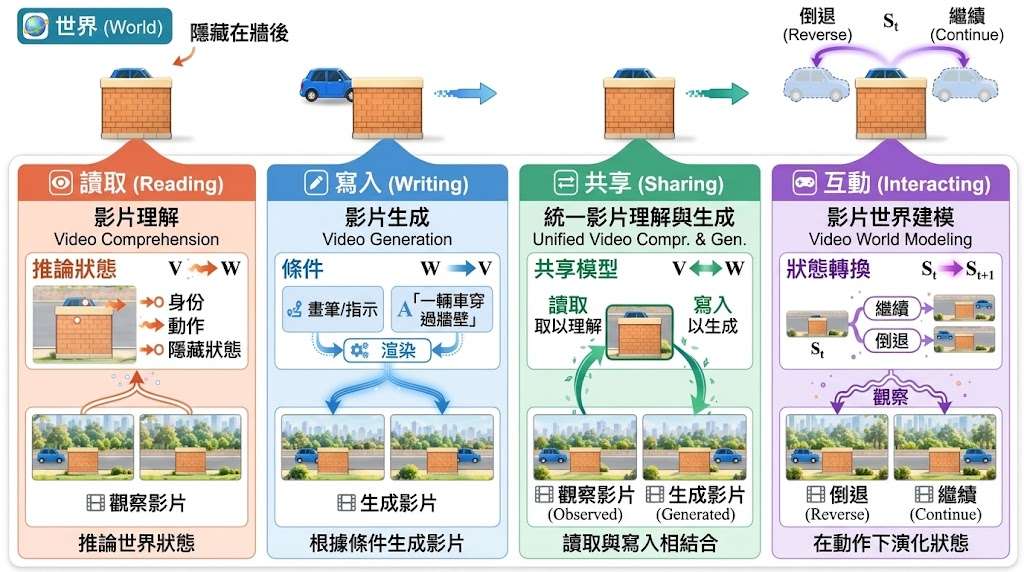
一份涵蓋 669 篇參考文獻的調查,整理影片模型如何讀取、生成、共享及互動於不斷變化的世界。

Og image

當模型要由片段影片理解場景、推演未來,甚至回應外部行動時,單純辨認畫面中的物件並不足夠。這份影片世界模型調查以影片與世界狀態的關係為主線,整理 Video Foundation Models 如何處理觀察不完整、時間變化和因果推理等問題。

調查將能力分成四個互相關聯的操作:Reading 從影片讀取語意、空間、時間、物理及因果資訊;Writing 生成可能發生的未來;Sharing 建立可供不同任務共用的表示;Interacting 則把感知結果連接到行動、控制和環境回應。內容涵蓋影片表示學習、Video-LLMs、影片生成、影片代理及世界預測等方向。

影片只是世界的部分記錄,而且可能遺失被遮擋的物件、視角以外的資訊或事件之間的因果關係。調查因此區分 temporal coherence 與 world consistency:畫面可以連續流暢,但物件再次出現時未必保持同一身份;鏡頭突然切換,也不一定代表世界狀態中斷。

• 以世界狀態統一影片理解與生成
• 覆蓋 2017 至 2026 年的研究發展時間線
• 比較 contrastive、masked、predictive 及 generative learning
• 關注長片段、串流觀察與影片代理的證據累積
• 收錄 669 篇參考文獻及多個尚待解決的研究問題

這份材料適合研究影片模型、World Models、多模態模型和 Computer-use agents 的讀者,也可作為設計影片理解、未來預測、模擬環境或機械人互動工作流時的索引。它屬於調查項目,並非可直接下載或安裝的單一模型;原始資料亦沒有提供具體使用流程。

項目主頁

Categories: Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Discord, 動畫

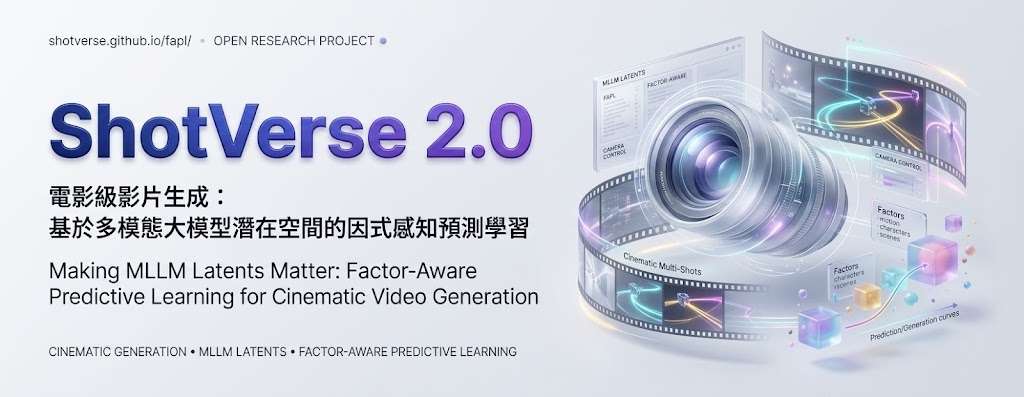
ShotVerse2.0:讓影片生成更有電影感

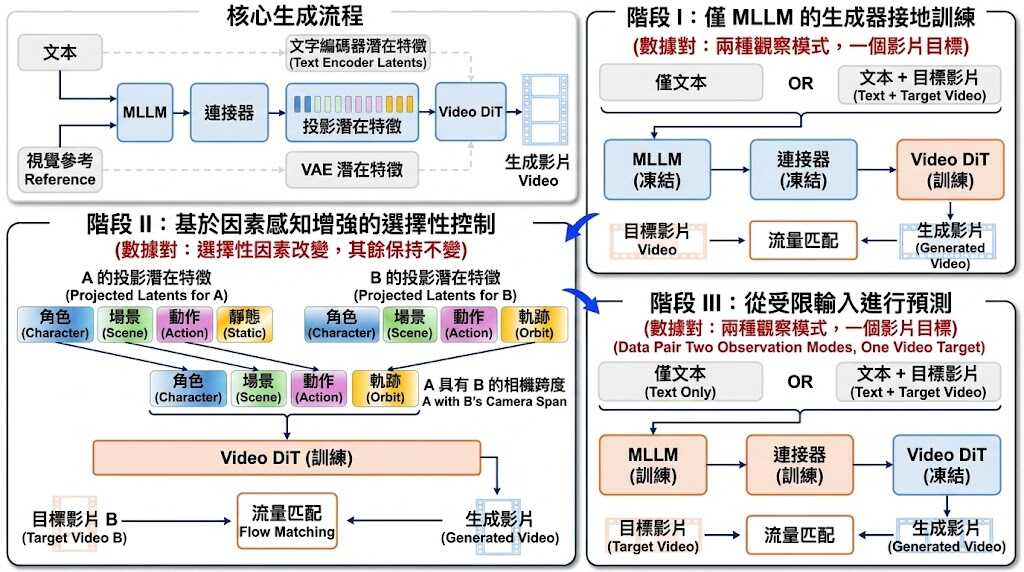
從文字生成影片時,角色衣着、場景和鏡頭動作往往難以同時維持一致。FAPL 訓練多模態語言模型理解影片生成所需的時間線索,並支援分項控制。

FAPL training framework

文字生成影片時,模型不只要描寫眼前一幕,還要推斷未提供的時間變化,並在角色、場景、動作和鏡頭之間維持一致。FAPL(Factor-Aware Predictive Learning,因素感知預測學習)是一套訓練方法,旨在讓多模態大型語言模型(Multimodal Large Language Model,MLLM)的表示真正參與影片生成,而非被解碼器繞過。

它以 UniVideo 的 13B Video DiT 為基礎,不改動模型架構,而是分三階段訓練:先令 DiT 以 MLLM 潛在表示作為內容條件,再透過成對的因素編輯資料,教模型只改指定內容、保留其他因素;最後固定 DiT,訓練 MLLM 與連接器,讓只有文字或文字加完整影片的輸入都能對應同一影片目標。這讓方法同時處理文字推斷影片細節,以及按因素選擇性控制的需求。

研究報告的評測中,FAPL 把 Motion Order 由 48% 提升至 61%,∩-Acc 由 42% 提升至 58%,FaceSim-Arc 則由 0.451 升至 0.523。展示案例亦呈現角色衣着和外觀較能維持一致;不過,這些數字來自指定評測,不能直接視為所有提示詞或影片情境下的保證。

目前較適合研究影片生成、希望改善多因素控制的團隊參考。GitHub 資料標示程式碼、模型權重及 CineFactor-10K 評測提示仍待發布,因此暫未能按儲存庫提供的資料安裝或重現訓練;現階段可先閱讀論文及項目網頁了解方法與示例。

  • 以 MLLM 潛在表示作為影片生成的內容條件。
  • 分開訓練內容 grounding、因素控制與有限輸入預測。
  • 可針對角色、場景、動作或鏡頭變更,同時保留其他因素。
  • 在所列評測中,動作順序、因素準確度與人臉相似度均有提升。
  • 程式碼、權重和評測提示尚未發布,現階段無法依實驗。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, 提示詞, 香港, 庫

Code2Video-Compass:程式碼生成影片點樣評?2,104 項任務比較 15 個多模態模型

Code2Video-Compass 把文字、圖片和影片輸入納入同一套程式碼影片生成基準,讓團隊比較模型能否產生可執行、貼合指示的影片。

Code2Video-Compass logo

由文字描述出發,或提供圖片、原有影片作參考,模型都要生成可執行程式碼,再經 Remotion 渲染成影片。Code2Video-Compass 是一套評估基準及評測程式,聚焦比較不同多模態模型在程式碼生成影片時的能力,而非提供一個直接生成影片的模型或服務。

它涵蓋文字轉影片(T2V)、圖片轉影片(I2V)和影片轉影片(V2V),支援 HTML/CSS、SVG、Canvas 與 Three.js 等程式碼方式。基準共有 2,104 項任務,分布於 10 個影片類別和 24 個子類別;其中 1,719 項任務配對 573 段來源影片,方便在不同輸入形式下比較模型如何保留參考內容及回應指示。

評測納入 15 個多模態大型語言模型,並以 12 項客觀指標和 5 項主觀指標檢視執行成功率、效率、影片品質、指示吻合度及參考內容保真度。相比只看成片觀感,這套基準亦檢查程式碼能否執行及生成流程的效率;不過,評測結果仍受任務設計、指標定義和主觀評分影響,不能單憑總排名推斷模型適合所有影片工作。

研究團隊可用它比較不同模型在特定輸入形式或影片任務上的表現,亦可檢查系統瓶頸是在程式碼執行、視覺品質,還是參考內容對齊。儲存庫提供評測程式,任務提示、標註、品質檢查清單及參考媒體資料則放在 Hugging Face;提供的資料未列出安裝步驟或完整執行流程,採用前需查看相關程式碼與資料集說明。

  • 支援 T2V、I2V、V2V,並涵蓋獨立任務與來源影片配對任務。
  • 模型以 HTML/CSS、SVG、Canvas 或 Three.js 產生程式碼,再由 Remotion 渲染影片。
  • 以 12 項客觀指標及 5 項主觀指標,評估執行、效率、品質和指示吻合度。
  • 適合模型研究及影片生成系統團隊作比較;它本身不是影片生成模型。

項目主頁 · GitHub · 數據集

Categories: 開源, AI productions, 模型, 多模態模型, Video, Image, 庫, Dataset 數據集

SpatialScout 揭示 3D 定位落差,讓視覺語言模型探索室內空間

視覺語言模型要邊探索室內場景、邊把物件放進共通的 3D 座標,仍難兼顧完整度與精準度。SpatialScout 以 80 個場景測試這種主動建圖能力。

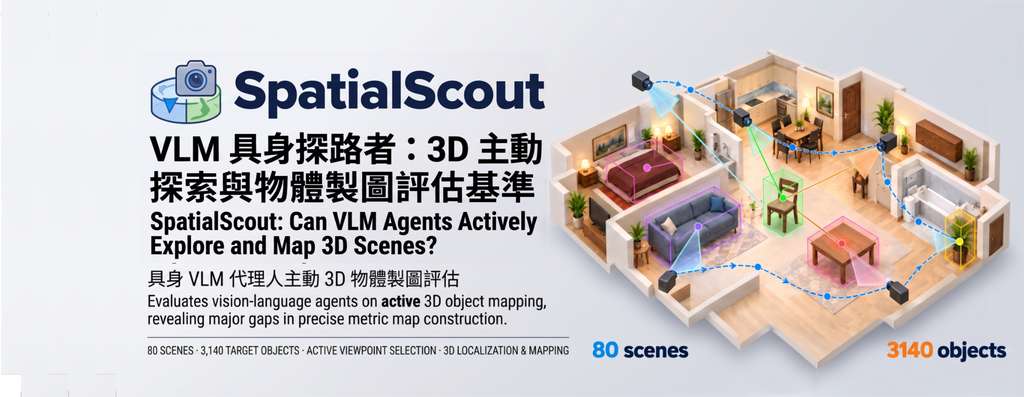
SpatialScout overview

要讓視覺語言模型看過不同角度後,找出物件在房間中的位置,單靠辨認影像並不足夠:模型還要選擇鏡頭視點、累積視覺證據,再把多個畫面中的物件對應起來。SpatialScout 是測試視覺語言模型(Vision-Language Model,VLM)代理主動探索與物件級 3D 建圖能力的基準項目,涵蓋 80 個室內場景及 3,140 個目標物件。

每項任務提供物件清單、RGB 觀察畫面,以及相機校準資料和位置資訊;代理要控制相機,在有限互動回合內探索場景,並估算物件在共通 3D 座標系中的中心位置。這讓測試不只檢查模型能否辨認物件,也衡量它會否選擇有用視點、跨畫面追蹤物件,以及逐步修正位置。

結果反映出由大概布局走向精確地圖仍有明顯距離:表現最佳的受測模型平均 IoU 為 41.71%,只有 3.25%的目標物件達到 IoU 0.9 以上。項目亦提供涵蓋所有物件及已提交物件的八項 IoU 指標,並以成功完成 finish_mapping 的軌跡計算任務平均分;這有助分辨模型是定位不準,還是漏掉了物件。

  • 基準涵蓋 80 個室內場景及 3,140 個目標物件。
  • 每項任務最多 100 回合,模型需主動選擇觀察視點。
  • 評分同時考慮定位準確度與物件完整度。
  • 最佳受測模型平均 IoU 為 41.71%,高精度定位仍有限。

研究團隊可用自己的模型 API 執行全部任務,預設採用 Responses API 模式,亦可切換至 Chat Completions、Anthropic 或 Gemini 端點。項目要求 Linux x86_64 和 Python 3.10,安裝程序會設定 CPU 渲染並透過 apt/sudo 安裝系統套件;場景資源則需另行下載及掛載。它適合研究主動感知、機械人空間理解或多模態代理的團隊作比較測試,但目前提供的是評估基準,不是可直接取代建圖系統的模型。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, 視覺模型, 多模態模型, Gemini, API, Image, 3D, Linux, Python, Anthropic, Dataset 數據集

PrismaCoder 的多模態生成

多模態程式碼智慧將程式的符號世界與其執行所產生的視覺世界連結起來。

PrismaCoder: Open Multimodal Code Intelligence

從文字或視覺輸入生成圖表、網頁、示意圖、文件和動畫,PrismaCoder 是一系列開放的多模態程式碼模型,處理的不只是程式能否執行,也包括輸出畫面是否符合要求。這對需要快速製作圖表、前端介面或科學文件的開發者和研究團隊,提供了涵蓋多種視覺程式任務的模型選擇。

它的訓練流程 PrismaForge 會為每項指令建立評分規準,分開檢查程式碼與渲染結果,再用相同規準篩選訓練資料及提供強化學習獎勵。這做法把「程式寫得對」和「畫面呈現得對」分開衡量,減少只靠整體印象評分所帶來的偏差。

模型以 Qwen3.5 為基礎,提供 9B 和 35B-A3B 兩種規模,並各有監督式微調(SFT)及強化學習(RL)版本。PrismaCoder-2M 資料集涵蓋圖表生成與重建、網頁介面、互動示範、向量圖像、科學文件及化學圖形等任務;評估工具包括 VisPlotBench 和 ChemDraw。

  • PrismaCoder-9B 的 SFT 與 RL 權重均可取得;35B-A3B 的 RL 權重仍在上載中。
  • 項目網站稱模型在圖表、前端頁面和半結構化文件任務中領先開放模型,並能匹敵或超越部分專有系統;具體分數需查看網站或論文。
  • 儲存庫已提供格式專屬執行與渲染檢查、多模態資料合成,以及 Python、SVG、HTML 的文字評分工具;PrismaForge 完整評分與資料篩選流程,以及 SFT、RL 訓練腳本仍未完成。

模型權重和資料集可經 Hugging Face 項目頁取得;不過,儲存庫目前未提供完整訓練流程,35B-A3B 的 RL 權重亦未上架。想先驗證生成品質的團隊,可參考 VisPlotBench、ChemDraw 評估程式和互動示例;若要自行重現訓練,則要留意腳本尚未開放。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 工具, Python, 庫, 動畫, Dataset 數據集, 強化學習

PawCT:分拆四聲部合唱

把合唱錄音轉成可分辨女高音、女低音、男高音與男低音的 MIDI 音符,有助排練和樂譜重建。PawCT 直接輸出四部聲線,並以 YouChorale 測試其分部能力。

Ground truth, PawCT, PagCT, and PagCT plus Post-VA piano rolls

要從整隊合唱錄音還原各聲部,難處不只是聽出音符,還要判斷每個音符屬於哪一部。PawCT 是一套合唱自動音樂轉錄(Automatic Music Transcription,AMT)研究模型,會把混合錄音轉成女高音、女低音、男高音與男低音(SATB)的獨立音符軌,適合用於排練準備、音樂教育和樂譜重建。

PawCT 亦提供 PagCT,先轉錄不分聲部的合併音符軌;另一個基線 Post-VA 則在第二階段,按符號音樂資料為音符分配聲部。PawCT 把聲部辨識納入端到端轉錄,並以共享編碼器配合 SATB 專屬的起音、延音結束及音框輸出頭;音域先驗(RP)和有序連續性先驗(OC)則在訓練損失中限制不合理音域與旋律走向,推理時毋須額外模組。

YouChorale 的 PagCT 的單軌音符 F1 為 0.382,高於 Yu et al. (2024) 的 0.237;SATB 平均音符 F1 則由 PagCT 加 Post-VA 的 0.175,升至 PawCT 加 RP 與 OC 的 0.225。

  • 想取得單一音符軌,可測試 PagCT;需要分開四部聲線,則應看 PawCT 的輸出。
  • 模型、訓練、評估、視覺化及釋出檢查程式碼均已納入儲存庫,另有線上示範與程式碼導覽可供參考。
  • YouChorale 的音訊、標註、MIDI 檔案及生成預測並未一併公開,因此仍有待完整重現。

對音樂研究者、合唱團排練者及開發音樂教育工具的團隊而言,PawCT 提供了直接檢視分部轉錄的研究起點;若只需合併音符,PagCT 的定位較簡單。現有公開內容較適合檢查方法與程式流程,重現比較實驗前則要先核對資料、評估協定和歷史設定是否齊備。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Audio, 工具, 庫, 語音, 音樂, Dataset 數據集

FocusGUI 自動揀對的訊息做 GUI 代理

南洋理工大學與阿里共同發表的 FocusGUI,主打用極少可訓練參數處理多模態 GUI 代理嘅分心問題。你能把它理解成幫現有多模態模型動態挑選畫面、音訊、影片當下最相關訊息嘅外掛模組。

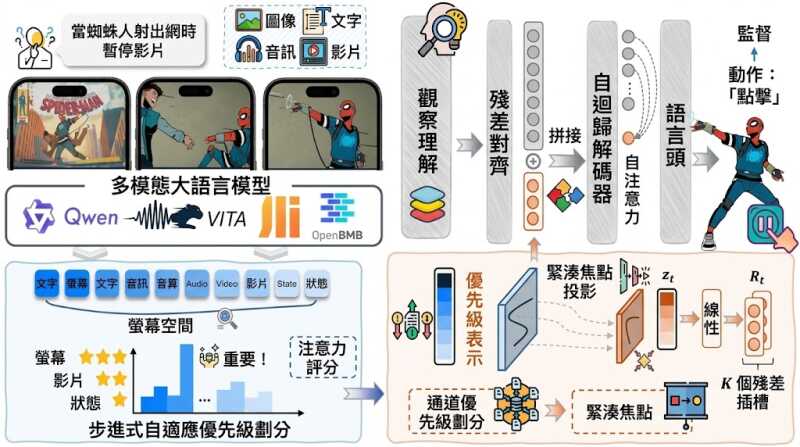
FocusGUI architecture: channel prioritization, compact focus, and residual alignment with a frozen decoder

南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。

它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。

對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。

項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio

ScaleNav 把影片變成導航能力

ScaleNav 先從互聯網第一視角影片學習路徑規律,再轉成機器人動作,面對語言指定目標的局部導航。

ScaleNav navigation: real robot on the left, simulation on the right

網上第一視角影片 seldom 附帶機器人動作,但當中蘊藏大量「沿走廊前進、避開障礙、轉入目標房間」的視覺規律。ScaleNav 是一個研究型導航模型,試圖把這些 action-free 預訓練所得到的 navigation priors,轉移到有動作標籤的模擬軌跡,再用於 language-conditioned local navigation:按文字尋找初始畫面可見的目標並停下來。

模型屬共享式 Diffusion Transformer,會根據指令、目前 RGB 影像及記憶,共同預測未來 video latents 和 action chunks。流程分三階段:先從互聯網第一視角影片學習目標導向視覺動態,再進行 action alignment,最後 joint fine-tuning,同時保留影片回放並微調共享骨干與輸出頭。

ScaleNav 與同類做法的主要取捨,是毋須先收集大量完整機器人示範,便能借助互聯網影片建立導航先驗;代價是仍要依賴模擬軌跡、動作對齊及多階段訓練。官方模型約 10.02 GB,推論及評估建議使用支援 BF16 的 NVIDIA GPU、24 GB GPU 記憶體與 64 GB 系統記憶體,並按文件配置 Linux、Habitat-GS 和場景轉換工具。

結果涵蓋 HabitatGS-LN、Short-Horizon OVON 與真實四足機械人;公開資料列出 ScaleNav 在兩項模擬評估的成功率分別為 94.9% 及 86.5%,真實機械人則在 60 次試驗中錄得 83.3% 成功率。團隊亦整理 gallery 導航影片、軌跡、目標與結果,以及 summary.json 內的 SR、SPL 和逐任務成績,方便比較與重現。

  • 影片預訓練不必附帶逐格動作標籤
  • 同一模型處理影片動態與動作生成
  • 支援模擬環境及真實四足機械人
  • 提供模型、資料、評估結果與操作文件

這套方法較適合研究 embodied navigation、 robotics 與 VLA(Vision-Language-Action)的團隊;評估數字雖亮眼,仍須留意各方法採用不同設定,跨模型比較應同時核對 episode 數、場景及 fine-tuning 條件。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, VLA, Robotic, 工具, Linux

Page 2 of 29
1 2 3 4 … 29