Work Agents 將數碼工作拆成可驗證成果

跨應用程式完成工作,不能只看模型答得對不對;Work Agents 把代理流程、能力與可驗證成果放進同一研究脈絡。

Work Agents: Systems, Capabilities, and Optimization

當 AI 要跨應用程式完成多步工作,交付可核實、能供後續使用的成果,比單次答對更重要。Work Agents 是配合調查研究整理的開源閱讀清單,收錄數碼工作代理的系統、訓練、環境、記憶、基準與官方資源,並非可直接安裝的代理軟件。

研究以工作持續性(work persistence)和工作開放性(work openness)描述工作條件,並分成對話(Conversation)、單一步驟(Atomic Action)、多步(Multi-step)、工作流程(Workflow)及工作區(Workspace)五類。它也梳理 foundation models(基礎模型)與 runtime harnesses(執行時框架)的單獨或協同優化,評估則聚焦成果能否符合要求並供下游使用。

你可由 GitHub 清單挑選論文、基準和工具;暫未有可直接執行的代理或統一安裝、測試流程,不能當成部署指南。

  • 整理代理系統、訓練方法、環境與記憶研究
  • 涵蓋五類數碼工作及相關評測資源
  • 比較模型、執行框架及兩者的協同優化
  • 以可驗證、能供下游使用的成果作評估焦點

產品團隊和自動化流程負責人可用它整理能力缺口與評測方法。清單沒有同一環境下的性能數字,具體效果仍要回到各研究與工具核實。
項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, 框架, 香港, 軟件, 工具, 庫

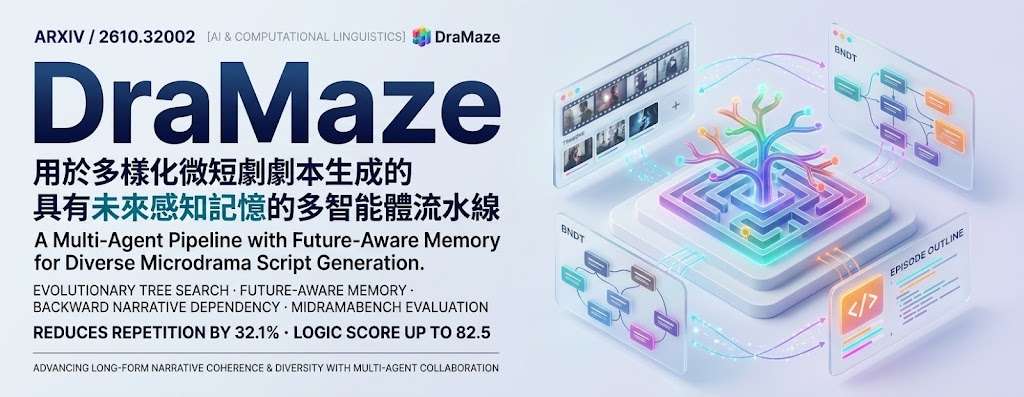
DraMaze 讓長篇微短劇少重複套路,兼顧劇情連貫

長篇微短劇寫到後段,AI 容易反覆使用相似的劇情推進方式。DraMaze 以多個代理人探索不同因果路徑,並按未來劇情需要找回關鍵往事。

Hero image preview

微短劇需要密集轉折,但劇集一長,AI 生成的情節容易逐漸集中在少數套路,例如角色關係反覆靠誤會與澄清推進。DraMaze 是面向長篇劇本生成的多代理人流程,嘗試同時維持故事連貫與情節變化。

常見做法會用歷史摘要、記憶檢索或知識圖譜提供前文脈絡;但檢索到相似經歷,也可能令模型重複舊有因果模式。DraMaze 改用「未來敘事依賴樹」整理往事,按後續劇情目標保留和檢索相關記憶,並透過套路記憶引導的演化樹搜尋與變異,探索不同的因果發展。

研究團隊亦推出雙語評測基準 MiDramaBench,評估不同長度劇本的邏輯與創意,並加入衡量因果模式重複和多樣性的指標。測試涵蓋三個基礎大型語言模型;生成最多 60 集、約 6 萬字劇本時,因果模式重複減少 32.1%,邏輯評分達 82.5 分,較最佳基線高 8.5 分。

  • 面向數十集的長篇微短劇生成,兼顧前後連貫與劇情變化。
  • 依照未來情節需要整理記憶,不只按語意相似度檢索舊內容。
  • 以演化樹搜尋和變異探索不同的劇情因果路徑。
  • MiDramaBench 提供雙語評測,涵蓋邏輯、創意及因果模式多樣性。

對需要批量構思長篇微短劇的編劇與內容團隊,DraMaze 提供一套可評估的生成流程;不過,摘要所列結果集中於特定劇本長度與評測指標,不能單憑這些數字判斷所有題材和創作場景的表現。

GitHub · Paper

Categories: 騰訊, Agentic, 模型, 框架, KnowledgeGraph, 中國, Dataset 數據集

DirCast-code:AI 同時導播與解說,直播一手包辦

DirCast 每秒查看 Dota 2 十名英雄的鏡頭,自行選擇播出畫面並配上解說。它把導播與主播工作交給同一個模型,但目前評估仍集中於有限的職業賽事。

DirCast

直播觀眾看到的畫面和聽到的解說,通常由導播與主播共同決定;DirCast 嘗試讓 AI 每秒查看十名英雄的原始鏡頭,選出播出畫面,再按該畫面決定何時發言及說甚麼。這個研究型工具以 Dota 2 賽事為場景,處理的是如何在比賽仍在進行時,同步完成選鏡和解說,而非只替已剪好的直播影片配音。

DirCast 使用單一串流影片語言模型 Qwen3-VL-8B,並以 LoRA 微調。模型先低解像度掃描各英雄鏡頭及遊戲狀態,再由導播模組決定維持現有畫面或切換;選中的鏡頭會再以高解像度讀取,供發言判斷和文字生成。這種安排把全場掃描與播出畫面的細節理解分開,也讓模型的解說跟隨自己選出的畫面。

模型不會永久保留所有低解像度鏡頭:這些畫面只在設定的時間窗內留在上下文,播出畫面、事件和已生成的說話則會保留,令處理長賽事時的上下文成本受控。訓練時加入受擾動的播出流程,讓模型練習從自己選錯鏡頭後恢復;事件標記則協助它把擊殺等值得呈現的時刻納入選鏡考量。控制切鏡與發言的門檻亦會按頻率調節,避免節奏過密。

研究資料集包含 27 場職業 Dota 2 比賽,記錄每名英雄的鏡頭、人類導播選擇及主播解說。示範涵蓋兩場留出比賽,展示模型切到鏡頭外發生的交戰並作出評論;但這些例子不足以證明它已能應付不同遊戲、直播延遲或長期穩定運作,現階段較適合研究團隊測試自動化直播製作,而非直接取代真人轉播團隊。

  • 每秒掃描十路英雄鏡頭,並自行選擇播出畫面。
  • 同一模型負責導播決策、發言時機及解說文字。
  • 低解像度畫面會過期,播出內容與事件記錄則留在上下文。
  • 訓練資料來自 27 場職業 Dota 2 比賽,公開示範展示兩場留出賽事。

GitHub 儲存庫提供模型、資料處理與賽事狀態相關程式碼;研究人員可據此檢視流程或測試模型。儲存庫資訊未列出完整安裝步驟、硬件需求或可直接重現的評估指標,因此部署成本與相對真人導播、主播的穩定差距,仍需更多測試才能判斷。

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, 模型, 模型訓練, Qwen, OpenAI, Video, 工具, 庫, Dataset 數據集, LoRA

RealMe:從稀疏多鏡頭畫面重建 2K 沉浸式 4D 影片

拍攝角度和畫面清晰度有限,也能為新視角補出細節並維持跨鏡頭、跨時間的一致性。RealMe 以影片擴散模型輔助重建體積影片,但程式碼仍未公開。

RealMe

用稀疏、低解像度的多視角影片製作沉浸式內容,難處不只在補清楚每一格,也要避免不同鏡頭和時間點的畫面互相矛盾。RealMe 是一項體積影片重建研究項目,目標是把 720p 多鏡頭拍攝素材轉成 2K、具 4D 一致性的影片,適合需要從有限拍攝資料重建人物與場景的研究及製作團隊。

流程先由輸入畫面建立粗略的 4D 表示,再從新視角渲染結果和原始畫面裁切出輔助影片,交由高解像度影片擴散模型增強;生成結果會與原始拍攝一同用來細化最終表示。模型以 ControlNet 注入輔助影片條件,並在 DiT 中分開處理時間與視角方向的注意力,讓去噪過程能交換跨影格、跨視角資訊;頻率引導則用來恢復細節。

相比只提升單張影像清晰度的做法,RealMe 同時處理新視角品質與 4D 一致性。研究團隊表示,它在 RealVV 和 DNA-Rendering 兩個資料集的新視角合成品質及 4D 一致性上勝過當時的先進方法;與 STAR、FlashVSR 比較時,示範結果呈現更細緻的面部、頭髮和衣物細節。這些結果來自研究展示,未提供可供讀者自行重現的效能數字。

RealVV 是團隊自行拍攝的多視角資料集,涵蓋不同人物、動作、場景、相機基線和焦距設定,目標是測試較具挑戰性的拍攝條件。現階段 GitHub 程式碼仍在內部審查,資料亦標示為即將提供,因此目前可透過論文、項目網站及示範影片了解方法,尚未能按公開指引安裝或重現流程。

  • 輸入為稀疏、低解像度的多視角影片,輸出目標為 2K 4D 體積影片。
  • 影片擴散模型負責生成增強視角,再與原始拍攝共同細化重建結果。
  • DiT 的時間與視角注意力設計,用來維持跨影格、跨視角一致性。
  • RealVV 涵蓋多種人物、場景及相機設定;程式碼和資料目前尚未公開。

對多鏡頭人物捕捉、自由視角影片和 4D 重建研究而言,RealMe 展示了以生成模型補足稀疏拍攝細節的方向;但在程式碼與資料釋出前,製作團隊仍難以判斷其運算成本、所需拍攝條件及融入現有流程的難度。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, Video, Image, 中國, Dataset 數據集

Socratic-Skill-Learning:Agent 技能能否真正跨任務重用?南京大學提出 SSL

SSL 讓 Agent 在導師指導下自行練習及編寫技能,並以新任務測試 transferable Skills 是否真正遷移。

NJU-LINK

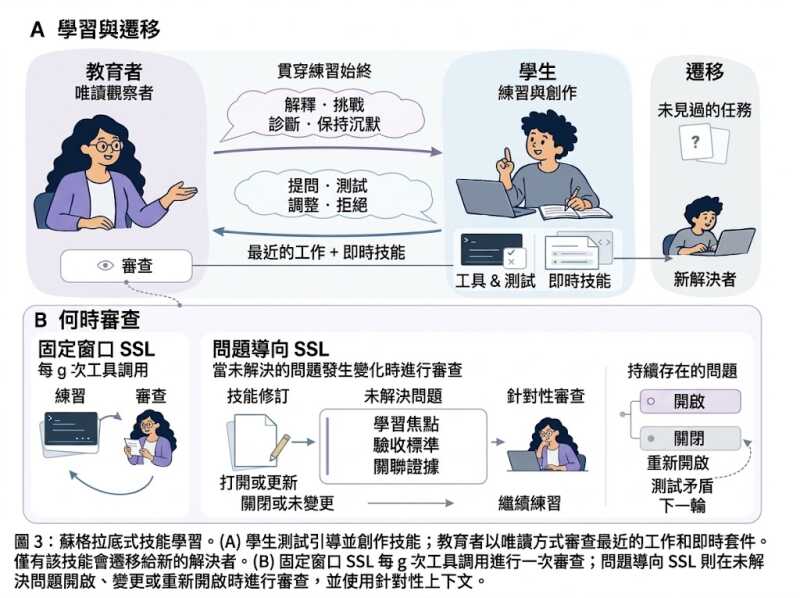
Agent 從一次任務學到的做法,未必能直接套用到新情境;SSL(Socratic Skill Learning)把這種「學會與重用」拆開,讓 Student 練習、提問及編寫 Skill,再由全新的 solver 接手未見任務。南京大學 NJU-LINK 將它定位為可重用 Agent Skills 的學習框架,關鍵不是複製完整答案,而是保留程序及其適用條件。

流程由 Educator 介入指導,但 Student 仍是環境操作者及 Skill 作者,可以質疑、測試和修改建議。Fixed-Window SSL 會按固定間隔檢視進度;Issue-Guided SSL 則追蹤仍未解決的問題,隨 Skill 版本變化集中檢視,避免每輪都重新教訓。

評測工具 SkillTransferBench 涵蓋 35 個任務系列、408 個可執行個案及 6 個領域;主評估使用 22 個系列、155 個 held-out cases,並以新 solver session 測試遷移。Fixed-Window SSL 的 utility 為 0.801,高於無 Skill 的 0.723、Trace2Skill 的 0.761,以及 SKILL-KD 的 0.751;Issue-Guided SSL 達 0.805,較 Fixed-Window SSL 節省 61.7% Educator tokens,但整體流程仍需 Node.js 22.19+、Docker 及 OpenAI-compatible API 支援。

  • 讓 Agent 自己提問、測試和修訂 Skill
  • 以未見任務及新 solver 檢查技能是否可遷移
  • 比較固定間隔與問題導向兩種複核方式
  • 提供跨 Qwen、DeepSeek、Kimi 等模型的評測

這套方法較適合研究 Agent 教學、技能記憶及長期工作流程的團隊,而不只適合聊天機器人。它沒有直接把大型模型換掉,而是處理更實際的問題:如何把一次成功任務轉成可攜、可審核的 Skill,同時控制導師介入所帶來的額外成本。

GitHub · 數據集

Categories: 開源, 南京大學, Agentic, 模型, Qwen, OpenAI, DeepSeek, API, 框架, 教學, 工具, Dataset 數據集, Kimi, Skill 技能

SWIFT 把擴散模型的訓練誤差轉成性能優勢

有限訓練令擴散模型偏離理想預測,SWIFT 從較弱模型找出偏差方向,再把訓練目標推向更準確的位置。ImageNet-256 上,它在不改採樣器的情況下取得具競爭力的 FID。

Og image

擴散模型訓練時間有限,預測結果往往未能到達理想的後驗平均值;SWIFT(Self-guided Weak-to-strong dIFfusion models via Target extrapolation)利用這種可預測的偏差,改善模型生成影像的能力。它適合關注影像生成品質、又希望保留原有推理流程的研究者與模型開發者。

SWIFT 先使用一個凍結的弱模型,估計目前模型會在哪個方向偏離理想預測,再把訓練目標沿相反方向外推。訓練時改變的只有預測目標,損失函數、權重、網絡架構及採樣器都維持不變;使用時無須更換原有採樣器。

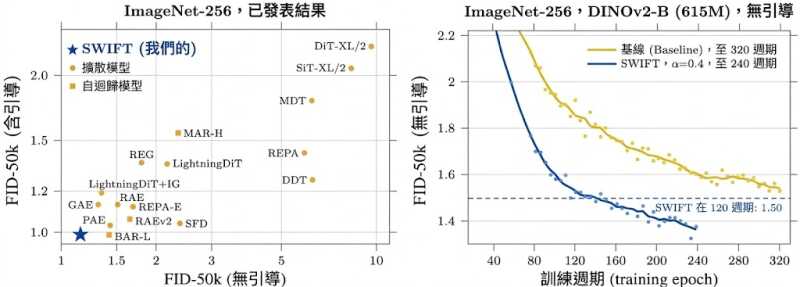
在 ImageNet-256 評測中,SWIFT 不使用 guidance 時的 FID 為 1.15,使用 guidance 時為 0.99。研究亦在配對的 DINOv2-B 設定下比較訓練進度,SWIFT 在訓練過程中持續領先基準模型。

  • 以凍結的弱去噪模型估計訓練偏差方向。
  • 將乾淨樣本與弱模型預測之間的差距用來外推回歸目標。
  • 保留原有模型架構、損失設定及採樣器。
  • ImageNet-256 的 FID 為 1.15(無 guidance)及 0.99(有 guidance)。

這種方法針對的是有限訓練預算下的模型誤差,並非更改生成時的採樣流程。現有內容未提供完整安裝或使用步驟,採用 SWIFT 前仍需查閱論文及相關資源確認實作細節。

項目主頁

Categories: 南京大學, 阿里巴巴, 模型, 模型訓練, Image

MT-Forcing:多輪改圖守住細節唔再走樣

連續改同一張圖時,主體、紋理與構圖往往會慢慢偏離;MT Forcing 以多輪訓練與教師引導改善這類累積錯誤。

MT Forcing teaser

連續要求「改杯色、加條紋、再調光線」時,圖片往往未到最後一輪已經失真。MT Forcing 是針對多輪圖像編輯的訓練框架,配合自迴歸擴散模型,減少每輪修改帶來的漂移。

方法把單輪 DMD(Distribution Matching Distillation)與 Teacher-Forcing Guidance 結合:學生模型逐步編輯自己生成的歷史,凍結的單輪教師則從原圖一次套用累積指示,提供分布層面的引導。參考真實編輯軌跡後,模型既要改善畫質,也要維持跨輪次內容關係。

  • 以自身多輪輸出作為訓練歷史
  • 引入單輪 DMD 改善視覺品質
  • 用 Teacher-Forcing Guidance 減少誤差累積
  • 展示最長十五輪及八輪編輯比較

官方程式碼要求 Python 3.11.13、NVIDIA CUDA GPU,以及指定 checkpoint、架構資源和擴充 U1.5 tokenizer;配置完成後,可在同一工作階段依序執行多個編輯提示。公開資料未交代完整硬件門檻、推理速度或標準化定量結果,因此較適合作為需要 NVIDIA GPU 的研究重現工具,而非直接比較成本已知的消費級服務。

它以 SenseNova-U1.5 作為相關基礎模型,並在多輪比較中加入 MT Forcing。對需要逐步修訂產品 concept、人物姿勢或場景細節的設計團隊,單輪教師可作品質參照。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 清華大學, 模型, 模型訓練, NVIDIA, Image, 影像模型, 框架, 工具, Python, Tokenize

KTP(Knowledge-Transfer-Probing) 統一多模態模型做知識轉移考核

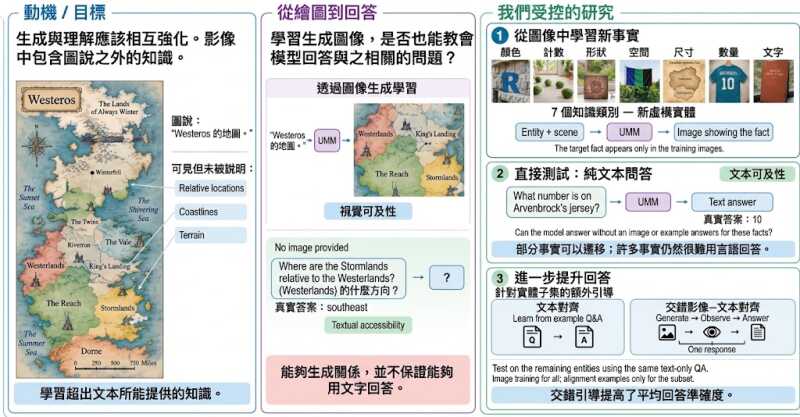
清華與 Z.AI 團隊提出 KTP 評測協議,專門測試統一多模態模型從圖像生成學到的新知識能否透過純文字問答取出,逐步補上視覺與語言之間的知識流動缺口。

knowledge transfer probing

統一多模態模型(Unified Multimodal Models, UMMs)一邊做圖像生成、一邊做語言理解,但訓練時從圖像吸收的知識,一直難以量化究竟有多少真的能在純文字 QA 場景派上用場。Knowledge Transfer Probing(KTP)這個項目正正填補這個缺口:它設計了一套受控的評測協議,先以圖像生成訓練把新知識餵進模型,再以純文字問答檢驗模型能否取出。

團隊跨越七個知識類別(色彩、數量、形狀、相對空間、相對大小等),在三個 UMM 上觀察到一個關鍵現象:直接從視覺監督遷移到語言的知識,效果並不均勻,部分類別知識存取明顯偏弱。有趣的是,在部分實體上做 Textual Alignment 或 Interleaved Image-Text Alignment 對齊訓練後,模型在未對齊的其餘實體上同樣能改善知識存取,其中交錯式對齊的平均準確率比純文字對齊更高。

項目屬於研究型資料集與評測框架,隨倉庫釋出 KTP-Data(分為 train/ 與 eval/),訓練檔涵蓋文字生成圖像、文字對齊及交錯圖文對齊三類樣本,評估檔則提供文字可達性(QA 題目與參考答案)與視覺可達性(生成提示與屬性)。評分腳本只用 Python 標準庫,跑分結果會輸出 results.jsonl 與 summary.json,方便研究者直接替換自家模型回應做比較。

對正在訓練或微調 UMM 嘅團隊而言,KTP 提供一個可重現的基準去量度「圖像生成帶來多少純文字世界可用的知識」,同時指出交錯對齊是一條有實證支持的改進路徑。多模態模型研究者、訓練數據設計者,以及關心視覺-語言聯合表徵架構的人都會從中受益。

這個項目的限制同樣需要留意:KTP 目前只覆蓋七類視覺屬性,且只測試三個 UMM,並未涵蓋複雜語境或多輪推理,結論的普遍性仍有待擴充樣本驗證。

項目主頁 · GitHub

Categories: 開源, 清華大學, 模型, 多模態模型, 模型訓練, Image, 框架, Python, 庫, Dataset 數據集

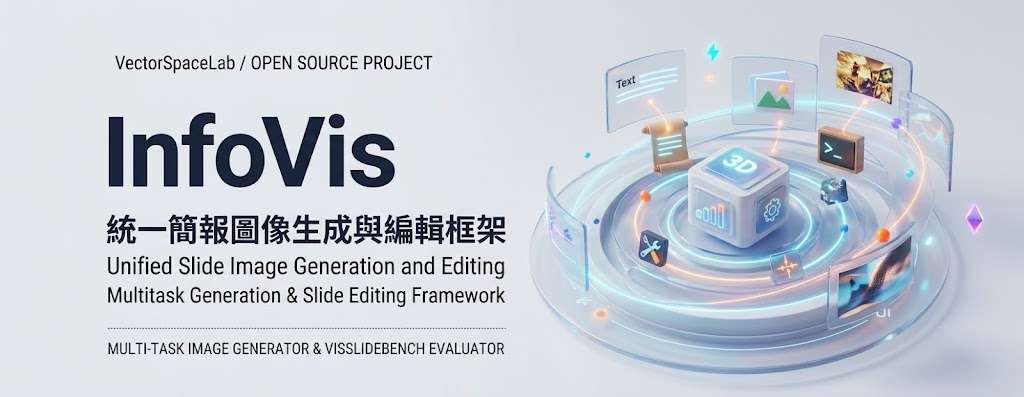
InfoVis 簡報生成與編輯能力整合到 9B 模型

InfoVis 讓同一個模型處理簡報生成、素材參考、模板控制與局部編輯,開源評測已接近 Nano-Banana-2。

overview

製作簡報圖像時,你可以用文字生成整頁投影片,也可以提供風格參考、內容素材或原有投影片作修改。InfoVis 屬於開源影像模型項目,集中處理文字轉投影片、模板條件生成、多圖像內容生成,以及按指令編輯投影片四類工作,減少不同模型之間切換所帶來的流程斷裂。

模型以 FLUX.2-klein-base-9B 為基礎,經過 slide-native continual pretraining、四任務混合 continual pretraining,再進行 task-specific SFT,最後把不同分支合併成單一模型。這種做法換來較完整的任務覆蓋,但同一模型要同時兼顧文字準確度、版面美感、內容對齊和精準編輯,效果仍會受提示內容及輸入素材質素影響。

VisSlideBench 收錄 1,527 個人工篩選案例,分別檢查內容忠實度、指令遵循、美感、語義一致性和簡報質素等指標。InfoVis 整體得分 7.94,略低於專有的 Nano-Banana-2(7.99),但在所有 11 項指標均領先受評開源模型;相較原始 FLUX.2-klein-base-9B,專門訓練帶來 1.6 分整體提升,美感仍是它與專有模型之間較明顯的差距。

項目提供 Hugging Face Space 的線上示範,再按需要下載模型權重、程式碼、InfoVis-Data 和 VisSlideBench 作本地研究或評估。這個項目較適合需要大量製作簡報草稿、產品提案、教學投影片的設計及內容團隊;本地執行 9B 模型則要自行準備相容的圖像生成環境,儲存庫資料未列出統一的硬件要求。

  • 四合一工作流:文字生成、模板控制、多圖像接地生成及指令式編輯由同一模型處理。
  • 專用訓練資料:提供超過 13M continual-pretraining records 及 1.9M SFT records。
  • 可驗證評測:VisSlideBench 同時公開資料集及評估程式碼。
  • 主要取捨:開源模型中表現突出,但整體仍稍低於 Nano-Banana-2,美感差距較大。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 教學, 庫, 中國, 蘋果, Dataset 數據集

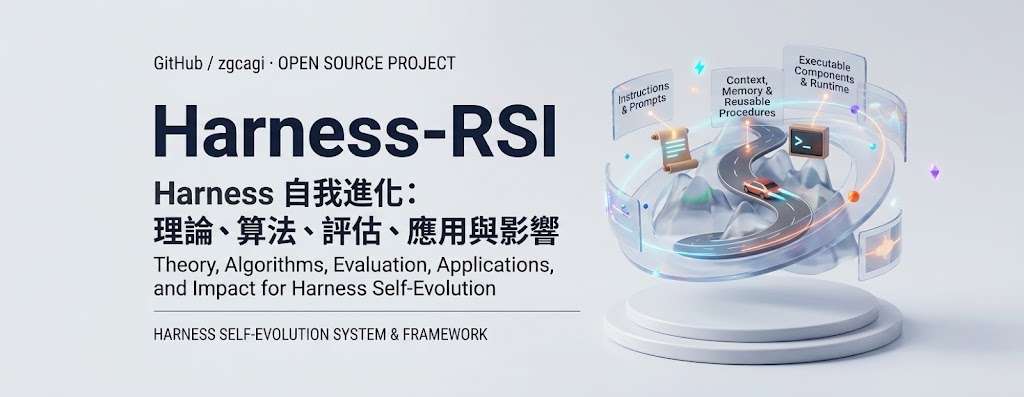
Harness-RSI:同一模型如何靠 Harness 持續自我進化

模型權重不變,Agent 仍可把執行經驗寫入指令、記憶、工作流程與工具。這份研究整理了自我進化的機制、證據與限制。

The path of harness self-evolution, from instructions to executable components and runtime

模型權重保持不變,Agent 仍可把一次次執行經驗沉澱成指令、記憶、工作流程、工具及 runtime logic。Harness-RSI 是一份圍繞 harness self-evolution 的研究調查與配套閱讀資料,處理的是固定 base model 如何持續改善代理系統,而不是提供可直接執行的 Agent 軟件。

內容將更新目標分成由固定元件解讀的 instructions、memory、workflow specifications,以及可執行的 tools 和 runtime logic,再比較不同方法如何提出、篩選及接納修改。分析亦連接 evolutionary algorithms 與 continual PAC-learning,嘗試說明甚麼條件下,接納更新的比較才足以支持「有所改善」的判斷。

評估部分沒有只看分數升幅,而是拆開四個問題:selection 是否受到搜尋過程影響、activation 是否真的在評分執行中生效、attribution 是否由該更新造成,以及 improvement 能否推廣到產生更新以外的任務。調查指出,相關報告雖常使用 held-out tasks,activation 和 attribution 的證據仍然有限。

GitHub 儲存庫沒有展示完整安裝流程或可供本地測試的程式入口,較適合研究人員、Agent 平台設計者及需要整理自我改善方法的團隊。

  • 固定模型權重,更新外部 harness state
  • 涵蓋指令、記憶、工作流程、工具與執行邏輯
  • 以 evolutionary algorithms 和 continual PAC-learning 分析更新
  • 用 selection、activation、attribution、improvement 拆解評估可信度

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 框架, 軟件, 工具, 庫, 中國

Page 2 of 20
1 2 3 4 … 20