ABot-N1 點樣令導航模型更穩更易懂

ABot-N1瞄準機械人導航最難搞的斷層:一邊要理解場景與指令,一邊又要即時控制移動。它把思考與動作拆開處理,令跨場景導航更穩定,也較容易追蹤模型點樣作決定。

AMAP CV Lab

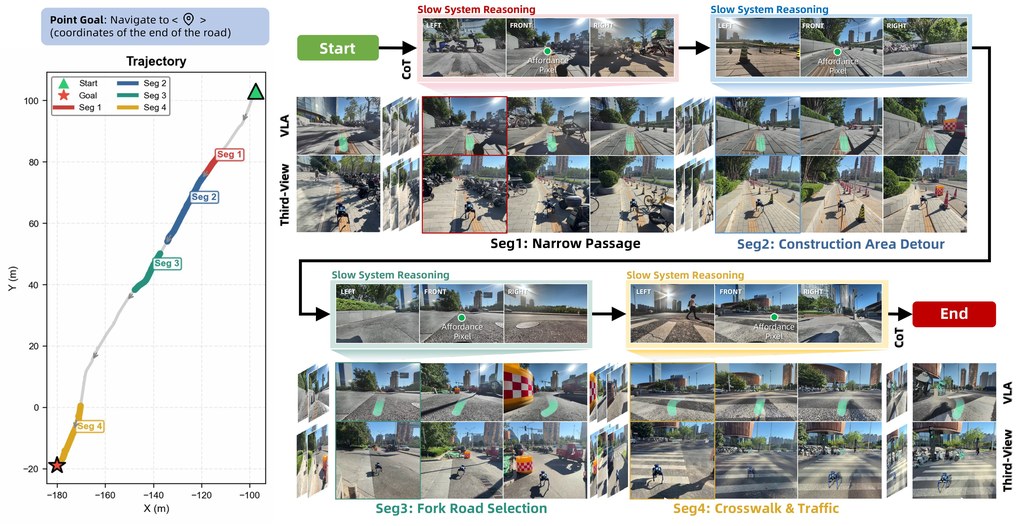
做室內外導航時,最麻煩往往不是單純避障,而是模型要同時理解語言、辨認目標,再即時走出合理路線。ABot-N1屬於 VLA(Vision-Language-Action)navigation model,焦點放在處理黑盒式策略常見的座標漂移、長尾語意理解不足,以及決策過程難以解釋的問題。

它的做法不是把所有事塞進同一個控制器,而是用 slow-fast 架構把認知與控制分開。較慢的 vision-language reasoner 會讀取歷史畫面與任務提示,產生明確的 Chain-of-Thought reasoning,並輸出 pixel goals 作為通用的影像空間錨點;較快的 action expert 再結合文字線索與 pixel guidance,持續生成 waypoint,將高層意圖接到低層移動控制。

這種設計的好處,在於同一套框架可以覆蓋多種導航任務,而不只是單一路徑跟隨。現有資料提到它支援 point-goal、POI-goal、object-goal、instruction-following 同 person-following,當中 POI-goal 需要由戶外走到實際入口,特別能反映語意理解與跨場景移動是否連得上。

  • 把 cognition 與 control 非同步拆分,減少黑盒式端到端策略的不透明問題
  • 用 dual visual-language signals 連接推理與動作,核心輸出包括 Target Pixel 與 Affordance Pixel
  • 涵蓋 point-goal、POI-goal、object-goal、instruction-following、person-following 等任務
  • 成績上錄得新 state-of-the-art,POI arrival 提升 35.0% 至 77.3%
  • 複雜室內與室外場景分別達到 95.4% 與 92.9% SR,亦同步開源新 benchmark

整體來看,ABot-N1最值得留意的不是單一指標,而是它試圖把「看得懂、講得清、走得穩」放進同一個導航模型。對做 embodied AI、robotics 或通用導航工作流的人來說,這個項目提供了一條比純黑盒控制更可分析、也更容易擴展到不同任務的路線。
項目主頁

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, 模型訓練, Image, VLA, Robotic, 3D, Dataset 數據集

Needle 想把微型 AI 帶落手機同手錶

Needle唔係追求萬能對話,而係集中做好 function call。26M 參數做到可本地微調,方向相當鮮明。

Logo

想喺手機、手錶或者眼鏡一類裝置放入可用嘅個人 AI,卡位往往唔係模型夠唔夠大,而係夠唔夠細、夠唔夠快,仲要肯做工具呼叫。Needle 就係朝呢個位置落手:一個以 Simple Attention Network 為核心嘅微型模型項目,重點處理 single-shot function call,目標唔係長篇對話,而係幫個人 AI 更穩定咁叫工具做事。

呢個項目最值得留意嘅地方,在於佢將 Gemini 3.1 蒸餾到 26M 參數,並且保留到可以喺 Mac/PC 本地 finetune 嘅路線。對開發者同產品團隊嚟講,意思好直接:你未必要綁死雲端大模型,亦可以先用開放權重同資料生成流程,試自己嘅工具介面、指令格式同 function schema,再按需要微調。

Cactus Needle - The 26M Function Calling Model

同類小模型通常會喺「尺寸、速度、泛化能力」之間拉扯,Needle 明顯揀咗功能導向呢一邊。README 已經講得很坦白:佢喺 single-shot function call 勝過 FunctionGemma-270m、Qwen-0.6B、Graninte-350m、LFM2.5-350m,但呢類較大模型喺對話範圍同容量上仍然更強,所以 Needle 比較似一把專用工具,而唔係通才助手。

  • 類型上屬於開源模型項目,集中解決小裝置上嘅 function call 效率與部署成本。
  • 權重同 dataset generation 都已開放,適合拿來測試自家工具鏈同微調流程。
  • 生產環境配合 Cactus,可達 6000 toks/sec prefill 同 1200 decode speed,取向非常著重吞吐。
  • 預訓練用 16 TPU v6e 跑 200B tokens,之後再用 2B tokens 嘅 single-shot function call dataset 做 post-training。

模型結構亦反映咗呢種取向:Simple Attention Network 採用 encoder-decoder 佈局,配合 GQA+RoPE、Cross Attn、ZCRMSNorm 同 shared embedding,目的係用更細規模支撐工具呼叫輸出。要留意嘅限制同樣清楚,小模型本身比較 finicky,對資料格式、工具定義同微調質素會更敏感;需要穩定多輪對話或者更廣知識覆蓋嘅場景,仍然未必係 Needle 最合適。

GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Qwen, Gemini, Mac, Dataset 數據集

ABot-World 把互動世界模型帶上桌面 GPU

ABot-World想解決的,不是再做一段更長影片,而是讓生成世界可以持續回應操作。你可以把它理解成一個開始接近可玩狀態的互動式世界模型示範。

ABot World 0

影片生成做到流暢並不罕見,但能一邊接收操作、一邊把世界延伸落去,門檻就高得多。ABot-World定位屬於模型加示範工具,核心處理的是 action-conditioned world rollout:用戶輸入動作之後,系統持續生成可探索的世界,而唔係播完就停的被動片段。

呢個項目的取向相當鮮明:它唔係先追求超高畫質,而是把「可互動、可持續、可在單張桌面顯示卡跑起來」放到前面。官方公開的數字是單張 NVIDIA RTX 5090 可在 720P、16 FPS、1.2 秒延遲、19GB GPU 記憶體下運行,配合 LongForcing training 減少 scene lock-in,令 rollout 期間可以擴展新場景同動態,唔使靠 prompt switching 硬接續。

測試方式算直接:項目已提供本地 gradio demo,同時有線上版 ABot World Studio;想自己部署,它在 Ubuntu 22.04、CUDA 13.3、NVIDIA RTX 5090 環境驗證過,並要先下載 ABot-World-0-5B-LF checkpoint。換句話說,現階段較適合把它理解成高階桌面 GPU 上的研究型互動系統,而唔係一般消費級硬件都能順手跑的輕量工具。

幾個重點值得留意:
ABot-World-0-5B-LF 已公開,屬於 causal student model
– 互動重點在連續探索,不是固定長度 video generation
– 本地推理與線上 playground 都已提供,驗證路徑清楚
– Bidirectional Teacher Model 仍未釋出,生態暫時未算完整

適合研究 world model、interactive video generation、Agentic 模擬環境,或者想為遊戲原型與具身智能測試場景找參考的團隊。現階段的吸引力在於它把「無限 rollout」和「單桌面 GPU 即時推理」放到同一個項目內。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視頻模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Linux, 蘋果

Qwen3.6 全新的動態 NVFP4 量化器

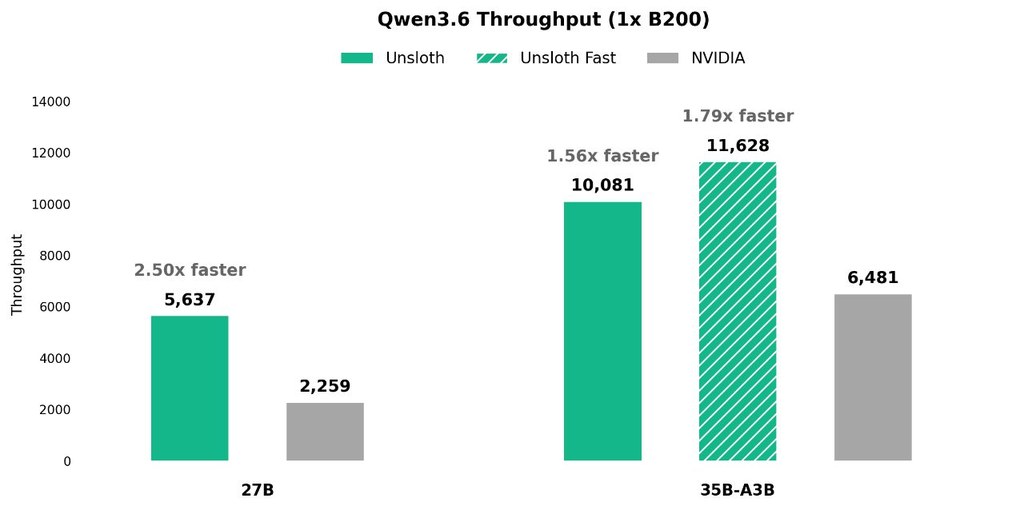
運行速度比其他 NVFP4 量化器快約 2.5 倍,效能更佳,檔案大小也相近。在24GB 記憶體上,Qwen3.6-27B NVFP4 的運行速度提升 2.5 倍;在32GB 顯存上,Qwen3.6-35B-A3B 的運行速度提升 1.7 倍。

Og image

想喺自己電腦上跑到規模較大的多模態模型,最大卡位通常唔係功能,而係記憶體同速度。Qwen3.6 屬於阿里巴巴的新一代多模態 hybrid-thinking 模型系列,重點在於用相對可控的硬件需求,處理 agentic coding、vision 同 chat 等工作。

現有資料提到兩個主力型號:Qwen3.6-27B 同 35B-A3B。前者可在約 18GB 記憶體配置下運行,後者約需 22GB 至 23GB 左右,並支援 256K context 及 201 種語言。對想喺本地做長內容理解、跨語言對話,或者配合工具調用工作流的人來說,這個取向幾實用。

相比只講「可量化、可本地跑」的常見做法,Unsloth 這邊更著重點樣揀到速度與準確度較平衡的版本。Qwen3.6 GGUFs 採用 Unsloth Dynamic 2.0,會按真實使用資料做 calibration,並把重要 layers upcast;另外新推出的 NVFP4 quants 主打在 GPU 上帶來約 2.5 倍更快速度,MTP 則標示可把 inference 再加快 1.4 至 2.2 倍,同時不犧牲準確度。

  • 適合本地部署多模態模型,兼顧編碼、視覺與對話
  • 27B、35B-A3B 記憶體需求相對克制,較易在個人設備起步
  • GGUF 格式配合 Unsloth Dynamic 2.0,重點是量化後仍保持可用表現
  • NVFP4 與 MTP 主要改善推理速度,幫助減少等待時間

使用上仍有幾點要留意:總可用記憶體最好高於下載的量化模型大小,否則雖然可經 llama.cpp 用 SSD/HDD offloading 繼續運行,但推理會慢得多;文件亦明確提醒不要使用 CUDA 13.2,以免輸出異常。整體來看,這不是單純把 Qwen3.6 搬到本地,而是把「跑得動、跑得快、精度仍可接受」這幾個取捨整理得更清楚。

所引用的模型列表:Qwen3.6-27B、Qwen3.6-35B-A3B。

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 多模態模型, Qwen, NVIDIA, API, 教學, Medical醫學, Python, 編程, OpenClaw, Anthropic

RCORE 為什麼我打不開抽屜

同一個抽屜,模型可能只見到物件就判成「關上」。RCORE 針對這種偏差補上時序線索,重點不在多記類別,而是少走錯路。

RCORE teaser

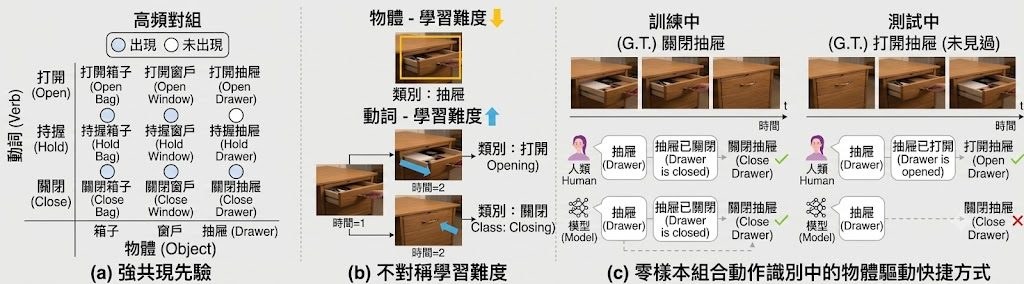
見到抽屜就猜「關上」、見到杯就猜「拿起」,正是 Zero-Shot Compositional Action Recognition (ZS-CAR) 最容易失手的位置。RCORE 是一個研究型模型項目,處理的是新 verb–object 組合辨識,核心不是再加更多標籤,而是壓低模型依賴物件類別走捷徑的傾向。

現有做法多數沿用已見過的共現關係去推斷動作,作者指出這種 fixed compositional supervision 會令模型把 object 當成近路,忽略影片中的 temporal evidence。RCORE 的回應很直接:用 CPR(Co-occurrence Prior Regularization)補足原本缺席的組合監督,同時把常見配對當成 hard negatives;再用 TORC(Temporal Order Regularization for Composition)迫使 verb 表徵對時間順序敏感,而不是學成靜態語意。

這個取向的價值,在於它不是單純追求更強 backbone,而是修正 ZS-CAR 的學習偏差。論文亦加入 FSP、FCP 與 Compositional Gap 這幾個診斷指標,不只看最後準確率,亦檢查模型是否真的較少受 co-occurrence patterns 牽引;已公開資訊指出,它在 Sth-com 與 EK100-com 都能改善 compositional generalization。

  • 重點放在減少 object-driven shortcuts,不是單靠物件猜動詞
  • CPR 針對訓練配對偏斜,TORC 針對時序線索不足
  • 準備 Python 3.10、requirements,以及特定 tokenizer 詞彙檔
  • InternVideo2 1B backbone 依賴 flash-attn,CLIP / InternVideo2-Base 則較易測試

部署與測試方式偏向研究流程:先安裝相依套件、準備資料,再跑 training 與 evaluation;它較適合做影片理解、組合泛化或 benchmark 分析的團隊,而不是即插即用的產品工具。相關模型與骨幹包括 CLIP、InternVideo2-Base、InternVideo2 1B;對於想研究模型為何會「看錯動作」的人,RCORE 比單看分數更有參考價值。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, Qwen, VLA, Robotic, Python, Dataset 數據集

IdeasHaveGenomes:用血統追蹤科研點子

研究提案寫得像樣,未必代表模型真正明白想法點樣演化。IdeasHaveGenomes把重點放在「點子血統」,專門測試 AI 能否追蹤繼承、變化同重組。

Ideas Have Genomes overview

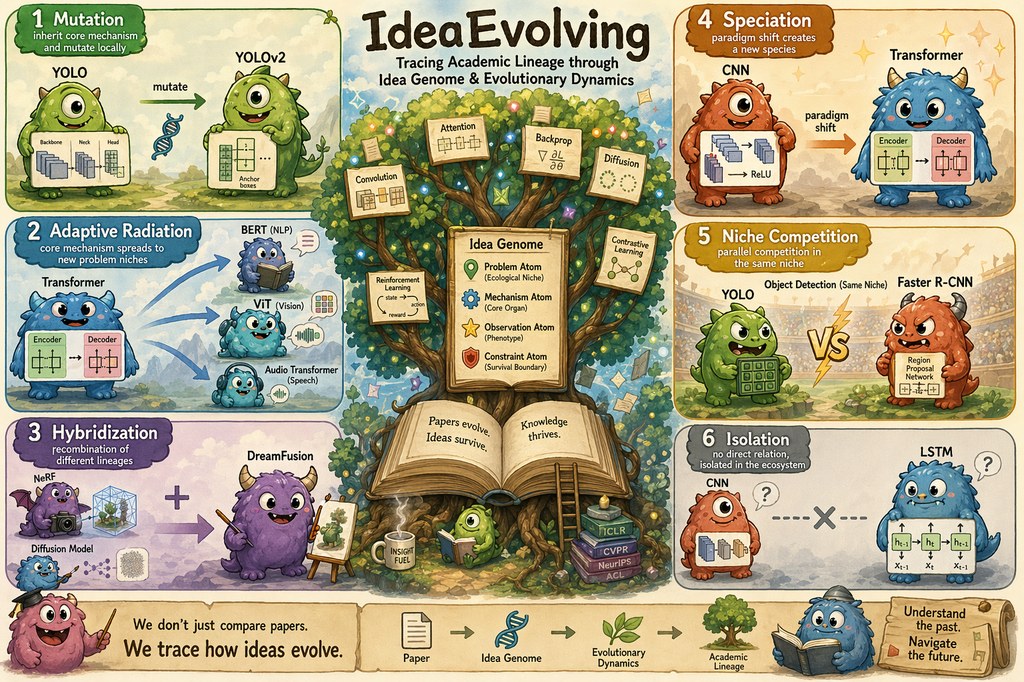
只會搵相似論文,已經唔足夠判斷 AI scientist 是否真係理解研究想法。IdeasHaveGenomes 把科學點子當成有 lineage 的對象去看,屬於 benchmark/數據集類型的項目,針對的正是 Auto Research 入面最難驗證的一環:模型能否講清楚一個 idea 由邊度嚟、點樣修補舊限制,最後點解值得延伸。

現有做法好多時集中在 related paper retrieval、proposal writing,或者用開放式生成結果做人手印象分。作者認為呢種範式捉唔到 inheritance tracing 同 evolutionary reasoning,所以提出 IdeaGene-Bench(IG-Bench),把任務分成封閉式測試 IG-Exam,同埋用 Population-Evolution Score(PES)評分的 IG-Arena,前者問理解是否精準,後者先看生成內容有冇 lineage 根據。

項目的可取之處,在於它唔只問「像不像新點子」,而係追問 Heredity、Variation、Selection 有冇成立。資料規模亦算完整,包括 1,961 條 golden lineage traces、1,085 個 Idea Genome objects、920 筆 GenomeDiff records,覆蓋 10 個 scientific domains;IG-Exam 進一步拆成 42 類 task、1,029 個 closed-form instances,適合做可重覆比較。

  • IG-Exam 主要測 abstraction、inheritance tracing、evolutionary reasoning、lineage verification
  • IG-Arena 針對開放式提案生成,用 PES 檢查血統延續與變化是否合理
  • 項目可用 OpenAI-compatible API 跑 smoke test 或完整評測,不一定綁死單一模型
  • 現有結果反映難度高,最佳 IG-Exam exact accuracy 只有 27.3%,最佳 T4 verification 為 17.4%
  • 榜單涵蓋 GPT、Claude、Qwen、Gemini、DeepSeek,以及 AI Scientist v2、Codex、Claude Code 等系統

部署理解上,這不是拿來直接替代研究助手的成品工具,而是用來測試模型或 agent workflow 是否真的具備「科研點子血統推理」能力。較適合做 AI scientist、research agent、proposal generation pipeline 的團隊評測基準;想比較不同模型、judge 組合,或者檢查生成提案有冇沿住正確 lineage 發展,這個項目比一般文字基準更有辨識度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, 微軟, OpenAI, DeepSeek, Gemini, API, 框架, Anthropic, 中國, Dataset 數據集

SPLASH 讓小型 MLLM 學會觸覺

SPLASH想處理的,不是單純加一個感測模組,而是令小型多模態模型學觸覺時唔會忘記原本的視覺語言能力。你可以把它理解成一種有節制的微調方法,專門避開災難性遺忘。

figure

想將觸覺資料接入小型多模態模型,最麻煩的地方往往不是接唔接到,而是模型一邊學「摸到乜」,一邊把原本「睇到乜」的能力搞亂。SPLASH屬於模型訓練框架,針對的正是 MLLMs 在加入 tactile perception 後容易出現的 catastrophic forgetting,目標是在保住 vision-language 能力之下完成 visuo-tactile 對齊。

它的取向幾清楚:唔係全面重訓,也唔係隨便加一條 tactile branch 就算,而是先在 LLM backbone 入面找出較「沉睡」的參數空間,再把觸覺學習限制在呢部分。項目提到它用 weight 與 activation importance scoring 生成 dormant masks,之後做 mask-guided sparse training;好處是唔使大幅動到關鍵視覺語言參數,代價則是整個流程仍然偏研究型,部署前要先備好資料集、分割資料,同時需要 CUDA 12.0 以上與至少兩張 GPU 做分散式訓練。

現有版本主要有兩個模型變體:SPLASH-1B 以 InternVL2.5-1B 為 base MLLM,SPLASH-3B 則建基於 Qwen2.5-VL-3B,兩者都配合 ViT-Tiny + MLP adapter 作 tactile frontend。資料部分亦唔算輕量,除了 LLaVA-CC3M-Pretrain-595K 與 CC3M 用來生成 mask,仲要配合 Touch-Vision-Language-Dataset、TacQuad 等項目做訓練與 OOD 評估,所以它比較適合做多模態研究、機械感知、或想驗證觸覺—視覺聯合推理的團隊。

  • 重點不在新增多少參數,而在把觸覺更新隔離到 dormant subspace
  • 基底模型包括 InternVL2.5-1BQwen2.5-VL-3B
  • 觸覺前端採用 ViT-Tiny + MLP adapter
  • 評估覆蓋 SSVTP、TVL、TacQuad,並強調保留原有通用能力

以公開資訊判斷,SPLASH最值得留意的不是單一 benchmark 分數,而是它明確押注「non-destructive modality expansion」:讓模型多學一種感官,而唔需要用視覺能力做交換。對打算在緊湊參數預算下擴展 MLLMs 感知模態的研究項目而言,這個方向比單純追高表現更有參考價值。

項目主頁 · GitHub

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, Dataset 數據集

AgentCanvas:把 embodied agent 變成可編輯圖譜

想試 embodied agent,最花時間往往不是想法,而是把模擬器、模型與工具串起來。AgentCanvas 把這層 execution stack 圖像化,方便研究團隊直接改結構、跑實驗、比較結果。

AgentCanvas editor: the MapGPT executor loads as a node-and-wire graph, then a live R2R episode runs end-to-end

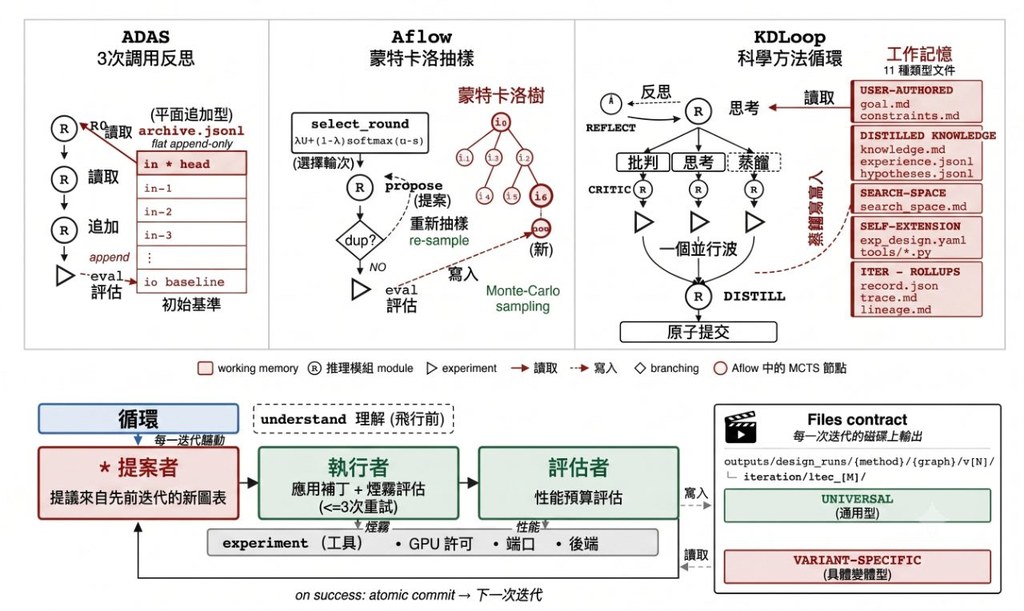
卡位不在模型夠唔夠新,而在整個 embodied agent 系統太厚:simulator、perception、memory、planning 同 control 全都要接通。AgentCanvas 把這件事收斂成可執行的 typed graph 平台,用單一 JSON 保存一個 agent 結構,讓 VLN、EQA、VLA 一類工作不再每次都由 execution layer 重搭起步。

這個項目是把 embodied agent 改寫成可視化、可重播、可修改的圖譜程式。現有做法多數靠手寫 imperative code 逐層綁死 simulator、工具與 foundation models,作者認為這種範式難以比較、難以重現,也不利 architecture search;所以 AgentCanvas 先提供 substrate,再用 KDLoop 與 AAS 讓 coding agent 反覆改圖、驗證、再分析。

AgentCanvas 重點放在把 agent 結構標準化,而不是只交一份論文內部 executor。你可以在 editor 直接載入節點圖,跑真實 R2R episode,也可接 Habitat-Sim、MatterSim、SAPIEN/ManiSkill2、MuJoCo/robosuite 這些 simulator;新加入的 Source tab 還可就選定 node 回看 source slice,改完再 syntax-checked hot-reload,這對反覆試設計特別有用。

  • 支援 hand-built graphs,也支援 AAS 自動搜尋 agent 架構
  • 已接入 29 個 foundation models,包括 Qwen3-VL、InternVL3、Gemma 3、SmolVLM2、SigLIP2、OWLv2、Grounding DINO
  • 可覆蓋 VLN、EQA、VLA 與鄰近 embodied 任務
  • 研究預覽版已開源,環境基礎要求為 Python 3.10+

受益最明顯的,會是做 embodied AI 的研究團隊、要重現論文 executor 的學生,以及想比較不同 graph 設計而不是重寫整個系統的人。現階段它仍是 pre-1.0 research preview,性能數字應結合原論文結果閱讀;但單看定位,AgentCanvas 最有價值的地方,是把「難以維護的 agent 系統工程」變成「可被搜尋與修改的圖譜工作流」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, Qwen, Gemini, VLA, 框架, Vibe Coding, Python, 編程, Anthropic, Dataset 數據集

SciReasoner 想把科學推理拉回結構本身

做蛋白質、分子同材料推理,只靠文字序列往往唔夠。SciReasoner把3D結構直接變成可推理證據,重點是答案背後的科學線索都盡量保留。

SciReasoner architecture overview

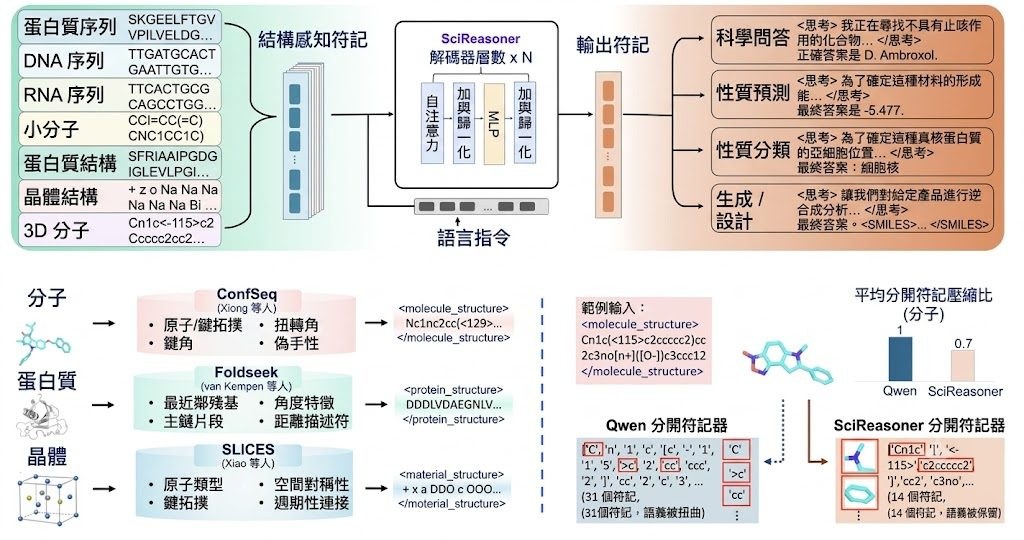
只看文字去判斷蛋白質功能、分子反應性或材料性質,經常會漏掉真正關鍵的空間結構。SciReasoner屬於多模態 scientific foundation model,針對的正是這個落差:把 protein structures、3D molecules、crystals、sequences、formulas 同 text 轉成可對照的 structure-aware evidence tokens,再用來做 scientific QA、prediction、classification 同 generation/design。

與科學資料先「文字化」再交畀大型語言模型處理的做法不同。作者明確押注 native structural reasoning,保留 Foldseek 3Di、ConfSeq、SLICES 呢類結構編碼,令模型唔係淨係讀描述,而係可以沿住 residues、fragments、conformers 甚至晶體配位環境去推理;官網展示的 traces 亦反映出,項目希望連推理路徑都可以檢查,而唔只係輸出答案。

GitHub 上的 models 同 demo 仍標示為 coming soon。換句話說,眼前較合理的理解方式係先把它當成研究型項目:閱讀 benchmark、看案例 traces,判斷它是否適合生物資訊、化學資訊或材料 AI 團隊之後的評測與整合方向,而唔係即刻下載部署到生產流程。

  • 在 86 個評測任務入面,67 個做到 state-of-the-art,對比 generalist LLM baselines 有 75 個任務表現最好
  • 與已發表的 specialist 方法相比,在 33 組比較入面有 26 組持平或更好
  • 範圍唔只化學,亦覆蓋 proteins、DNA/RNA、small molecules、3D molecular structures 同 inorganic crystals
  • traces 可檢查,雙盲專家評分中,與 DeepSeek-V4-Pro 相比有 98% 判斷屬 preferred 或 comparable

相關模型方面,SciReasoner以 Qwen3-14B 初始化,再對齊 domain-native structural vocabularies。對需要跨蛋白質、核酸、分子同材料做統一推理介面的團隊,呢個方向幾有吸引力;限制同樣明顯,因為公開模型與可直接測試的 demo 尚未提供,現階段更適合當成值得追蹤的研究項目,而唔係可即用工具。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 南京大學, 模型, 多模態模型, Qwen, DeepSeek, 香港, Medical醫學, 3D, 中國, Dataset 數據集

LingBot-Video 想做懂物理的生成影片

首个面向具身智能的大规模开源 MoE 视频基础模型。一般影片模型擅長畫面氣氛,未必處理到動作同物理合理性。LingBot-Video把重點放到具身智能場景,取向相當鮮明。

T2V Quality Score

生成影片要做到「似真」,唔只係畫面靚,仲要交代到動作、物件同物理世界之間嘅關係。LingBot-Video屬於開源視頻模型,主打 embodied intelligence,想補足一般 T2V 只重視視覺效果、但對任務過程同物理合理性掌握較弱呢個缺口。

呢個項目的取向幾清楚:唔係單純追求更大參數,而係用 MoE(Mixture-of-Experts)架構去平衡容量同推理成本,官方說法指推理可快約 3 倍。訓練資料亦唔只靠網絡影片,仲加入超過 70,000 小時 embodied data,再配合 multi reward system,同時兼顧美感、physical rationality 同 task completion。

部署理解上,它已提供完整模型下載入口,同時覆蓋 Hugging Face、ModelScope 以及文件站;推理路線分成 diffusers 同 SGLang Diffusion,代表團隊唔只放權重,亦有考慮不同推理堆疊。README 亦列出 rewriter,當中包括以 Qwen3.6-27B 為基礎嘅版本,以及 Qwen3.6-27B LoRA adapter,表示提示詞改寫都係整個工作流一部分。

  • 提供 LingBot-Video-DenseLingBot-Video-MoE,前者較像基線路線,後者加入 Refiner
  • 任務覆蓋 T2I、T2V、TI2V,唔只限純文字轉影片
  • 以 embodied data 同多重獎勵機制強化動作合理性
  • 有文件、模型頁同技術報告,較適合研究團隊同進階內容生成流程測試

受益最大嘅,會係想做機械人模擬、具身智能研究、動作導向影片生成,或者需要比較「任務是否完成」而唔只係「畫面是否好睇」嘅團隊。現有資訊未見到完整基準分數整理,所以性能判斷暫時仍要配合官方技術報告同實測;不過以開源定位、MoE 架構、Refiner 同 rewriter 一併公開嚟睇,LingBot-Video明顯係朝住較完整嘅研究與部署鏈路去設計。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Qwen, Video

Page 10 of 19
1 8 9 10 11 12 19