ROSE2025,全名為「可靠且開放集事件修補(Remove Objects with Side Effects)」。旨在推動電腦視覺領域,為處理複雜、動態的視覺數據缺失問題提供更穩健、更智能的解決方案。在不斷演進的電腦視覺領域,事件修補(Event Inpainting)正成為一項引人注目的新興研究方向。 ROSE2025 涵蓋了多個關鍵研究主題,包括但不限於:基於生成式模型的事件修補方法、深度學習在事件資料恢復的應用、新穎的損失函數與評估指標、開源數據集與基準的創建、以及與機器人、自動駕駛、監控等實際應用場景的結合。
ROSE2025,全名為「可靠且開放集事件修補(Remove Objects with Side Effects)」。旨在推動電腦視覺領域,為處理複雜、動態的視覺數據缺失問題提供更穩健、更智能的解決方案。在不斷演進的電腦視覺領域,事件修補(Event Inpainting)正成為一項引人注目的新興研究方向。
AI 不僅能創造出栩栩如生的圖片,還能生成數分鐘、甚至更長,且故事連貫、情節流暢的影片。這曾是生成式AI領域一個巨大的挑戰。然而,一項名為「上下文混合」(Mixture of Contexts, MoC) 的創新技術,正逐步將這個夢想變為現實。這項由 Shengqu Cai 等研究人員提出的最新進展,為長影片生成帶來了革命性的解決方案,有效克服了現有模型在處理「長期上下文記憶」上的瓶頸。 生成長影片的核心挑戰,在於模型必須能夠在漫長的時間序列中,保持並檢索關鍵事件,同時避免資訊崩潰或內容漂移。現有的擴散變換器(diffusion transformers)雖然在短影片生成方面表現出色,但其自注意力(self-attention)機制的二次方成本,使得處理長序列時,記憶體和計算資源的消耗變得難以承受,導致效率低下且難以優化。這意味著,隨著影片時長的增加,AI模型可能會「忘記」影片開頭的人物身份、動作或場景設定,導致影片內容的連貫性、一致性大大降低。
AI 不僅能創造出栩栩如生的圖片,還能生成數分鐘、甚至更長,且故事連貫、情節流暢的影片。這曾是生成式AI領域一個巨大的挑戰。然而,一項名為「上下文混合」(Mixture of Contexts, MoC) 的創新技術,正逐步將這個夢想變為現實。這項由 Shengqu Cai 等研究人員提出的最新進展,為長影片生成帶來了革命性的解決方案,有效克服了現有模型在處理「長期上下文記憶」上的瓶頸。
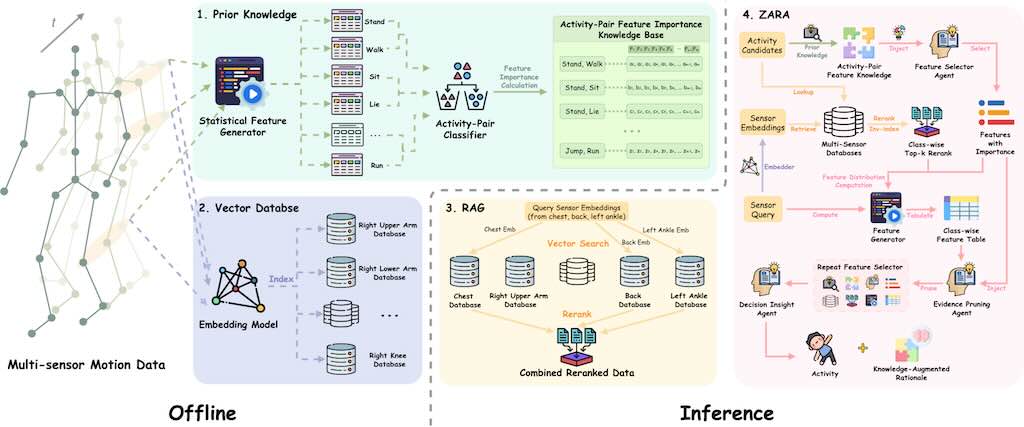
ZARA 是一個用於人類身體活動識別 (HAR Human Activity Recognition) 的新型框架,它利用穿戴式感測器的原始運動數據。傳統的 HAR 系統通常需要針對特定任務的深度學習模型進行昂貴的重新訓練,而且在引入新感測器或未見活動時,其泛化能力和零樣本識別能力有限,同時也缺乏可解釋性。 ZARA 透過結合多感測器檢索增強生成 (RAG)、自動化的成對領域知識注入和層次代理式大型語言模型 (LLM) 推理來克服這些限制。ZARA 不需額外訓練,就能在多種數據集和感測器配置上實現零樣本分類,其性能超越現有方法,並可提供驗證。研究強調了其檢索、知識庫和代理模組在提升準確性和支援決策方面的關鍵作用。
ZARA 是一個用於人類身體活動識別 (HAR Human Activity Recognition) 的新型框架,它利用穿戴式感測器的原始運動數據。傳統的 HAR 系統通常需要針對特定任務的深度學習模型進行昂貴的重新訓練,而且在引入新感測器或未見活動時,其泛化能力和零樣本識別能力有限,同時也缺乏可解釋性。
ZARA 透過結合多感測器檢索增強生成 (RAG)、自動化的成對領域知識注入和層次代理式大型語言模型 (LLM) 推理來克服這些限制。ZARA 不需額外訓練,就能在多種數據集和感測器配置上實現零樣本分類,其性能超越現有方法,並可提供驗證。研究強調了其檢索、知識庫和代理模組在提升準確性和支援決策方面的關鍵作用。