VDN-H3 開源:14 秒 MiniMax 影片生成只花 11 秒

OpenVDN 團隊將 softmax 與線性注意力混合架構(hybrid attention)套用到 MiniMax H3 影片生成模型,在 8 張 B200 上以 8 步去噪產出 14.4 秒 768p 影片,速度比播放還快。

Repository image for OpenVDN/vdn-minimax-h3

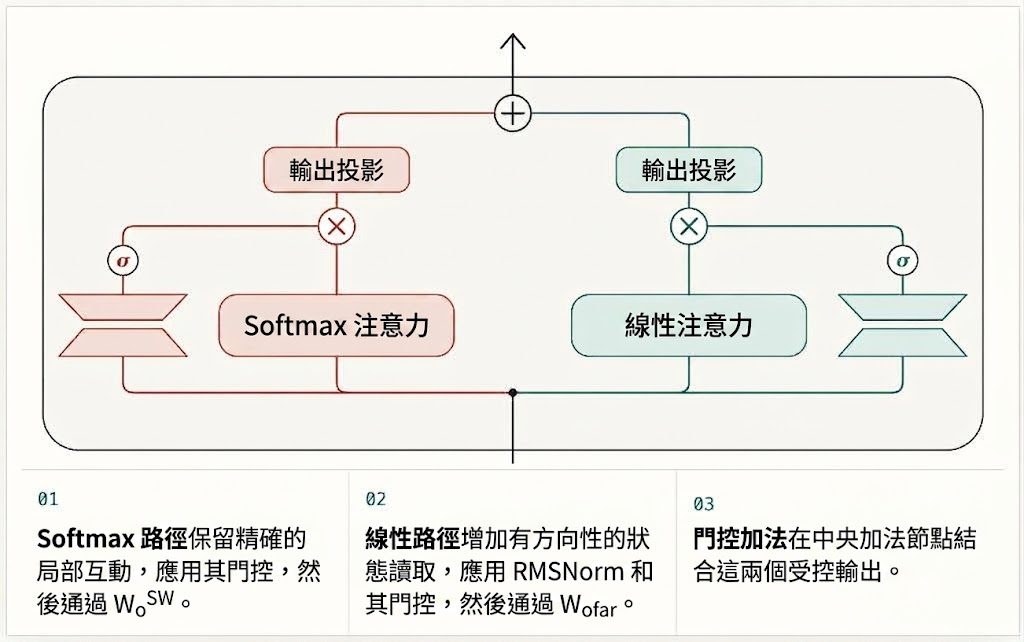
影片生成最貴的部分往往不是參數量,而是長序列上的 softmax attention。VDN-H3 針對這個痛點,把 MiniMax H3 骨幹拆成兩條互補分支:滑窗 softmax 負責鄰近幀之間的精細對齊,線性注意力則接手長距離語境與主體一致性,並用 4 向邊界錨點補強全域結構。最終在 8 張 NVIDIA B200 上,用 8 步去噪就能在 11.23 秒內生成 14.4 秒 768p 片段,生成速度比播放還快。

與同類做法的差異在於「近乎無損」這個定位。純線性注意力雖然快,但長序列下容易丟失主體身份、場景佈局與時序依賴;VDN-H3 透過混合架構把這部分成本交回給局部 softmax,線性分支只負責長程記憶,因此視覺品質與原版 H3 幾乎難以區分,也比 MiniMax FastH3 有更好的指令跟隨能力。對需要高吞吐量同時不犧牲一致性的團隊,這個取捨相當實用。

部署面需要 PyTorch 2.13、CUDA 12.9 與 FlashAttention 4(含 nvidia-cutlass-dsl 預釋版依賴),另外還要安裝一份修補過的 Diffusers;骨幹權重不需更動,兩條 LoRA adapter 可在推理時合併進去,等同 plug-and-play 替換。程式碼、訓練流程與優化後的推理 stack 一併開源,研究者與影片生成產品團隊都能直接複用。

重點摘要

  • 8 步去噪、8 張 B200,11.23 秒生成 14.4 秒 768p 影片,生成快過播放。
  • 混合 attention:滑窗 softmax 保留局部細節,線性分支負責長距離語境。
  • 視覺品質與原版 MiniMax H3 近乎無損,比 FastH3 指令跟隨更佳。
  • LoRA adapter 可合併進骨幹推理,不需更動原始權重。
  • 權重、推理 stack 與訓練程式碼同步開源。

項目主頁 · GitHub · 模型· ComfyUI 節點
Categories: 開源, AI productions, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, Python, MiniMax

RoboTok:用 YouTube 影片教機械手做家務

RoboTok 把網上大量的人手操作影片變成機器人訓練素材,對應一段示範就能自動撈出動作相似的影片做模仿學習,等 AI 機械手多了一條低成本數據來源。

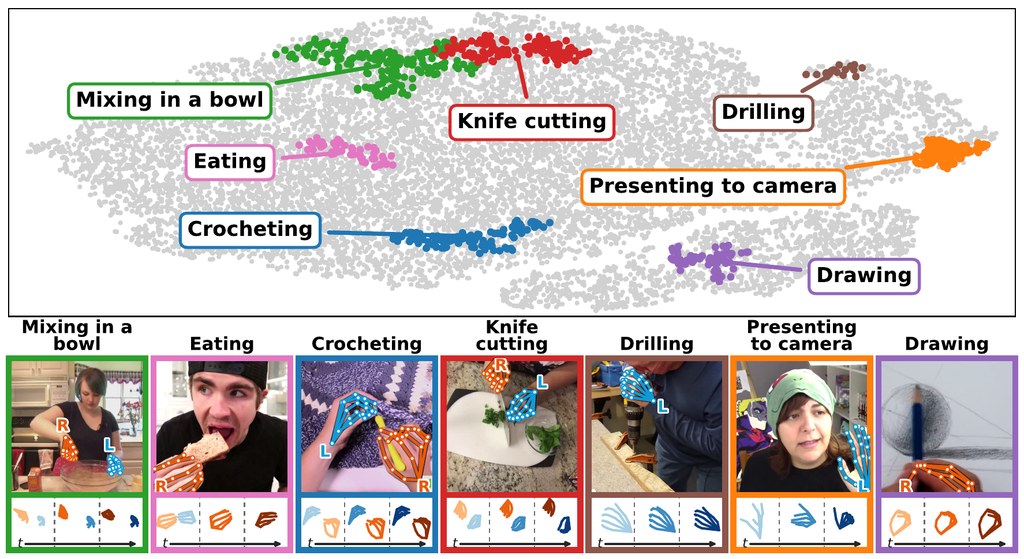
Retrieval embedding space and example clips

想訓練機械手做家務,最貴的部分往往不是模型,而是數據。RoboTok 由 Rice University 及 NVIDIA 合作開發,直接從海量網絡影片中撈取人手操作片段,再交給擬人機械手學習。它屬於一種數據引擎兼策略學習框架,把「找對數據」這一步自動化掉。

核心做法是把人手動作抽成以軀幹為基準的 3D 手部軌跡,再學一個嵌入空間,用 DTW(Dynamic Time Warping)相似度作監督,令同一種操作(例如倒水、摺衫)在不同鏡頭、不同人、不同場景下都能對齊。查詢時只要給一段示範影片,系統就用 cosine similarity 找出動作最相近的網絡片段。

  • 以軌跡為單位做檢索:避開外觀差異,直接比動作本體,所以鏡頭變、場景變、人變都唔會影響配對。
  • 配套軀幹估計模型:用雙手軌跡反推出身體/軀幹參考框,減少裁切與遮擋帶來的偏差。
  • FAISS + GPU DTW:向量檢索用 FAISS,DTW 內核用 numba CUDA,跑大規模影片庫唔會慢到難以迭代。
  • 機械人策略學習閉環:檢索結果直接餵下游模仿學習,做擬人機械手 policy 訓練,並已在仿真及真機任務做評估。

同類做法多數只用影片幀或粗糙動作標籤做檢索,容易被背景雜訊干擾。RoboTok 走 3D 手部軌跡嵌入這條路,換來更精準的動作匹配,但代價是 pipeline 較重:要裝 MANO/SMPL-H 體模、CUDA 環境,再跑一套自帶的訓練與評估流程。

最受惠的是做擬人機械手、靈巧操作(dexterous manipulation)研究的團隊,以及想用低成本網絡影片取代部分遙操作數據的工作小組。對只想要開箱即用機械人策略的人來說,門檻仍然偏高;對做數據策展與 representation learning 的人,呢套引擎本身就值得參考。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, NVIDIA, Robotic, 3D

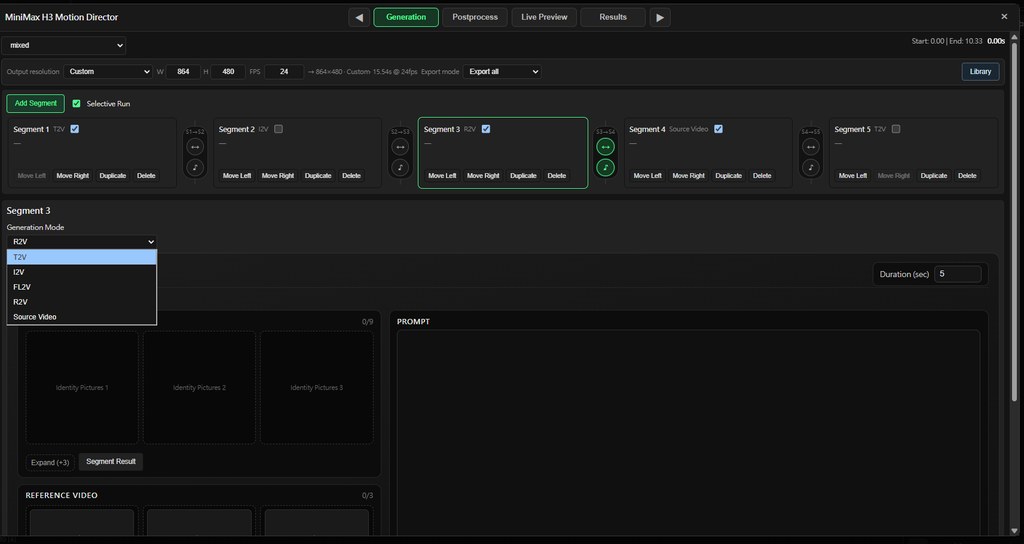
MiniMax-H3-Motion-Director 全能導演台節點

ComfyUI 自訂節點 Motion Director 將 T2V、I2V、V2V 等多段生成整合到同一介面,支援分鏡重跑、跨鏡頭連貫與即時預覽,讓多片段 AI 影片製作不再被節點海淹沒。

MiniMax H3 Motion Director — Mixed Mode

用 ComfyUI 砌 AI 影片嘅朋友,多數都經歷過呢個困局:想做一個有五個鏡頭嘅項目,要由零開始接 T2V、I2V、V2V 各種 workflow,每段調好參數再串埋,節點一多就連自己都搞唔清邊段行緊、邊段要重做。Motion Director 想處理嘅就係呢個問題——佢係一個 ComfyUI 自訂節點,把多段影片生成收納到同一個 Director 介面,等你可以逐段揀唔同生成方法(T2V / I2V / FL2V / R2V / V2V / RV2V),又唔使為咗切換而重新拉整個圖。

佢同一般 ComfyUI 工作流最大嘅分別,係圍繞「項目」做設計。Director 介面入面有 Segment、Multi Segment、Final Result 三層檢視,亦有 Director Live Preview 即時顯示邊段行緊、邊段做完。跨段連貫靠 Motion Context、Context Frames、Latent Scale Lock 同生成音訊接續,仲可以將上一段已解碼嘅幀直接當下一段嘅 I2V/FL2V 輸入,避免每次都重新生成首幀。素材方面提供 Common References 同持久化 Material Library,圖、音、影片、提示詞都可以重複用。

另一個貼地嘅設計係 Selective Run——只要揀要重做嘅片段就得,唔使成條 pipeline 重跑,配合 MIXED 模式用,可以幾段文生、幾段圖生、幾段源影片剪輯混埋做項目。Director 本身係 OUTPUT_NODE,最尾嗰格就可以輸出畫面、音訊同 FPS 畀下游 ComfyUI 節點繼續接。後製方面內置 Global Refine、放大、可揀 NVIDIA RTX VSR / Deblur 同 Face Refine,不過 VSR/Deblur 要相容 NVIDIA VFX runtime,Face Refine 要 UI 揀好對應 detector/SAM 路徑。

適合要處理多鏡頭、有分鏡表、要保持視覺同音訊一致嘅創作者,例如廣告原型、MV 概念、敘事短片預覽,或者要把源影片做局部 V2V/RV2V 修補嘅後期流程。生成方面支援內建 sampling 或外部 ComfyUI SAMPLER + SIGMAS,方便想自己控制 noise schedule 嘅人。版本去到 v1.2.0,採用 GPL-3.0;硬件門檻就睇你揀嘅功能——基本生成跟返 ComfyUI 一般配置,想用 VSR/Deblur 或大尺寸放大就要 NVIDIA 顯卡同對應 runtime。

重點摘要:

  • 多段整合 Director 介面:T2V/I2V/FL2V/R2V/V2V/RV2V 同一畫面揀,逐段切換唔使重拉 workflow
  • Selective Run + Mixed Mode:只重跑指定片段,唔使成條 pipeline 由頭嚟
  • 跨鏡頭連貫:Motion Context、Context Frames、Latent Scale Lock 同音訊接續,仲可以重用上一段解碼幀
  • 內建 Live Preview 與三層檢視:Director 介面直接睇 Segment/Multi Segment/Final Result
  • 後製選項齊全:Global Refine、放大、可選 RTX VSR/Deblur 與 Face Refine,對硬件有特定要求

GitHub

Categories: 開源, ComfyUI, AI productions, NVIDIA, Video, 框架, , MiniMax

ComfyUI-CGlide:MiniMax H3 短片創作者的自訂節點

這是一套給 ComfyUI 用的 MiniMax H3 影片生成自訂節點,把提示詞拼裝、即時預覽、寫檔與續接四步壓成四個節點,特別適合用 H3 拍短片的人。

Repository image for CGlide/ComfyUI-CGlide

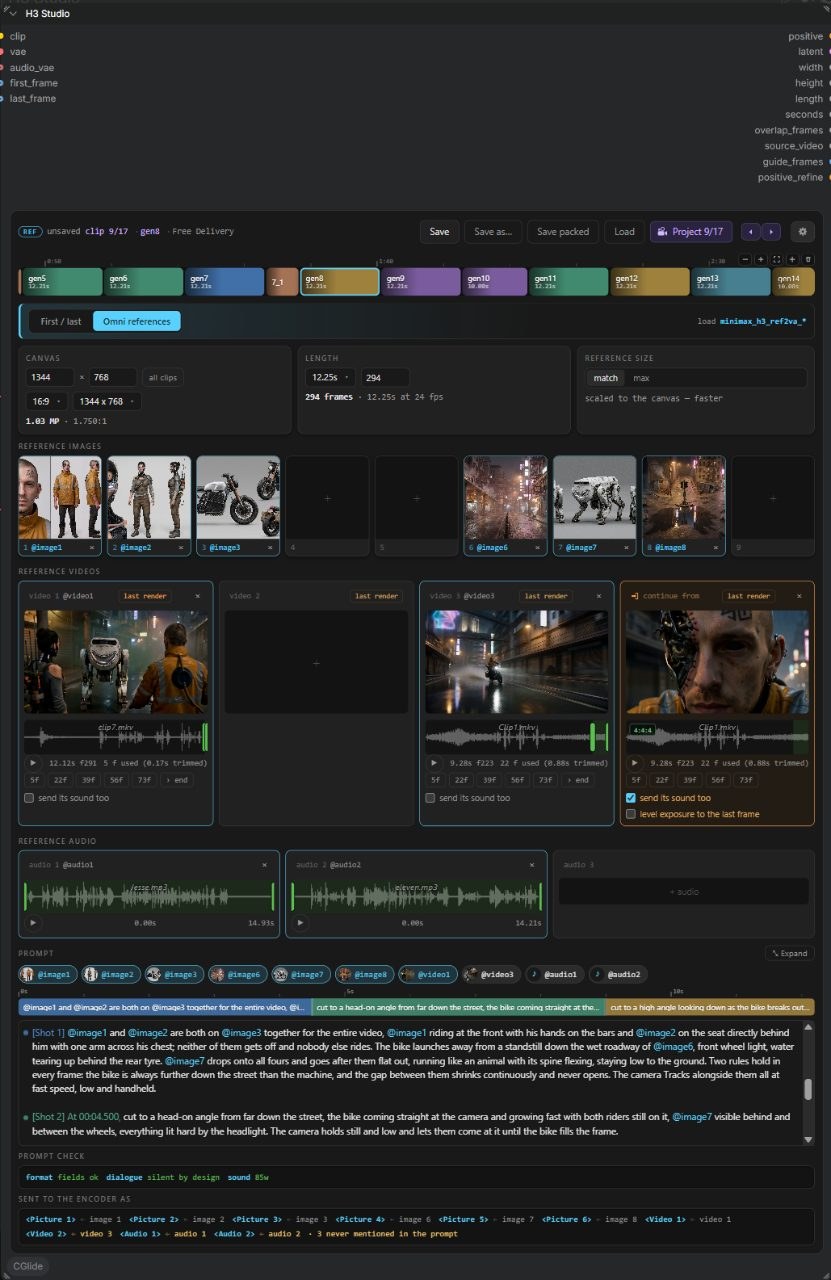
想做 H3 短片但不想在 ComfyUI 裡堆十幾個 loaders 同 text box 嘅人,可以留意 CGlide 嘅呢套自訂節點。佢將成個 H3 影片生成流程拆成四個節點:拼裝 prompt 同 conditioning、邊取樣邊預覽當下鏡頭、寫出影片檔,以及將續寫片段接返去原本嘅 clip。H3 Studio 更加將九張圖、三段影片、三段聲音同 prompt 全部塞入一個面板,但保留原本嘅 sampler 同步數,唔會插手推 sampling。

安裝好簡單,喺 ComfyUI Manager 搵 CGlide 或者 git clone 入 custom_nodes就得,不過官方提醒 ComfyUI 一定要更新,因為低 VRAM 嘅 w4a8 路徑要 0.31.0 或以上,否則會出黑畫面有聲冇畫,唔彈 error。模型要從 Comfy-Org 嘅 MiniMax H3 repo 拎,reference-to-video 或 first-last-frame checkpoint 入 diffusion_models,text encoder 入 text_encoders,影片同音訊 VAE 就擺去 vae。VRAM 唔夠嘅話可以用 Kijai 嘅 w4a8 版同 int8_convrot video VAE,大約 11.8 GB 就推到,原 workflow 唔使改。

H3 Studio: prompts, projects and clip extension for MiniMax H3

呢套節點嘅 chain 機制用 source_video 同 guide_frames 兩個輸出做接駁,比較啱做有連貫性嘅敘事短片,作者就用呢套工具完成咗 THE RECITATION。PyAV、torchaudio 同 ffmpeg 屬於依賴項目,PyAV 多數已經裝好,ffmpeg 放上 PATH 就夠,Glide Video 內部會 shell out 畀佢用。

對習慣 ComfyUI 節點工作流、又想用 H3 拍短片或敘事片段嘅創作者嚟講,呢套節點減少咗重複接線嘅時間,亦令低顯存方案更易落地。

重點摘要:
四節點設計:拼 prompt、即時預覽、寫檔、續接,分工清晰。
H3 Studio 整合面板:九圖三影片三音訊同 prompt 集中管理,但唔干預 sampling。
低 VRAM 路徑:w4a8 加 int8_convrot VAE 約 11.8 GB,但要 ComfyUI 0.31.0 以上。
chain 輸出:source_video 同 guide_frames 支援敘事鏡頭接駁。
作者實戰驗證:用同一套工具完成短片 THE RECITATION

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 多模態模型, Video, Audio, 提示詞, 工具, Content Creator, Clone, MiniMax

KBMR 視覺問答檢索帶向實體語義

KBMR 針對 KB-VQA 容易搵錯相似圖片的問題,以 MLLM 將檢索焦點由外觀匹配轉向實體語義。

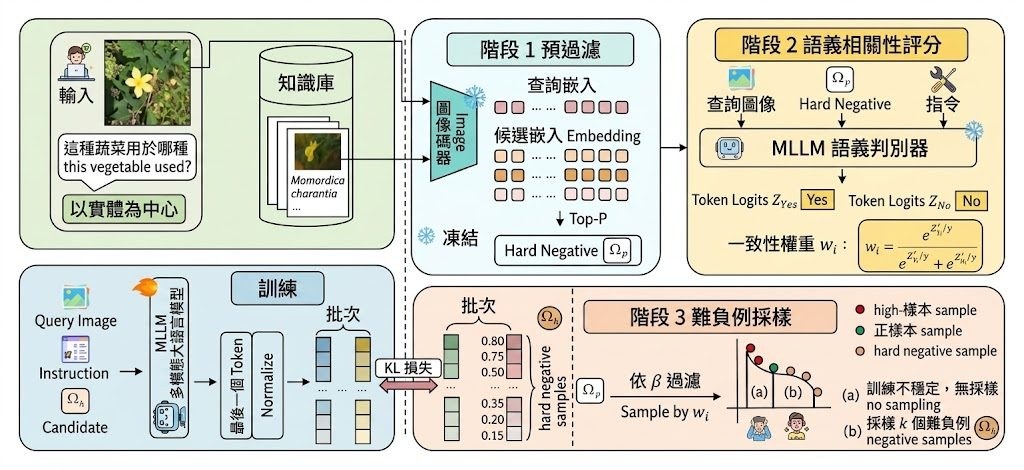
KBMR method overview

面對人物、地點或物件,KB-VQA 若只按圖片外觀搜尋,容易因視角、年代和風格變化搵錯資料。KBMR 屬於面向 Knowledge-Based Visual Question Answering(KB-VQA)的多模態模型檢索器,實際處理的是「畫面相似但實體不同」的證據搜尋問題。

KBMR 先由 EVA-CLIP-8B 篩選候選,再以 MLLM-based Semantic Discriminator 為查詢與候選產生連續的 entity-consistency weights。Qwen2-VL-7B 以這些語義訊號訓練 embedding retriever,並透過 symmetric KL distillation,令 cosine similarity 得出的 retriever posterior 與 discriminator weights 形成的 semantic prior 對齊。

重點整理為:
– 由 surface-level visual matching 改為 entity-aligned semantic retrieval。
– 連續權重可支援較可靠的 hard-negative mining 和 soft supervision。
– 替換原有 first-stage retriever,毋須改動下游 reasoning 或 reranking。
– 不同 KB-VQA pipeline 的端到端答案準確率最高提升 9.4 個百分點。

這種取捨適合已有 KB-VQA、外部知識庫和後續推理流程的研究團隊,因為 KBMR 主打 plug-and-play 替換檢索器,而不是重新設計整條系統。KBMR 列出 Python 3.10+、EVA-CLIP-8B 及 Qwen2-VL-7B 等準備項目,亦包括訓練和評估章節;目前已提供完整安裝指令、模型取得方式及獨立推理流程。

GitHub

Categories: 開源, Embedding, 視覺模型, 多模態模型, Qwen, Python

SimLoss 用單次生成多階段圖像描述

由 UMass Amherst 與 Adobe Research 團隊開發,SimLoss 想解決圖像描述太籠統的老問題。它把細節監督搬到 embedding space,換來更快推理與更高描述精細度。

Repository image for srynsh/SimLoss-Image-Captioning

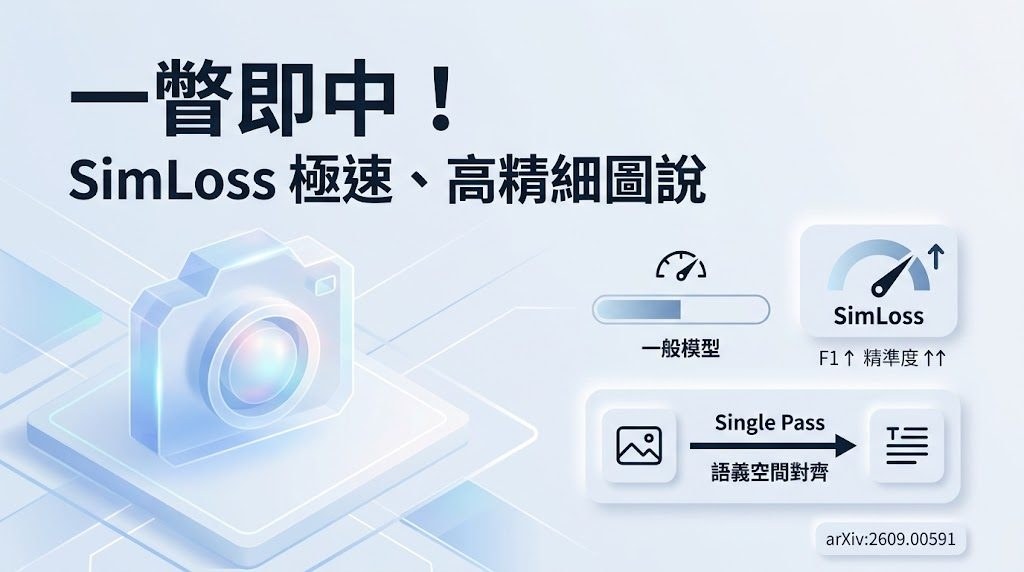
UMass Amherst 與 Adobe Research 團隊,瞄準的是圖像描述常常只講到大意、漏掉材質、數量、紋理同位置關係的問題。SimLoss 屬於影像 captioning 模型訓練方法,核心不是再加一條冗長後處理流程,而是令 Vision-Language Model 在單次生成前,先把隱藏狀態對齊影像 embedding,直接補回細節監督。

它的技術關鍵,在於用 reference-free 的 embedding-space objective 取代人手撰寫細粒度 captions,亦唔需要先跑多階段系統去製造 pseudo-captions。SimLoss 列出兩條路線:SimLoss FFT 會透過本地可用的 Qwen3-VL-Embedding-2B 反向傳播;SimLoss GRPO 則把 Gemini Embedding 2 當成 black-box reward。兩者都建基於 Qwen2.5-VL-7B-Instruct captioning policy,但前者偏向直接做表徵對齊,後者更接近以獎勵訊號微調。

同類方法常見做法,是生成、拆解、驗證、重寫逐步修補描述內容;SimLoss 揀的是保留 single-pass inference,換取更低延遲,再用對比式學習補回細節。代價是它仍然依賴外部 embedding 模型品質,而且項目展示的是研究基準與訓練框架,不是即裝即用的成品服務。

IIW-400 測試中,SimLoss FFT 配合 Qwen2.5-VL-7B backbone,把 precision 由未調整 backbone 的 0.788 提升到 0.849,F1 與多階段 CapMAS 接近到難以區分,同時推理速度約快 20 倍;SimLoss GRPO 則拿到最強 recall。呢個取捨幾實際:想要更準確地講出畫面細節,又唔想接受多步驗證延遲的團隊,會比一般 captioning fine-tune 更感受到差別。

  • 同一儲存庫放入 SimLoss、CapMAS、PAPO、DCScore RL 等基線,方便直接比較
  • 單次生成保留低延遲,同時補足 attributes、counts、textures、materials、spatial relations
  • 提供方法分目錄、資料與 checkpoint 說明,但大型資料與模型檔案未隨儲存庫附上

研究、內容理解、影像搜尋標註,甚至要為電商圖片或視覺資產建立更細緻描述的團隊,都會較容易受益。安裝與執行入口在儲存庫內有 setup 與各方法,但目前公開資訊主要指向研究復現流程;想完整重跑訓練或延遲基準,仍要另外處理資料集、checkpoint 同對應運行環境。

項目主頁 · GitHub

Categories: 開源, Embedding, 視覺模型, 多模態模型, Qwen, Gemini, Image

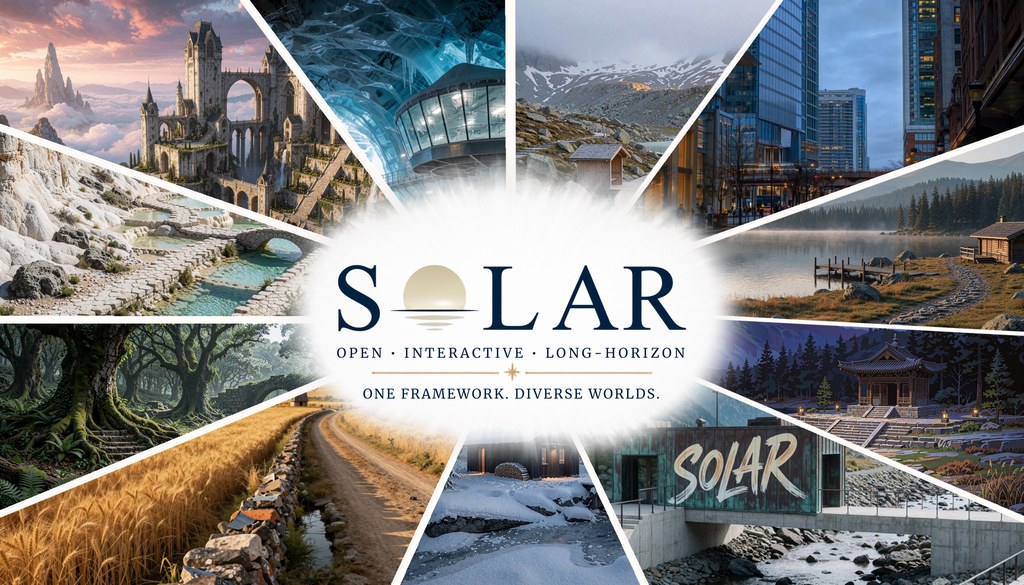
SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

AREX-Skill 把 GitHub 知識變成可執行技能

AREX-Skill 將熱門 GitHub 儲存庫整理成可驗證、可執行的技能,讓 Coding Agent 在複雜機器學習研究任務中少走彎路。

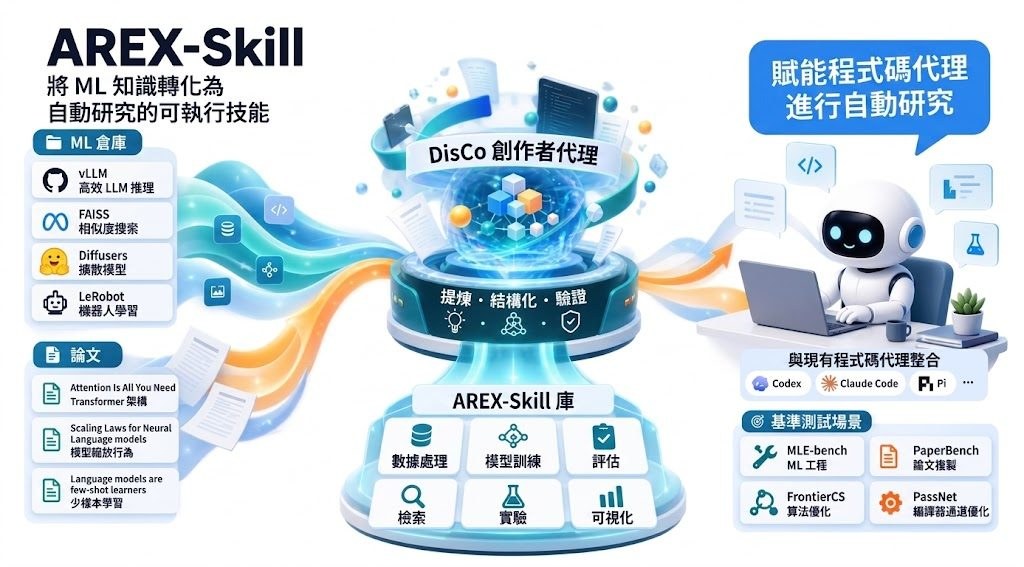
AREX-Skill turns repository and paper knowledge into executable skills for coding agents and autonomous ML research

面對需要查閱多個儲存庫、重現研究流程和逐步驗證結果的工作,AREX-Skill 將分散在 GitHub 的操作知識整理成可重用程序、檢查方法和技能圖譜。它屬於面向 Coding Agent 的開源技能庫與工作流工具,實際處理的是代理有模型能力卻欠缺項目脈絡和操作經驗的問題。

AREX-Skill 已從 1,000 多個熱門機器學習儲存庫提煉超過 5,000 個經驗證、可執行的 skills,並可整合 Codex、Claude Code、Pi 等 Coding Agent。使用時可按任務由 router 從技能庫收窄至相關分支,再由代理執行;DisCo 則負責將儲存庫知識建立、驗證和匯出成技能。

  • 技能包含程序與檢查,而不只是文字說明
  • 技能圖譜協助代理處理跨學科機器學習研究
  • DisCo Meta Skills 支援挑選及使用 Creator meta skills
  • Refreshing Repo Skills 提供維護和更新清單

相較於每次由代理重新閱讀 README、程式碼和論文,技能化做法可把重複的操作步驟預先整理,並將預算集中到較困難的推理工作;代價是技能需要隨儲存庫更新而刷新,覆蓋範圍和驗證品質亦會直接影響結果。儲存庫目前提供 Demo、技能目錄、repository catalog 及 DisCo CLI 文件,適合研究團隊、Coding Agent 使用者,以及需要重現多個 ML 項目的開發者。

GitHub

Categories: 開源, Agentic, Vibe Coding, 編程, Anthropic, Dataset 數據集, Skill 技能

FastH3 Live:單張消費級 GPU 跑出無限 AI 直播

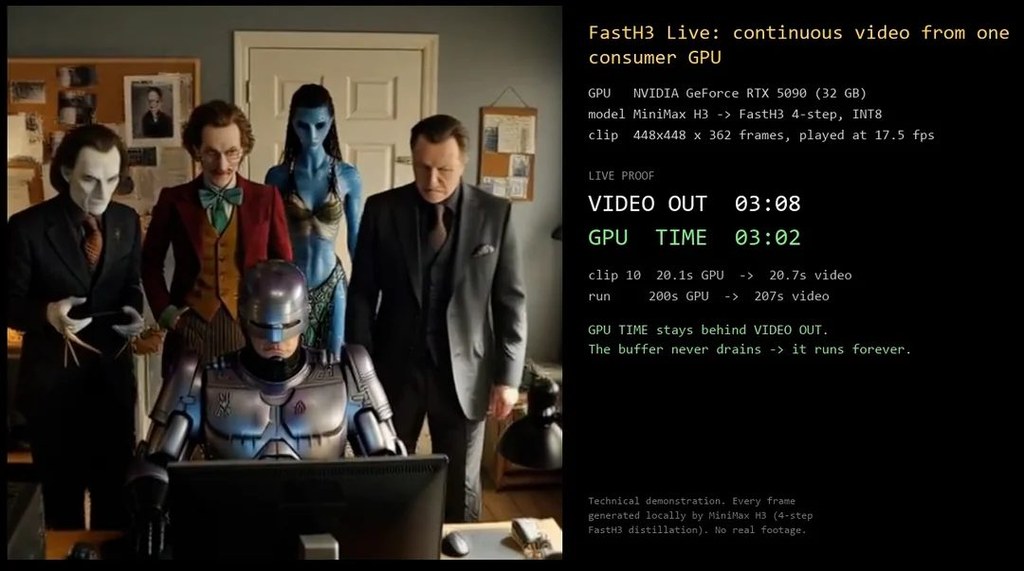
FastH3 Live 將 MiniMax-H3 蒸餾成 4 步模型,配合重定時與 ComfyUI 串流伺服器,用一張 RTX 5090 就能長開 448×448 18fps 嘅無限影片加音訊直播。

Hero image preview

喺消費級硬件上長開一段無止境嘅 AI 影片頻道,一直係文字轉視頻工作流嘅痛點——雲端成本高、本地生成速度慢,仲要面對提示詞同角色一致性嘅限制。FastH3 Live 就係圍繞呢個矛盾設計:佢將 MiniMax-H3 經過 4 步 DMD2 蒸餾成 FastH3,配合一套本地串流伺服器,令生成同播放可以同步進行,前一段影片播放期間,模型已經喺度產出下一段。

整個項目以 ComfyUI 作為運行環境,並喺單張 RTX 5090(32GB、Windows 11)上完成測試。v1.1.0 版本將解析度提升至 448×448、幀率達到 18fps,相比 v1.0.0 嘅 512×288 12fps 有明顯進步。音訊部分亦同步串流,用戶只要用 VLC 指向本地 URL,就可以一直接收新嘅短片,支援多位觀眾同時連線同斷線重連。

對於內容創作者、ComfyUI 用戶或者想試文字轉視頻嘅人來說,呢套工具最直接嘅吸引力係「無限直播」呢個使用場景。項目內附 321 個場景提示詞、503 個已驗證可用嘅角色清單,使用時可以快速組合出唔同長度嘅段落,唔需要每次由零開始寫 prompt。

需要注意嘅限制亦都幾清楚:相關權重屬於 MiniMax-H3 社群授權,適用範圍排除歐盟、英國、韓國同美國,下載前需要確認所在地。

項目主頁 · 數據集

Categories: 開源, ComfyUI, Agentic, 視頻模型, Video, Dataset 數據集, MiniMax

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

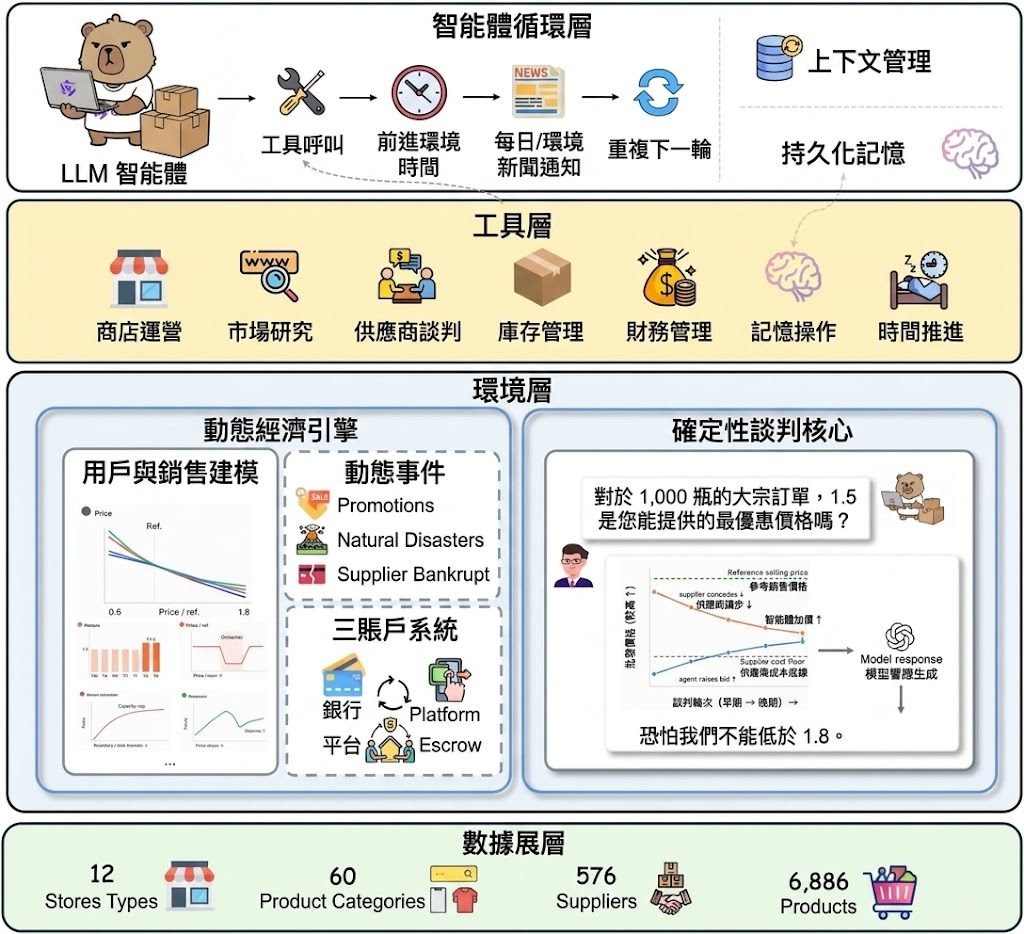
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

Page 8 of 92
1 6 7 8 9 10 92