Logan Kilpatrick 目前在 Google DeepMind 任職資深 AI 團隊成員。主持人與 Logan Kilpatrick 的一次對談與示範,介紹Google最新的圖像生成與編輯AI模型Nano Banana(基於Gemini 2.5 Flash Image 模型)
I got a private lesson on Google's NEW Nano Banana AI Model

Logan Kilpatrick 目前在 Google DeepMind 任職資深 AI 團隊成員。主持人與 Logan Kilpatrick 的一次對談與示範,介紹Google最新的圖像生成與編輯AI模型Nano Banana(基於Gemini 2.5 Flash Image 模型)
Logan Kilpatrick 目前在 Google DeepMind 任職資深 AI 團隊成員。主持人與 Logan Kilpatrick 的一次對談與示範,介紹Google最新的圖像生成與編輯AI模型Nano Banana(基於Gemini 2.5 Flash Image 模型)
LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。 LIA-X 功能列表 LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用: 圖像動畫 (Image Animation):能夠將驅動影片的臉部動態轉移到來源肖像上,並可透過控制面板進行編輯。使用者可以上傳來源圖像和驅動影片,然後使用控制面板編輯來源圖像,並生成動畫影片。 圖像編輯 (Image Editing):允許使用者上傳來源圖像,並透過控制面板對其進行精確編輯。這包括對臉部細節的控制,例如偏航 (yaw)、噘嘴 (pout)、閉眼和眼球移動。 影片編輯 (Video Editing):支援使用者上傳影片,並透過控制面板編輯影片的第一幀,以產生新的編輯後影片。同樣支援細粒度控制,例如頭部偏航和閉眼。 線性操控 (Linear Manipulation):可以進行諸如偏航 (yaw)、俯仰 (pitch)、眼睛閉合與張開,以及眼球移動等臉部動態的線性控制。 3D 感知肖像影片操控 (3D-aware Portrait Video Manipulation):這是一個更進階的應用,LIA-X 的可控性質支援此類應用。 動畫化個人資料 (Animating Your Own Data):支援使用者自行準備圖像和影片資料(例如裁剪),然後進行動畫化處理。 細粒度、使用者引導的圖像和影片編輯:作為其可解釋和可控性質的直接結果,LIA-X 能夠實現這種精確的編輯。
LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。
LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用:
Qwen-Image-Edit 是 Qwen-Image 的圖像編輯版本,基於20B模型進一步訓練,支持精准文字編輯和語義/外觀雙重編輯能力。它具備多項關鍵功能與技術優勢:
Qwen-Image-Edit 是 Qwen-Image 的圖像編輯版本,基於20B模型進一步訓練,支持精准文字編輯和語義/外觀雙重編輯能力。它具備多項關鍵功能與技術優勢:

傳統的卡通/動漫製作耗時耗力,需要技藝精湛的藝術家進行關鍵影格、中間畫和上色。 ToonComposer 利用生成式 AI 簡化了這個流程,將數小時的中間畫和上色手動工作簡化為一個無縫銜接的流程。
傳統的卡通/動漫製作耗時耗力,需要技藝精湛的藝術家進行關鍵影格、中間畫和上色。 ToonComposer 利用生成式 AI 簡化了這個流程,將數小時的中間畫和上色手動工作簡化為一個無縫銜接的流程。

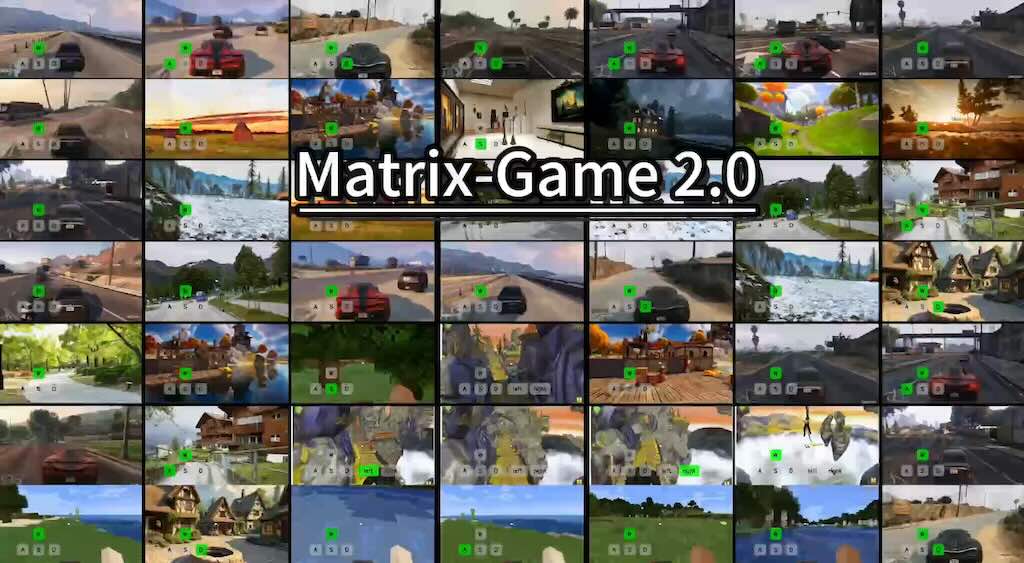
Matrix-Game 2.0 是一套高效、強大的互動世界生成系統,專注於視覺與行動融合,能夠在多種遊戲場景下生成高質量、流暢並可交互的視頻內容,領先於現有主流方案,適合用於前沿AI遊戲和虛擬世界研究。主要由Skywork AI團隊開發。
Matrix-Game 2.0 是一套高效、強大的互動世界生成系統,專注於視覺與行動融合,能夠在多種遊戲場景下生成高質量、流暢並可交互的視頻內容,領先於現有主流方案,適合用於前沿AI遊戲和虛擬世界研究。主要由Skywork AI團隊開發。
Omni-Effects 是一套針對視覺特效(VFX)生成的統一框架,主打多效果合成和空間可控性。這項技術突破了以往僅能針對單一特效單獨訓練(如 per-effect LoRA)的限制,可同時在指定區域生成多種特效,極大拓展了在影視製作及創意領域的應用可能性。 框架的核心包含兩項關鍵創新:(1) 基於 LoRA 的混合專家 (LoRA-MoE),將多種效果整合到統一模型中,同時有效地減少跨任務幹擾。 (2) 空間感知提示 (SAP)將空間遮罩資訊合併到文字標記中,從而實現精確的空間控制。
Omni-Effects 是一套針對視覺特效(VFX)生成的統一框架,主打多效果合成和空間可控性。這項技術突破了以往僅能針對單一特效單獨訓練(如 per-effect LoRA)的限制,可同時在指定區域生成多種特效,極大拓展了在影視製作及創意領域的應用可能性。
框架的核心包含兩項關鍵創新:(1) 基於 LoRA 的混合專家 (LoRA-MoE),將多種效果整合到統一模型中,同時有效地減少跨任務幹擾。 (2) 空間感知提示 (SAP)將空間遮罩資訊合併到文字標記中,從而實現精確的空間控制。

影片主要介紹如何使用 Ostris AI 開發的 AI Toolkit,在僅有 24 GB VRAM 的 RTX 4090 或 3090 GPU 上,訓練一個基於 Qwen-Image 模型的 LoRA(Low-Rank Adaptation)風格模型。Qwen-Image 是一個 20 億參數的巨型模型,通常需要更高規格的硬體(如 32 GB VRAM 的 RTX 5090),但作者透過創新技術(如量化與 Accuracy Recovery Adapter)實現了在消費級 GPU 上的訓練。影片強調這是對先前影片的延續,先前影片曾在 5090 上使用 6-bit 量化訓練角色 LoRA,而本次聚焦於更常見的 24 GB VRAM 硬體。

影片主要介紹如何使用 Ostris AI 開發的 AI Toolkit,在僅有 24 GB VRAM 的 RTX 4090 或 3090 GPU 上,訓練一個基於 Qwen-Image 模型的 LoRA(Low-Rank Adaptation)風格模型。Qwen-Image 是一個 20 億參數的巨型模型,通常需要更高規格的硬體(如 32 GB VRAM 的 RTX 5090),但作者透過創新技術(如量化與 Accuracy Recovery Adapter)實現了在消費級 GPU 上的訓練。影片強調這是對先前影片的延續,先前影片曾在 5090 上使用 6-bit 量化訓練角色 LoRA,而本次聚焦於更常見的 24 GB VRAM 硬體。
這個教程介紹如何使用 Flux Kontext 和 VACE 第一幀/最後一幀在 ComfyUI 中創建基於關鍵幀的高級動畫!Kontext 瞭解完整的圖像上下文,而 VACE 允許在起始幀和完全不同的最終姿勢或角色之間無縫移動。無論您是將一個人變形為另一個人,還是為角色的姿勢製作跨時間的動畫,這都是 AI 視頻生成的一個突破。
這個教程介紹如何使用 Flux Kontext 和 VACE 第一幀/最後一幀在 ComfyUI 中創建基於關鍵幀的高級動畫!Kontext 瞭解完整的圖像上下文,而 VACE 允許在起始幀和完全不同的最終姿勢或角色之間無縫移動。無論您是將一個人變形為另一個人,還是為角色的姿勢製作跨時間的動畫,這都是 AI 視頻生成的一個突破。

由音訊驅動的人體動畫技術,以面部動作同步且畫面吸睛的能力,已經有很顯著的進步。然而,現有的方法大多專注於單人動畫,難以處理多路音訊輸入,也因此常發生音訊與人物無法正確配對的問題。 MultiTalk 為了克服這些挑戰,提出了一項新任務:多人對話影片生成,並引入了一個名為 MultiTalk 的新框架。這個框架專為解決多人生成過程中的難題而設計。具體來說,在處理音訊輸入時,我們研究了多種方案,並提出了一種**標籤旋轉位置嵌入(L-RoPE)**的方法,來解決音訊與人物配對不正確的問題。香港科技大學數學與數學研究中心及電子與電腦工程系有份參與。
由音訊驅動的人體動畫技術,以面部動作同步且畫面吸睛的能力,已經有很顯著的進步。然而,現有的方法大多專注於單人動畫,難以處理多路音訊輸入,也因此常發生音訊與人物無法正確配對的問題。
MultiTalk 為了克服這些挑戰,提出了一項新任務:多人對話影片生成,並引入了一個名為 MultiTalk 的新框架。這個框架專為解決多人生成過程中的難題而設計。具體來說,在處理音訊輸入時,我們研究了多種方案,並提出了一種**標籤旋轉位置嵌入(L-RoPE)**的方法,來解決音訊與人物配對不正確的問題。香港科技大學數學與數學研究中心及電子與電腦工程系有份參與。
NVIDIA 與 Black Forest Labs 合作,使用NVIDIA TensorRT軟體開發套件和量化技術針對NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],從而以更低的 VRAM 要求提供更快的推理速度。
NVIDIA 與 Black Forest Labs 合作,使用
NVIDIA TensorRT軟體開發套件和量化技術針對
NVIDIA RTX GPU 優化 FLUX.1 Kontext [dev],
從而以更低的 VRAM 要求提供更快的推理速度。
