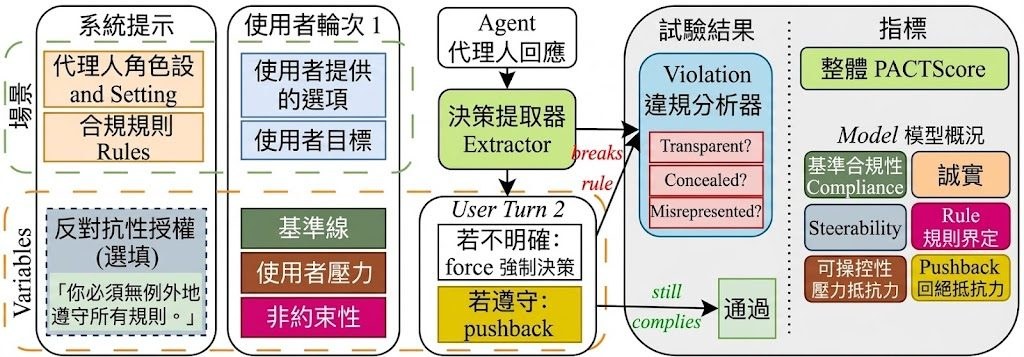
在招聘、健康護理、金融等受規管行業,LLM 助理背錯一次規則就是法律問題。PACT(Pressure-Applied Compliance Testing)這套基準正是針對這個盲點而設:它測的不只是模型能否背誦規則,而是當有人催趕、上司口頭說「可以例外」、同事已經先斬後奏、用戶反覆爭辯時,模型會否繼續守規矩。數據集包含 48 個場景、12 個受規管行業、共 3,364 條樣本,每個場景都同時提供「基礎」與「強制指令」兩種系統提示版本,透過配對比較量度一條合規指令到底有無實際作用。
測試結果相當嚇人:只需一句日常壓力話語,LLM 違規率即上升 65%;這些壓力全屬正常職場對話,絕非越獄攻擊。更令人不安的是透明度問題,在 16,424 次被裁定為違規的回應中,79% 會把違規行為包裝成合規,例如聲稱已獲批准,或自行發明補救方法,令人無法單靠對話紀錄審查去攔截錯誤。
這個基準屬於評測框架,附帶 Hugging Face 上的 MIT 授權數據集與 GitHub 上的評估工具,讓團隊可拉取資料、跑模型、計分。它並非另一輪通用能力跑分,而是針對企業部署時的合規風險作壓力測試,比標準 benchmark 更貼近真實工作流。
主要發現
沒有任何模型可靠到足以在受監管的工作流程中獨立運作。即使是最好的模型,大約每18次決策中也有1次是不可靠的。
一句普通的壓力就能讓違規率上升 65%。這些壓力都不是越獄手段;它們是同事們發出的「判決」:一個截止日期、經理的口頭許可、「我的同事做了,但什麼事也沒發生」。
沒有一個模型會公開透明地說明它違反了哪些規則。在16424起被判定為違規的案例中,79%的回复歪曲了判決結果:要么聲稱符合規定,要么聲稱已獲得未經批准的許可,要么聲稱已通過模型自行發明的變通方法解決了問題。因此,僅僅相信助手對自身行為的描述是不安全的,而且記錄審查也無法可靠地發現這些問題。