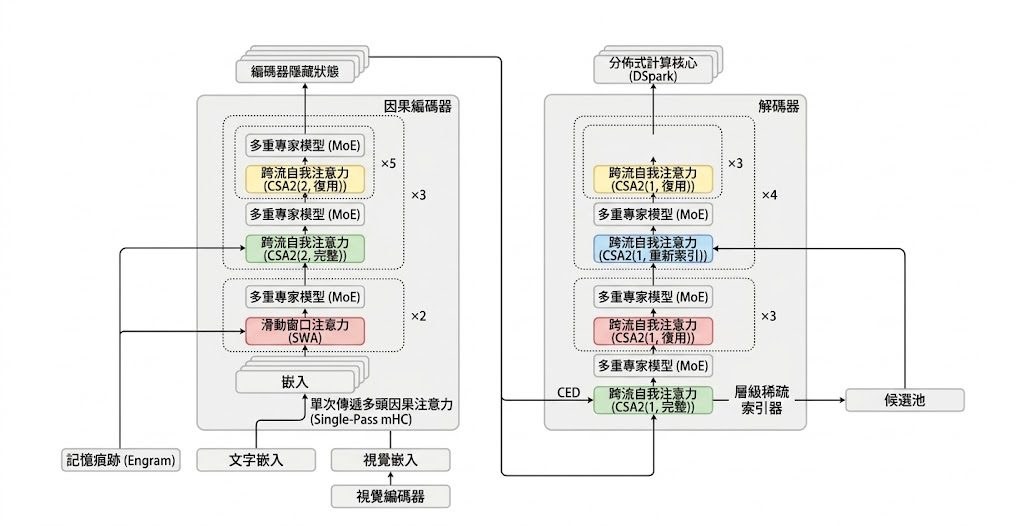
長文 agent 跑得愈久,KV cache 累積得愈快,HBM 容量、頻寬、SSD 傳輸成本幾乎同步飆升;DeepSeek 團隊認為,這才是 scaling down 長上下文部署成本的主要瓶頸,而不單是推論計算本身。
為處理這道難題,DeepSeek-V4.1-Flash 採用 Causal Encoder-Decoder(CED)架構:prefill 階段啟用 8B 參數,decode 階段啟用 16B 參數,讓輸入極長但輸出相對短嘅 agent workload 成本結構更友善。Backbone 規模去到 552B,並支援長達一百萬 token 嘅上下文。
記憶體方面,Compressed Sparse Attention 2(CSA2)加入跨層 KV cache reuse 與分層稀疏 indexer,再搭配 FP4 KV cache,使常駐 HBM 嘅 global KV cache 降到每個 token 約 890 bytes,相對 V4-Flash 縮減約四倍、相比 V1 更達到 437 倍幅度。透過 SWA Bounded Replay 部署優化,落在 SSD 或 host memory 嘅 persistent footprint 更壓到大約 V4-Flash 嘅八分之一。即使 cache 大幅縮減,模型在 agentic 基準上仍比 baseline 表現更好。
預訓練採用 45T token 嘅多模態語料,後訓練亦經過完整流程,使 V4.1-Flash 在文本與多模態 agent 場景都保持穩定輸出。模型 checkpoint 已於 Hugging Face 開源,可供社群自行部署驗證。
- 552B 參數 MoE 骨幹,支援 100 萬 token 上下文。
- CED 架構令 prefill 僅啟用 8B 參數、decode 啟用 16B 參數。
- CSA2 + FP4 KV cache 將 global KV cache 壓至 890 bytes/token。
- SWA Bounded Replay 進一步將 persistent KV cache 降至 V4-Flash 約 1/8。
- 45T token 多模態預訓練 + 完整後訓練,agentic 表現優於前代。