Kimi K3.1 Pro:開放權重 1M 上下文支援長鏈路代理

完整 model weights 預定於 11 月 4 日釋出。1M-token 上下文支援編程與長鏈路代理,Kimi K3.1 Pro 亦延伸至 3D 創作及金融研究。

Og image

面對超長文件、終端機任務和多步驟研究,Kimi K3.1 Pro 以 1M-token context window 支援長鏈路代理工作,並把 coding、3D creation 與 financial research 放進 3T-class open-weight model。它是 Kimi K3 的 post-trained 版本。

訓練加入更大 post-training compute,在數百個下游領域進行 joint reinforcement learning(joint RL);RL framework、long-context inference、sandbox infrastructure 及 rollout scheduling 亦一併優化,目標是令能力提升更穩定。

  • 長上下文:1M-token context window,適合長文件及多步驟工作。
  • 代理場景:涵蓋 coding、3D creation 及 financial research。
  • 速度選項:Kimi K3.1 Pro Highspeed 標稱快 2 至 3 倍。
  • 權重安排:完整 model weights 預定於 11 月 4 日釋出。

Terminal-Bench 4.0 以資源受限終端機任務和嚴格測試評估 coding agents;K3.1 Pro 得分 65.7%,高於 GPT-6 Astra 的 58.2%,接近 Claude Opus 5.5 的 66.4%,可作為編程代理場景的參考。

模型可於 Kimi Work、Kimi Code 及 Kimi API 使用。
項目主頁

Categories: Agentic, 模型, 模型訓練, API, Image, 框架, Vibe Coding, 3D, Python, 編程, Anthropic, Kimi, 任何模型, 強化學習

AI Toolkit 把擴散模型訓練搬上消費級硬件

將多種新式圖像與影片模型放入同一套訓練工具,兼顧 GUI、CLI 與本地環境管理。

AI Toolkit UI

想在家用硬件微調 FLUX、Qwen-Image 等模型,過往往往要自行處理環境、依賴與介面;Ostris AI Toolkit 把這些繁複步驟整合成一套擴散模型訓練工具。官方資料未提供完整安裝指令,但建議透過儲存庫內建的 AI Toolkit Manager 啟動。

AI Toolkit Manager 會偵測硬件並配置合適的 PyTorch 版本、建立 Python 環境,以及下載 Node.js 和 FFmpeg,所有檔案留在 ai-toolkit 資料夾內,不會系統級安裝。啟動時亦會檢查更新;若本機檔案經修改,更新會跳過並發出警告,減少覆蓋自訂設定的風險。

它屬於開源訓練套件,可透過 GUI 或 CLI 操作,涵蓋圖像及影片模型訓練。模型支援範圍頗廣,包括 FLUX.1、FLUX.2、FLUX.2-klein 4B/9B、Lumina-Image-2.0、Qwen-Image-2512、SDXL,以及 Chroma、HiDream、OmniGen2、Z-Image、ERNIE-Image 等新式架構。

  • 以消費級硬件為主要目標,縮低本機訓練門檻
  • 同一套工具支援多種新舊擴散模型
  • GUI 與 CLI 並存,兼顧互動操作及批次流程
  • 依賴與模型資源集中管理,減少系統污染
  • 保留本機修改,並在更新衝突時給出警告

相較只針對單一模型或只提供訓練腳本的做法,AI Toolkit 的優勢是將模型選擇、環境配置與操作介面放進同一工作流。不過,原始資料沒有交代各模型的訓練速度、記憶體需求或量化設定,硬件是否足夠仍要視模型大小與訓練配置而定。

這套工具較適合需要建立角色、產品或風格資料的設計團隊、內容創作者,以及想在本地微調開源模型的開發者。模型及環境檔案仍佔用大量磁碟空間,影片模型亦可能帶來更高記憶體與運算負擔,部署前宜先核對個別模型的條件。

GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Stable Diffusion, Video, Image, 工具, Content Creator, Python, 庫, 百度

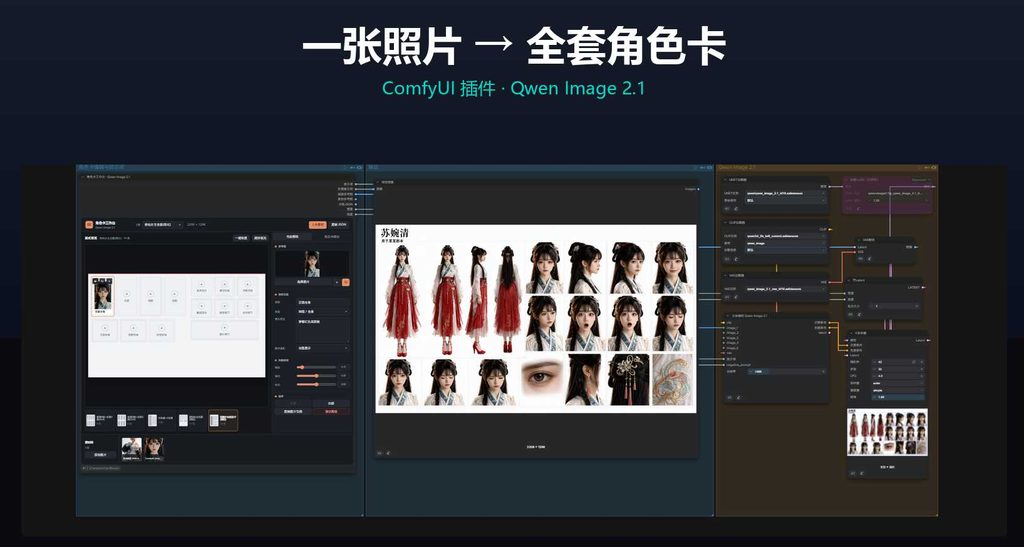
ComfyUI-CharacterCardStudio:Qwen-Image 2.1 角色多視圖自動排版

將角色圖、提示詞與場景圖交給 ComfyUI 插件,自動生成多視圖、表情及細節,再精準拼成設定卡。

手工製作角色設定卡最費時的,往往不是生成單張圖,而是補齊正反面、表情、動作,再逐格貼圖兼避免裁走頭腳。JGRFW/ComfyUI-CharacterCardStudio 屬於 ComfyUI 圖像生成插件,針對 Qwen-Image 2.1 將多視圖生成、切片、排序同排版整合成工作流程。

  • 支援角色參考圖及純提示詞兩種生成入口
  • 提供 8 套角色卡版與 1 套 360° 場景卡版
  • 自動切片、重排,並預設完整顯示全身
  • 可分項生成多視圖、動作、表情與細節
  • 右側面自動鏡像,統一由模板決定位置

安裝方式是把儲存庫資料夾放入 ComfyUI 的 custom_nodes 目錄,再重啟 ComfyUI;README 同時提供圖生卡、文生卡、純提示詞及場景補面的工作流。模型選擇方面,插件使用 Qwen-Image 2.1 的 UNET、CLIP 與 VAE,亦為記憶體較緊的環境列出 int8 模型選項,但實際仍需自行準備相應檔案。

插件最實際的價值在排版,而非提升 Qwen-Image 2.1 本身的生成能力。切片節點可讀取模板資料,按 panel_order 將格子重新排列,fit mode 預設保留頭頂至鞋底;場景卡則以一張圖為錨點,補充 0°、90°、180°、270° 環視、360° 全景及環境細節。右側面會自動水平翻轉,減少模型未能準確理解左右方向造成的版面問題。

一次生成整卡仍然受模型隨機性影響,角色姿勢、表情或物件位置未必逐格穩定。對需要固定構圖的團隊,逐格生成及排版流程會較可靠;工作台亦可逐格替換素材及微調裁切。README 未提供量化評測,因此較適合 ComfyUI 創作者、遊戲角色設計師同視覺內容團隊,以工作流方式驗證產出質素。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Image, 提示詞, Content Creator, 庫

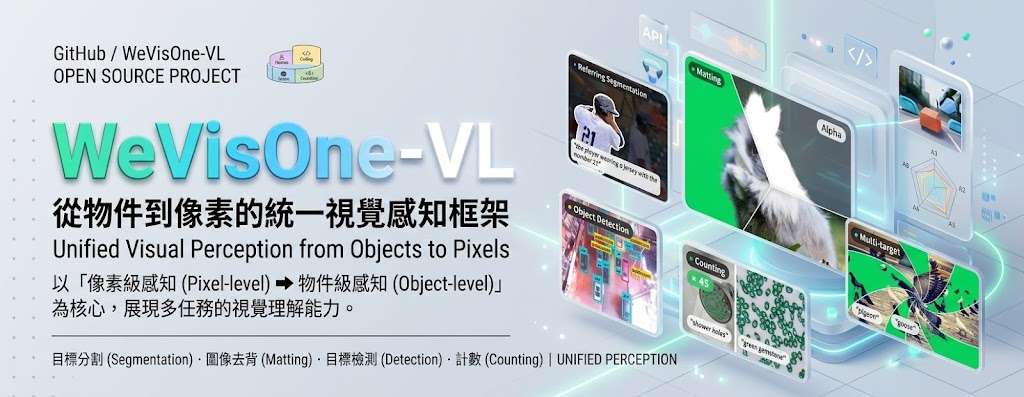
WeVisOne-VL 整合多種視覺任務

由座標定位延伸至遮罩與透明度摳圖,WeVisOne-VL 把多種視覺任務整合在一個模型,並以輕量解碼器處理像素輸出。

WeChat Vision

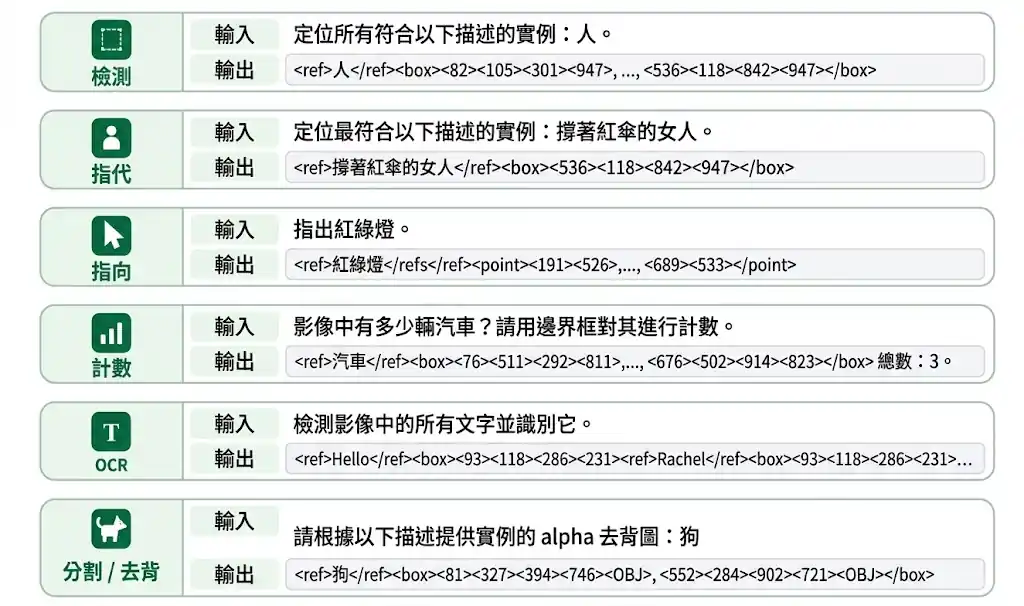
要在一張圖中找出物件、讀取文字,再按需要輸出座標、遮罩或透明度邊緣,WeVisOne-VL 把物件層級與像素層級工作整合為視覺語言模型(Vision-Language Model,VLM),適合標註及影像檢查流程。

模型建基於 Qwen3-VL,以 structured next-token prediction 生成定位結果:座標 token 表示點與框, token 則觸發像素解碼器。解碼器只有 9.6M 參數,重用 Vision Transformer(ViT)特徵,不需 Segment Anything Model(SAM)或外置分割骨幹,可輸出二值遮罩與連續 alpha matte。

任務涵蓋物件偵測、指稱定位、計數、指點、光學字元辨識(Optical Character Recognition,OCR)、指稱分割及 promptable alpha matting;找不到指定目標時會回傳 None,減少虛構定位。需要在同一流程處理定位、分割與前景摳圖的團隊,可評估它是否適合自身資料和任務。

  • 提供 2B、4B 模型權重、推理套件、Cookbooks、Gradio 示範及評測流程。
  • 微調程式碼尚未提供;資料亦未列出硬件需求或逐步安裝方式。
  • 項目在 30 多項基準測試領先。

項目主頁 · GitHub

Categories: 開源, 騰訊, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Image, Medical醫學

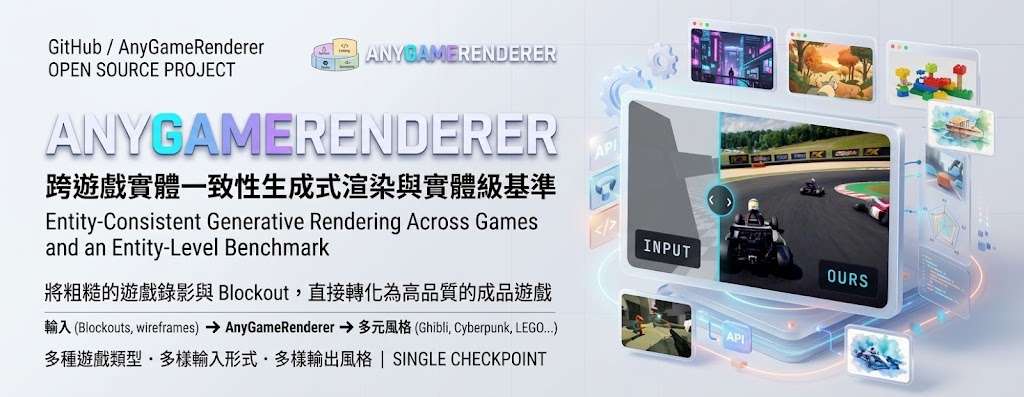
AnyGameRenderer 把粗糙遊戲錄影變成可玩風格畫面

由灰色方塊與代理色組成的遊戲錄影,配合文字提示即可重繪成不同風格,同時保留角色、物件數量與動作時間。

genre trenchfire

遊戲原型仍是灰色方塊、彩色幾何體,AnyGameRenderer 就能把一段 24 fps、2 至 15 秒的普通影片,重繪成 AAA 寫實、LEGO、Ghibli、蠟筆或 synthwave 等風格。它屬於生成式影片模型,處理的是「畫面變漂亮後,角色位置、數量和出現時間仍要對得上」的問題。

輸入不需要逐物件標籤、引擎掛鈎或固定遊戲引擎格式,wireframe、semantic map、粗略 3D mockup、彩色 primitive 和 engine whitebox 都可作為來源。單一 checkpoint 已涵蓋 tower defense、kart racing、shooters、survivors-like 和回合制戰鬥等類型,適合 AI 遊戲生成工具、原型展示和美術風格探索。

  • 保留 entity correspondence,細小及遠距離物件較不容易消失
  • 文字提示可改變整體美術風格,同一段輸入可產生多種世界觀
  • 以 entity-level benchmark 評估,而非只看逐幀畫面相似度
  • LoRA 訓練尺寸為 1344×768、124 frames;更長影片可執行,但未按該長度訓練

59 個測試案例、753 個 ground-truth entities 中,temporal match 由 zero-shot base 的 50.9% 升至 62.9%,position match 由 57.1% 升至 61.9%;未渲染率由 4.1% 降至 2.9%,hallucination rate 由 52.1% 降至 46.0%。提升仍未代表每個物件都能穩定對齊,長片段和高密度場景仍需檢查輸出。

需要 Python 3.10、PyTorch 2.9.1+cu128 等環境資訊,以及 setup_env.sh 和權重下載流程;完整執行仍需要相應 GPU 環境。項目同時公開模型與資料集連結,較適合希望把可玩原型快速轉成視覺樣片的開發者和研究團隊。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Video, 工具, 3D, Python, 編程, Dataset 數據集, LoRA

RouteWeaver:先選工作方式,再決定呼叫哪些模型

同一個問題未必適合只問一次、逐步追問或交由多個角色協作。RouteWeaver 把「如何組織模型呼叫」也交給路由策略判斷,並以成本回饋約束選擇。

RouteWeaver logo

遇上簡單查詢,多輪推理可能徒增成本;碰到程式或需要拆解的任務,只呼叫一次模型又可能不夠。RouteWeaver 是一個大型語言模型路由框架,讓單一策略先選擇單輪、多輪或 agentic 執行模式,再安排工作模型處理子問題,嘗試同時照顧答案品質與呼叫成本。

路由策略採用 Qwen3-4B-Instruct-2507,並在六個凍結的工作模型之間分配任務。所有模式共用一套行動格式:單輪只呼叫一次;多輪會按前一次觀察結果作出兩至四次連續呼叫;agentic 模式則可在最多八次呼叫中,以角色和參照關係組織多層協作。工作模型的輸出只作為策略的上下文,不會直接接受梯度更新。

訓練方法 COMET-GRPO(COordinated Mode–Execution Training)分開比較模式選擇和模式內執行,避免只看整段任務的獎勵時,難以判斷失誤源於選錯模式,還是執行不佳。漸進式探索會先由外部指定模式,待各模式累積執行經驗後,才逐步交由策略自行選擇;另一項獎勵則把成本納入考量,令路由器不只追求答案表現。

這套做法適合需要按任務難度調整模型呼叫流程的研究團隊,以及同時處理查詢、數學、程式和知識任務的服務。單輪模式可減少簡單工作的額外呼叫;多輪及 agentic 模式則提供分步推理或角色協作空間。代價是增加了路由策略與執行流程的訓練、協調複雜度,而成本獎勵也不能單獨保證每個任務都會選到最合適模式。

  • 一個策略同時決定執行模式及工作模型路由。
  • 六個工作模型保持凍結,策略負責編排呼叫與整理答案。
  • COMET-GRPO 分開給模式決策和模式內執行評分。
  • 成本獎勵與漸進式探索,分別處理資源取捨及模式探索。

程式碼、訓練後的路由器及項目頁已公開;提供模型與資料入口。先理解方法及評估設定,再按公開程式與模型資料判斷是否符合自己的任務。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架

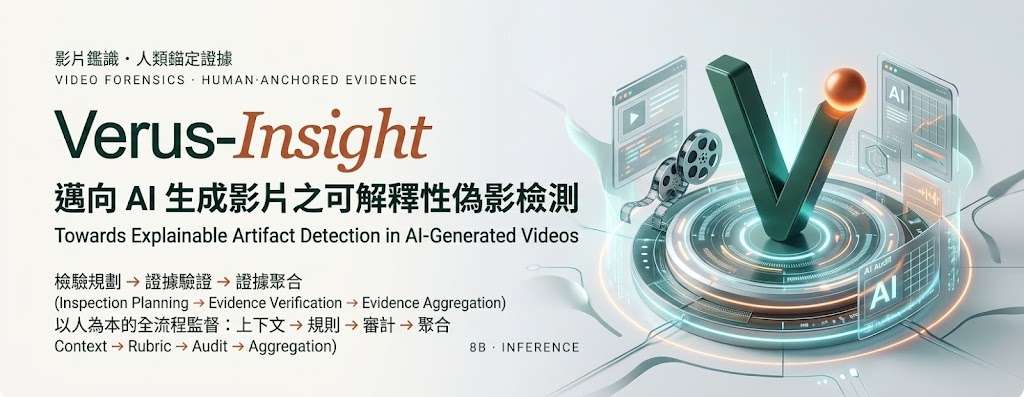
Verus-Insight 分析可見瑕疵:影片真假判斷有跡可尋

Verus-Insight 不只判斷影片是真還是假,亦會逐步規劃檢查項目、核實畫面證據,再整理成結構化結論。這套開源模型適合研究影片偽造分析及可解釋檢測的團隊評估。

Verus-Insight — Towards Explainable Artifact Detection in AI-Generated Videos

檢查 AI 生成影片時,單有真假標籤未必足以說明判斷依據。Verus-Insight 是一個影片瑕疵檢測模型,會按影片內容制定檢查準則、核實畫面中是否看得到相關瑕疵,再把觀察結果整合成真假判斷,讓分析不只停留在分類結果。

模型建基於 Qwen3-VL-8B-Instruct,採用「檢查規劃、證據核實、證據整合」流程。訓練方法以人工標註作錨點,涵蓋 Context → Rubric → Audit → Aggregation;這套流程旨在讓模型按影片內容提出檢查項目,並以可見證據支持結論。程式庫提供的是推理版本,並非可直接執行的訓練套件。

Verus-Bench 包含 192 段真實及 AI 生成影片,各佔 96 段,另有 320 項人工標註瑕疵,分屬 17 個類別。資料集可用來檢視模型能否找出細節瑕疵,但目前提供的資訊沒有列出具體評測分數,因此不宜據此判斷它比其他模型準確多少。

程式庫支援 Transformers、vLLM 推理,亦提供影片、圖片或影格序列輸入,以及批次推理與結果續跑功能。使用者可按文件準備 Linux、CUDA 環境並下載模型;Transformers 測試配置使用一張 H100 80GB GPU,但這只是已驗證配置,並非最低硬件要求。程式庫沒有提供訓練指令或訓練配方。

  • 適合研究影片偽造、視覺瑕疵分析及可解釋檢測的團隊。
  • 可由單一輸入測試,也可批次處理已整理的資料清單。
  • Verus-Bench 提供人工標註,方便檢視瑕疵定位與影片層級判斷。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Video, Image, Linux, 庫, Dataset 數據集

從影片理解世界:統一 Video World Models 的四種能力

一份涵蓋 669 篇參考文獻的調查,整理影片模型如何讀取、生成、共享及互動於不斷變化的世界。

Og image

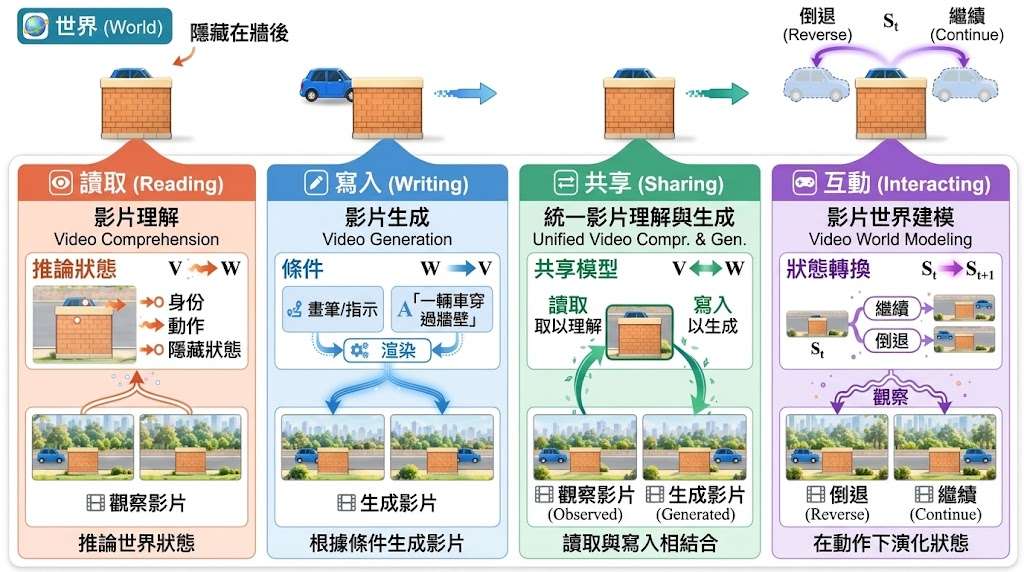
當模型要由片段影片理解場景、推演未來,甚至回應外部行動時,單純辨認畫面中的物件並不足夠。這份影片世界模型調查以影片與世界狀態的關係為主線,整理 Video Foundation Models 如何處理觀察不完整、時間變化和因果推理等問題。

調查將能力分成四個互相關聯的操作:Reading 從影片讀取語意、空間、時間、物理及因果資訊;Writing 生成可能發生的未來;Sharing 建立可供不同任務共用的表示;Interacting 則把感知結果連接到行動、控制和環境回應。內容涵蓋影片表示學習、Video-LLMs、影片生成、影片代理及世界預測等方向。

影片只是世界的部分記錄,而且可能遺失被遮擋的物件、視角以外的資訊或事件之間的因果關係。調查因此區分 temporal coherence 與 world consistency:畫面可以連續流暢,但物件再次出現時未必保持同一身份;鏡頭突然切換,也不一定代表世界狀態中斷。

• 以世界狀態統一影片理解與生成
• 覆蓋 2017 至 2026 年的研究發展時間線
• 比較 contrastive、masked、predictive 及 generative learning
• 關注長片段、串流觀察與影片代理的證據累積
• 收錄 669 篇參考文獻及多個尚待解決的研究問題

這份材料適合研究影片模型、World Models、多模態模型和 Computer-use agents 的讀者,也可作為設計影片理解、未來預測、模擬環境或機械人互動工作流時的索引。它屬於調查項目,並非可直接下載或安裝的單一模型;原始資料亦沒有提供具體使用流程。

項目主頁

Categories: Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Discord, 動畫

LaLa-World 用自然語言連接機械人規劃

以文字描述動作,模型便可從模擬、機械人、圖片和影片學習並預測未來畫面,讓規劃不必為每個任務各自訓練世界模型。

NAVER AI Lab

只用文字描述動作,就能讓同一個世界模型從模擬、機械人、圖片和影片學習,並預測行動後的視覺變化。LaLa-World 是語言條件式潛在世界模型,目標是減少不同領域各自訓練模型的需要,支援跨場景規劃;它亦可微調成 LaLa-Policy,同時預測機械人動作和未來表徵。

關鍵做法是把自然語言當成共通的動作介面,再於潛在空間預測未來視覺表徵,而不是直接生成完整影片。研究結果指,加入圖片和影片資料可改善規劃能力,亦令模型較能適應不同動作措辭;這讓研究團隊可以把多種來源的資料納入同一套規劃流程。

  • 在平均 MPC 規劃 LaLa-World 優於按領域或任務分開訓練的潛在世界模型。
  • 與採用相同條件的 RAEv2 影片生成模型相比,規劃表現相若,訓練成本低 6 倍,規劃速度快 13.9 倍。
  • LaLa-Policy 在 LIBERO 和 RoboCasa 的結果可與 Cosmos Policy 比較,推理速度最高快 5.5 倍。
  • 跨模態資料可提升規劃表現及對動作措辭的穩健性,對需要跨模擬與真實機械人資料研究的團隊較有吸引力。

這些結果令項目適合用作機械人規劃與政策學習研究,尤其是希望整合影片資料、減少逐個任務訓練成本的團隊。不過,GitHub 儲存庫目前仍在補齊內容:環境設定和資料準備程式已提供,LaLa-World 訓練及規劃評估程式、預訓練檢查點和解碼器則尚未公開,因此現階段未能按完整流程重現結果。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 庫

ShotVerse2.0:讓影片生成更有電影感

從文字生成影片時,角色衣着、場景和鏡頭動作往往難以同時維持一致。FAPL 訓練多模態語言模型理解影片生成所需的時間線索,並支援分項控制。

FAPL training framework

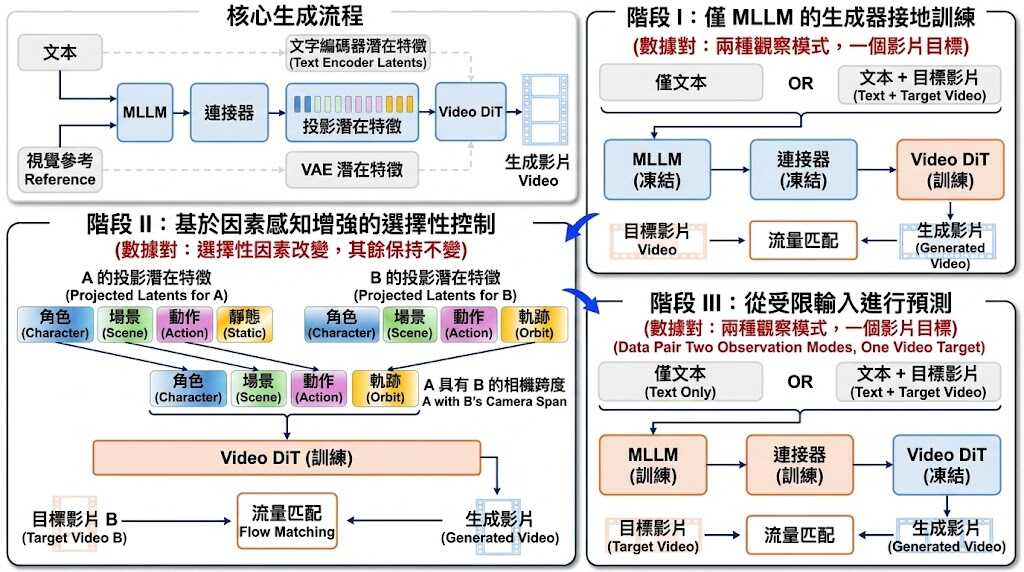
文字生成影片時,模型不只要描寫眼前一幕,還要推斷未提供的時間變化,並在角色、場景、動作和鏡頭之間維持一致。FAPL(Factor-Aware Predictive Learning,因素感知預測學習)是一套訓練方法,旨在讓多模態大型語言模型(Multimodal Large Language Model,MLLM)的表示真正參與影片生成,而非被解碼器繞過。

它以 UniVideo 的 13B Video DiT 為基礎,不改動模型架構,而是分三階段訓練:先令 DiT 以 MLLM 潛在表示作為內容條件,再透過成對的因素編輯資料,教模型只改指定內容、保留其他因素;最後固定 DiT,訓練 MLLM 與連接器,讓只有文字或文字加完整影片的輸入都能對應同一影片目標。這讓方法同時處理文字推斷影片細節,以及按因素選擇性控制的需求。

研究報告的評測中,FAPL 把 Motion Order 由 48% 提升至 61%,∩-Acc 由 42% 提升至 58%,FaceSim-Arc 則由 0.451 升至 0.523。展示案例亦呈現角色衣着和外觀較能維持一致;不過,這些數字來自指定評測,不能直接視為所有提示詞或影片情境下的保證。

目前較適合研究影片生成、希望改善多因素控制的團隊參考。GitHub 資料標示程式碼、模型權重及 CineFactor-10K 評測提示仍待發布,因此暫未能按儲存庫提供的資料安裝或重現訓練;現階段可先閱讀論文及項目網頁了解方法與示例。

  • 以 MLLM 潛在表示作為影片生成的內容條件。
  • 分開訓練內容 grounding、因素控制與有限輸入預測。
  • 可針對角色、場景、動作或鏡頭變更,同時保留其他因素。
  • 在所列評測中,動作順序、因素準確度與人臉相似度均有提升。
  • 程式碼、權重和評測提示尚未發布,現階段無法依實驗。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, 提示詞, 香港, 庫

Page 1 of 55
1 2 3 … 55