[技術文章] TextVerifier 補上中文生成文字的結構缺口

生成中文字,常見會多一劃或少一筆;TextVerifier 專門找出這類 OCR 容易漏掉的錯誤。

Hero image preview

生成圖片中的中文句子看似正確,單一字元卻可能多一劃、少一筆或部件變形,令出版、教育等不能出錯的場景無法採用。TextVerifier 把問題定義為有目標條件的文字渲染驗證:給定指定字元與圖片裁剪區,判斷兩者是否真正一致。

現有做法通常重用 OCR 或一般 vision-language models(VLM)評分。這些模型以辨認內容為目標,會刻意忽略字型、模糊和結構變化;中文錯字往往仍能被讀成原本字元,反而令最關鍵的筆畫及部件錯誤被放過。TextVerifier 改用字元的 Ideographic Description Sequence(IDS)作為文字端輸入,讓模型比較目標字的結構,而不只辨認符號。
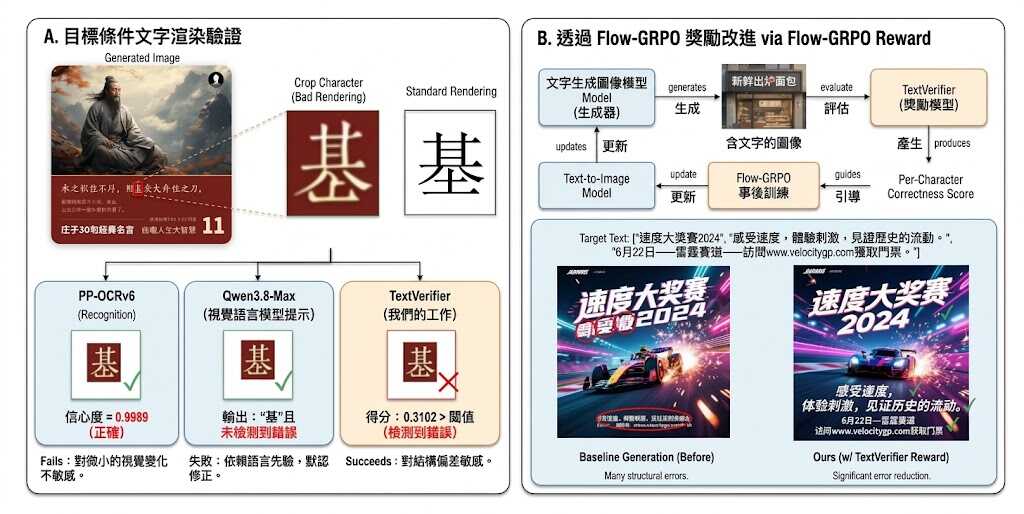
訓練資料包括 1,270 萬組 crop–IDS 配對,以及從文字區域 inpainting 模型訓練過程抽取的「同字不同質素」hard pairs。團隊亦建立 TEXTRENDERBENCH-ZH,逐字標註位置、身份與正確性,涵蓋 7,358 個生成中文字元。

• TextVerifier F1 為 0.844,高於 OCR confidence 的 0.526、一般 VLM 的 0.329 及 TextPecker 的 0.590。
• 驗證單位由整段文字下沉至單一字元,能捕捉局部筆畫與部件錯誤。
• 分數可用作 Flow-GRPO post-training 的 per-character reward,協助生成模型減少渲染錯誤。
• 適合需要逐字校驗的海報、教材、出版物及其他中文圖像生成工作流。

結果顯示,文字辨認和文字正確性驗證並不是同一項能力。TextVerifier 目前聚焦中文字符結構,對需要零錯誤輸出的場景更有針對性,但其成效仍取決於生成模型、字體風格及圖片品質。
Paper

Categories: 北京大學, 阿里巴巴, Image, 中國, Dataset 數據集

Doc2Harness:測試模型能否造出真正可用的 Coding Agent

Doc2Harness 不只測模型識唔識寫程式,還把整套 Coding Agent harness 交由模型建造,再以黑盒方式驗證是否真的運作。

Doc2Harness

當 Coding Agent 要處理長時間、多步驟工作,成敗不只取決於模型本身,還取決於工具呼叫、權限、工作階段、復原流程和整個執行迴圈。Doc2Harness 是一個評測基準,專門處理模型能否按照開發文件和介面骨架,建造完整 Coding Agent harness 的問題。

項目分成兩個階段:第一階段由 build model 在隔離容器內透過 OpenCode 實作 harness;第二階段會凍結成果,再放到另一個容器,由 scripted mock model 端到端驅動。評分不接受 harness 自己聲稱完成任務,而是讀取四個可觀察渠道:傳給模型的請求、磁碟檔案、程序 exit code,以及 command output;positive controls 亦會阻止空殼實作取得通過結果。

  • 測試範圍:完整基準包含 328 個 test cases,公開儲存庫只提供 94 個 scenarios,包括 53 個評分案例和 41 個 positive controls。
  • 模型差距:完整套件涵蓋 19 個 frontier models,最佳模型通過率為 53.05%,最低約 27.4%。
  • 可重現限制:排行榜數字來自完整套件,不能只用公開子集重現。
  • 執行條件:需要 Python 3.11+、Docker,依賴採用 Python standard library;完整 catalog 在 concurrency 12 下約需 25 至 90 秒。

這項目直接把 harness engineering 本身納入評測。結果亦反映模組拆分並非必然帶來好處:在控制程式碼大小後,module count 與通過率呈負相關,相關係數為 -0.423;同一模型在 direct drive 和 permissions 等場景的排名也可能大幅變動,顯示權限及工具編排是獨立而關鍵的能力。

Doc2Harness 適合研究 Coding Agent、模型評測和 agent infrastructure 的團隊,用來比較模型建造長流程工具系統的能力,亦可協助定位 harness 在請求流程、檔案操作、程序控制或復原機制上的失敗位置。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, Vibe Coding, 工具, Python, 庫, 編程, Anthropic, Dataset 數據集

LensErase 超精確移除物件,水印

只需圖片與 mask,LensErase 便可移除物件、文字或水印,再按周圍內容補回較自然的畫面。

logo mark

移除圖片中的水印、文字或多個物件時,難處往往不在於遮走目標,而是要同時處理陰影、反光及原本被遮住的背景。LensErase 以 foundation model 形式處理這類影像擦除工作,輸入一張圖片和一個 mask,輸出清理後的結果,適合海報整理、圖片修復及內容再利用等場景。

項目配套的 LensErase-100M 包含 101.07M 組對齊的 input–mask–target 三元組,涵蓋一般圖片、水印、大範圍 mask、視覺文字及海報五類資料,另有 140K 組 SFT samples 和 19K 組 RL samples。高解析度資料會由 GPT-5.6 Sol 檢查 mask 有效性、編輯正確性、重建效果及非目標內容保留程度。

LensErase-Bench 收錄 500 個案例,毋須指定唯一的 ground-truth target,改以 Removal、Inpainting、Preservation 和 Cleanliness 四個維度評估,當中完整移除目標及相關效果佔總分 40%。較貼近擦除任務的實際情況,因為同一個遮罩可能存在多個合理的背景補全方案。

  • 支援物件、視覺文字、水印及其相關效果的移除
  • 以 LensErase-100M 支援 pretraining、SFT 及 RL
  • 以 LensErase-Bench 評估移除、補全、保留和畫面潔淨度
  • 提供與 GPT-Image2.5-Sunburst、Flux2-Erase 及多個開源模型的比較
  • 頁面目前只表示 Code coming soon,未提供安裝、下載或使用流程

項目展示了跨場景和多物件擦除能力,亦包括海報及反射等較複雜案例。對需要批量清理素材、保留非目標結構的影像工作流;不過使用者仍需等待程式碼及更多可重現資料。

項目主頁

Categories: 開源, 北京大學, 模型, 模型訓練, 微軟, OpenAI, Stable Diffusion, Image, Dataset 數據集, 強化學習

GroundAnything 以並行解碼提升視覺定位速度

GroundAnything 把多種視覺定位任務放進 4B 模型,嘗試同時處理精準座標與推理速度的取捨。

GroundAnything

要在圖片中找出物件、位置和空間關係,GroundAnything 可一次處理多類 visual grounding 任務,減少逐個輸出座標帶來的延遲。它屬於 4B 級視覺基礎模型,實際處理的是影像內容與文字查詢之間的精準定位問題,適合影像標註、視覺搜尋及多模態分析工作流。

模型以 GroundAnything 的 diffusion decoding 配合 parallel decoding,讓空間假設可以並行生成;GroundAnything-VLM 則是獨立的 autoregressive checkpoint。前者針對序列生成的速度限制,後者保留自回歸模型路線,兩者均使用 GAM evaluation mode,並非同一模型的不同介面。

項目透過 grounding pretraining、AR-to-diffusion conversion、joint objectives、supervised fine-tuning 和 GRPO-based reinforcement learning 建立模型。30 個基準測試中,GroundAnything 勝過同級自回歸模型的整體最佳結果,亦超越較大的 Qwen3.7-Max;GroundAnything-VLM 在同級別取得新的整體最佳結果,並與 GPT-6 Astra 保持競爭力。

適合需要精準視覺定位、又要控制推理延遲的研究團隊和影像處理項目,硬件需求、實際吞吐量及不同圖片任務的穩定性仍需自行驗證。

  • 速度取捨:以 diffusion decoding 和並行輸出減少空間預測的序列等待。
  • 模型關係:GroundAnything 是 diffusion 路線,GroundAnything-VLM 是獨立 autoregressive checkpoint。
  • 評估範圍:涵蓋 30 個 benchmarks,並比較 MTP-based generation 與多階段基礎設施優化。
  • 適用場景:影像定位、批次標註、視覺搜尋及需要座標輸出的多模態工作流。

項目主頁 · GitHub

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, 香港, 強化學習

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

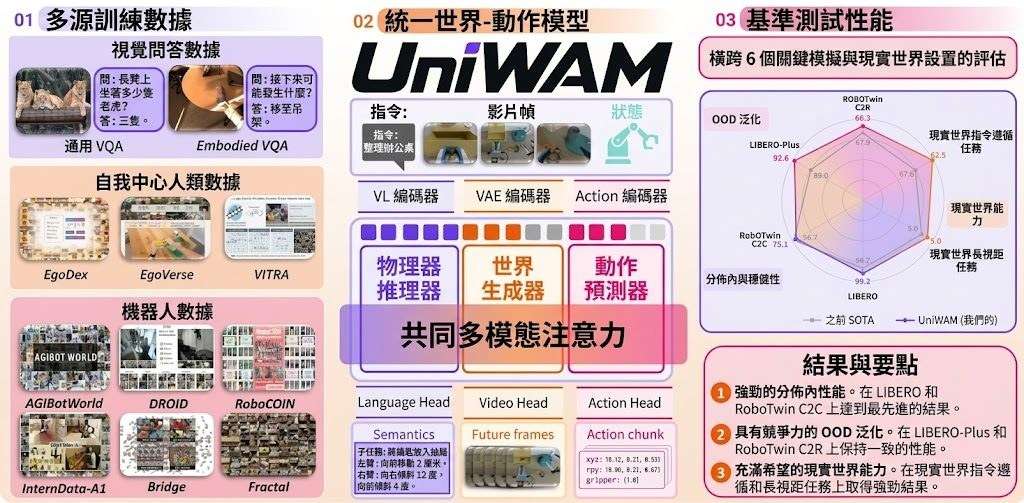
UniWAM 把理解、預測與機械人動作合而為一

UniWAM 以 8B 參數模型整合語意理解、視覺預測和動作生成,瞄準機械人操作中理解與執行脫節的問題。

UniWAM teaser

面對需要理解指令、預測環境變化再控制機械人的任務,UniWAM 將三個步驟放進同一個 8B-parameter 模型,屬於結合世界模型與 Vision-Language-Action(VLA)的開源研究項目。它以 Mixture-of-Transformers(MoT)連接 physical reasoner、world generator 和 action predictor,讓三者透過 joint multimodal attention 交換資訊。

模型不只依賴機械人示範,預訓練亦混合 human egocentric data、robot data 及 visual question answering(VQA)資料,並把低層動作轉成自然語言,改善視覺語言能力與實體操作之間的銜接。Post-training 再加入 future visual noise augmentation,配合 history-conditioned flow matching,以較少 denoising steps 生成動作。

  • 整合範圍: 同時處理 physical reasoning、視覺生成與動作預測
  • 訓練訊號: 結合機械人、第一身人類視角及 VQA 資料
  • 效率設計: 用動作歷史初始化生成流程,減少 denoising steps
  • 硬件成本: RoboTwin 2.0 post-training 曾以 8 張 NVIDIA H100 GPU 執行 10 小時

GitHub 儲存庫提供 models/、train/ 和 utils/ 等模型與訓練程式,並附有 RoboTwin 2.0、LIBERO 及 LIBERO-plus 的資料處理和評估工具。Python 3.10、CUDA 兼容的 PyTorch 環境較適合測試,使用者可先以模擬器資料和配置檔驗證訓練或推理流程。

項目首頁宣稱 UniWAM 在 in-distribution、robustness、generalization 及 instruction following 等多項評估取得 SOTA,但儲存庫提供的資訊未列出完整分數和比較表。Bridge、DROID、Fractal 以及 real-world inference 明確不在今次發布範圍內,因此它較適合研究團隊測試統一式機械人模型,而不是即時接駁真實機械人的現成方案。

項目主頁 · GitHub · 項目

Categories: 開源, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, VLA, Robotic, 香港, 工具, Python, 庫, Dataset 數據集

EngiWorld 把工程代理接入真實軟件工作流

EngiWorld 不只測試代理人能否操作介面,更檢查它能否交付合乎工程規範的成果。

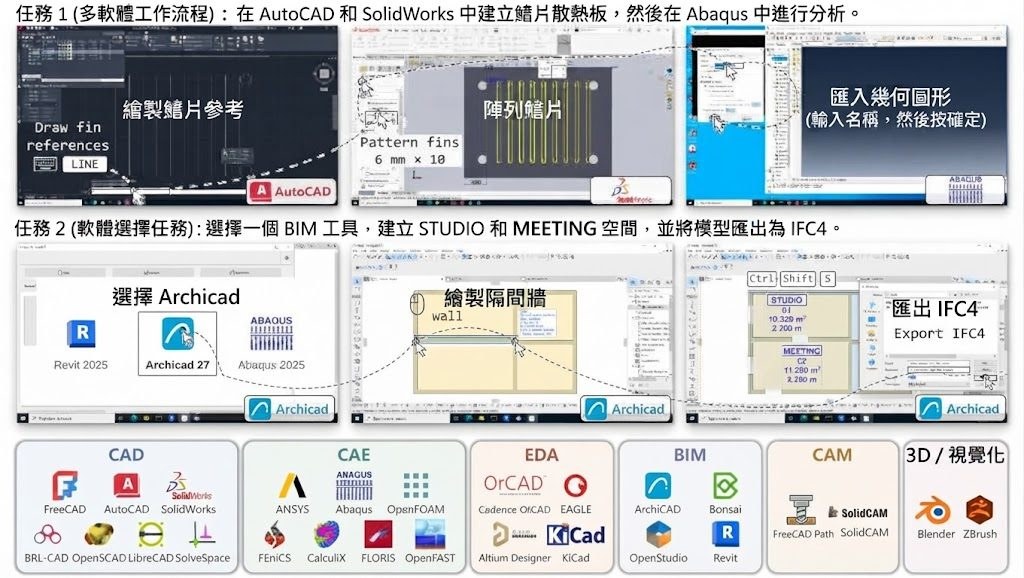
EngiWorld task examples and engineering software coverage

代理人要在 CAD、CAE、CAM、BIM、EDA 和 3D 視覺化軟件中完成工作,難點不只是點擊按鈕,而是要維持幾何、物理條件及跨軟件流程的正確性。EngiWorld 屬於工程代理人評測基準,實際處理的是「能否由指令一路產出可驗證工程成果」這個問題。

項目收錄 1,301 個專家編寫任務,涵蓋 26 個軟件平台、6 個工程領域及 6 類任務,支援 GUI 和 CLI。評測會檢查最終及中間工程文件的幾何有效性、物理可行性和規則符合度,數值設計任務亦會按規格達成程度連續計分,而非只分成功或失敗。

  • 提供完整任務、驗證器及 GUI/CLI 評測執行環境
  • 主實驗採用 300 個任務,清單位於 task/splits/main-300.txt
  • 本地環境以 Linux、Docker 及虛擬機器執行,預設每個環境使用 4 個 CPU 和 16 GB RAM
  • 七個前沿模型中,最高 EngiScore 只有 44.3;多軟件嘗試成功率為 3.6%

同類 Computer-use agents 評測多集中於一般桌面操作,EngiWorld 把判斷標準推到可交付的工程 artifact,因此更能揭示模型在長流程、跨軟件依賴及專業規範上的不足。代價是執行門檻較高:需要 x86_64 Linux、Python 3.10、Docker Engine 和環境映像,沒有 /dev/kvm 時亦可運行,但軟件模擬會較慢。

研究團隊、工程軟件開發商,以及想比較 GUI agent、CLI agent 或多模態模型能力的團隊,都可以用它重現測試並保存評測結果。它目前更適合作為嚴格的研究及模型比較工具,而非即插即用的生產自動化方案;最高分數與多軟件成功率反映,代理人距離穩定完成專業工程流程仍有明顯距離。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, 多模態模型, 軟件, 工具, 3D, Python, Dataset 數據集

HybridCUA 讓 Agent 懂得何時用命令列

浙江大學、北京大學與清華大學團隊,讓 Computer-use agents 在 GUI 操作與 CLI 指令之間作出選擇,減少冗長點擊流程及連鎖錯誤。

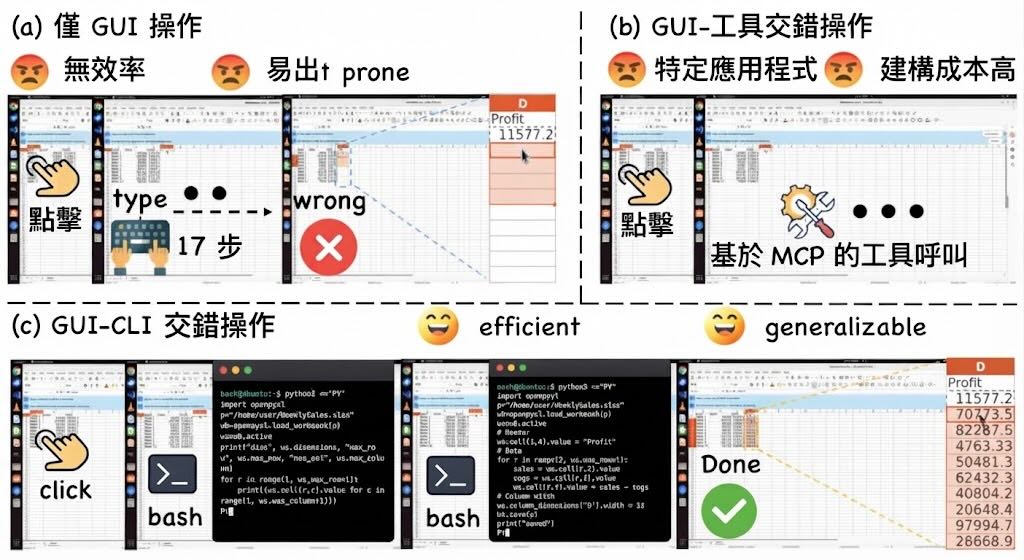
浙江大學、北京大學與清華大學的研究團隊,將 CUA (Computer-use agents) 從單靠滑鼠鍵盤操作,帶到 GUI 與 command line interface(CLI)協作的工作方式。HybridCUA 屬於訓練框架及模型項目,處理的是代理知道可以用 shell 之後,仍未能判斷何時使用、如何使用的問題。

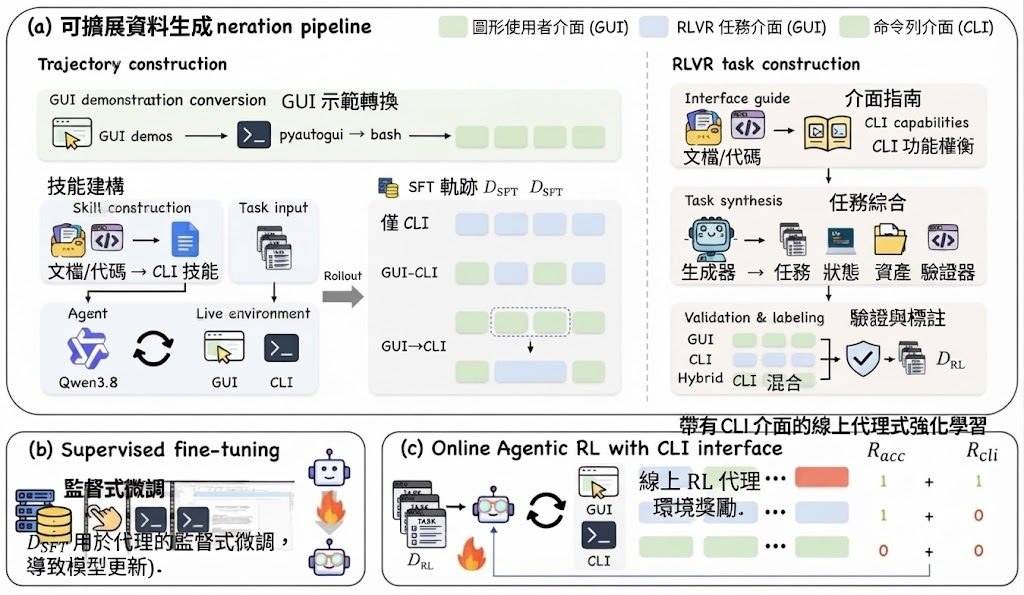
連串的 GUI 操作可以由一條命令取代,但 CLI 暴露給未受訓練的代理,反而令 OSWorld 準確率下降 2.5 至 11.5 個百分點。HybridCUA-8K 收集 GUI only、CLI only,以及交錯使用兩者的軌跡,再配合 supervised fine-tuning 和 CLI-aware rewards,訓練 HybridCUA-9B 選擇較合適的操作方式。

HybridCUA pipeline: (a) scalable generation of GUI-only, CLI-only and interleaved trajectories plus annotated RLVR tasks

• HybridCUA-9B 在 OSWorld 達到 53.6%,較基礎模型高 14.8 個百分點
• 平均每項任務使用 14.0 步,並可轉移至 OSWorld-MCP 及 Windows
• HybridCUA-8K 包含 5K 條混合軌跡及 3K 個已驗證 RLVR 任務
• CLI reward 分為 trajectory level 與 step level,分別鼓勵成功完成及減少失敗指令成本

儲存庫以 env_infra、online-rl 和 site 分開環境平台、GRPO 訓練流程及項目網站;前兩者透過 HTTP 的 /v1/sessions 協作,訓練器毋須自行啟動 VM 或容器。README 提供安裝腳本及 GPU、nvcc、Ray 等環境要求,但模型仍標示為 coming soon,因此目前較適合研究 Computer-use agents、GUI automation 或跨平台代理訓練的團隊閱讀資料集與訓練架構。

結果在 WindowsAgentArena 提升 4.0 個百分點,OSWorld-MCP 達 47.1%,Windows 達 36.0%,顯示 GUI 加 CLI 的方法具備一定跨平台能力;不過項目仍依賴複雜的分散式訓練環境,未提供即時可下載模型,距離一般使用者直接安裝仍有距離。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 清華大學, Agentic, MCP, 模型訓練, 庫, Dataset 數據集

WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

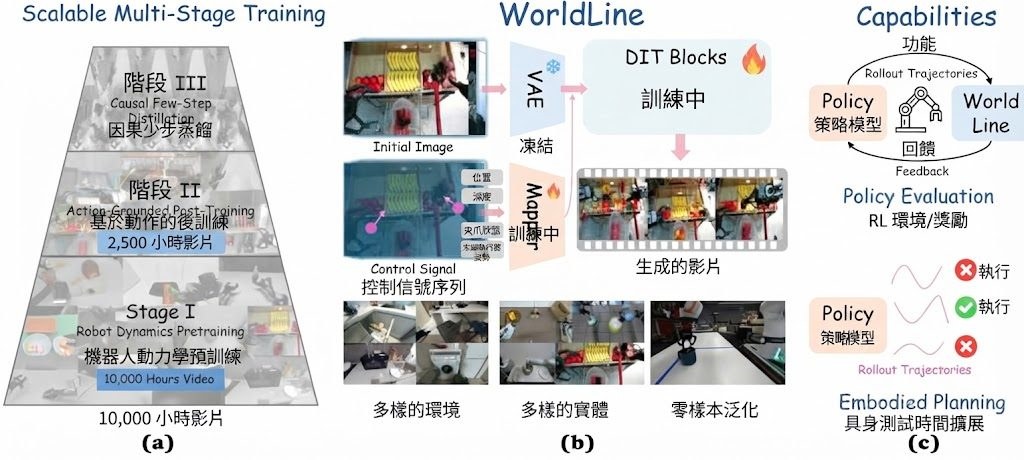
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

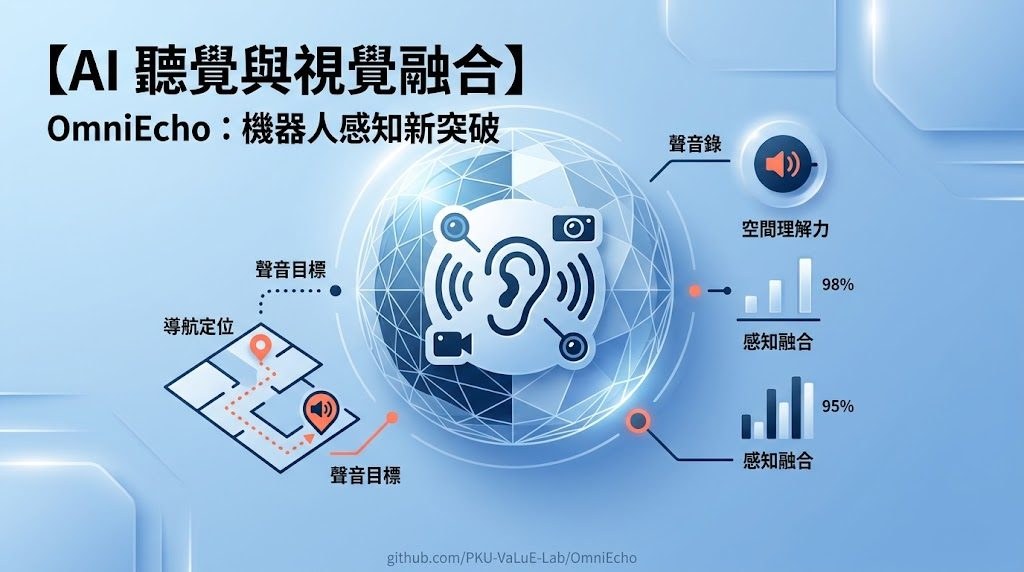
OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

Page 1 of 4
1 2 3 4