A.I. 入門


01 課程核心學習範疇
這門課程並非單純調用 API,而是專注於真實的系統工程與底層實作,內容直擊現代大語言模型研發的核心環節:
02 各講精選教材與講義
基礎架構與硬體運算規劃
01 Course site: 課程主頁,包含完整課程大綱與學習指引。
👉 開啟 CS336 官方首頁
02 Lecture 1 — Overview and Tokenization: 大語言模型全貌概述與分詞機制實現。
👉 檢視 Lecture 1 Trace 講義
03 Lecture 2 — PyTorch and Resource Accounting: 深入 PyTorch 運算特性及硬體資源、記憶體與算力預算計算。
👉 檢視 Lecture 2 Trace 講義
架構深究與核心優化
04 Lecture 3 — Architectures: 現代 LLM 模型架構設計要點。
👉 下載 Lecture 3 講義 (PDF)
05 Lecture 4 — Attention Alternatives and Mixture of Experts: 注意力機制替代架構與專家混合模型(MoE)。
👉 下載 Lecture 4 講義 (PDF)
06 Lecture 6 — GPU Kernels and Triton: 撰寫高效 GPU 核心程式與 Triton 實務開發。
👉 檢視 Lecture 6 Trace 講義
07 Lecture 7 — Parallelism: 深入張量並行、流水線並行等大規模分散式訓練機制。
👉 檢視 Lecture 7 Trace 講義
擴展法則、語料工程與對齊技術
08 Lecture 9 — Scaling Laws: 深入解析算力、參數量與資料集規模的擴展規律。
👉 下載 Lecture 9 講義 (PDF)
09 Lecture 13 — Data: 預訓練語料工程、清洗、過濾與高品質資料集建構。
👉 檢視 Lecture 13 Trace 講義
10 Lecture 15 — Mid/Post-training (SFT/RLHF): 監督微調與人類回饋強化學習等後訓練對齊技術。
👉 下載 Lecture 15 講義 (PDF)
03 完整課程資源對照表
| 編號 | 單元 / 主題 | 主要領域 | 資源連結 |
|---|---|---|---|
| 01 | Course Site | 官方首頁與課綱 | cs336.stanford.edu |
| 02 | Lecture 1 | Overview & Tokenization | 線上 Trace 講義 |
| 03 | Lecture 2 | PyTorch & Resource Accounting | 線上 Trace 講義 |
| 04 | Lecture 3 | Architectures | PDF 下載 |
| 05 | Lecture 4 | Attention Alternatives & MoE | PDF 下載 |
| 06 | Lecture 6 | GPU Kernels & Triton | 線上 Trace 講義 |
| 07 | Lecture 7 | Parallelism | 線上 Trace 講義 |
| 08 | Lecture 9 | Scaling Laws | PDF 下載 |
| 09 | Lecture 13 | Data Engineering | 線上 Trace 講義 |
| 10 | Lecture 15 | Mid/Post-training (SFT/RLHF) | PDF 下載 |
人工智慧(AI)與機器學習的底層完全是由數學構建而成的。如果要系統性地列出所有 AI 需要的數學基礎,可以將它們分為「四大核心支柱」以及「三大延伸與高階領域」。
以下是為你整理的完整 AI 數學地圖:
核心支柱一:線性代數 (Linear Algebra) —— 空間與資料的轉換
線性代數是 AI 處理資料的語言。在 AI 中,所有的資料(文字、圖片、聲音)都會被轉換成向量和矩陣。
- 基礎概念: 向量 (Vectors)、矩陣 (Matrices)、張量 (Tensors)。
- 核心運算: 矩陣乘法、行列式、矩陣的跡 (Trace)。
- 矩陣分解與空間轉換: * 特徵值與特徵向量 (Eigenvalues & Eigenvectors)
- 奇異值分解 (SVD, Singular Value Decomposition)
- 主成分分析 (PCA) —— 用於資料降維。
- AI 應用: 神經網路權重運算、圖像卷積處理、大型語言模型(LLM)的 Embedding(詞嵌入空間)。
核心支柱二:微積分 (Calculus) —— 模型的學習與優化
微積分負責解決 AI 如何「從錯誤中學習」的問題。透過計算變化率,AI 才能調整自身參數。
- 單變數與多變數微積分: 導數 (Derivatives)、偏導數 (Partial Derivatives)。
- 重要函數與法則: * 連鎖律 (Chain Rule) —— 深度學習反向傳播算法 (Backpropagation) 的核心。
- 激活函數的導數(如 Sigmoid, ReLU 的導函數)。
- 向量微積分: 梯度 ($\nabla$, Gradient)、雅可比矩陣 (Jacobian Matrix)、海森矩陣 (Hessian Matrix)。
- AI 應用: 計算損失函數的斜率,指引模型參數調整的方向。
核心支柱三:機率與統計 (Probability & Statistics) —— 處理不確定性
AI 的本質是在充滿雜訊的現實世界中做出「最佳猜測」,機率論提供了量化不確定性的工具,統計學則提供了從資料中抽取出規律的方法。
- 機率基礎: 條件機率、貝氏定理 (Bayes’ Theorem)。
- 隨機變數與機率分佈: 離散與連續分佈(高斯/常態分佈、二項分佈、對數常態分佈、Poisson 分佈)。
- 統計推論與估計: * 最大概似估計 (MLE) 與 最大後驗機率估計 (MAP)。
- 期望值、變異數、協方差矩陣 (Covariance Matrix)。
- 假設檢定 (Hypothesis Testing)、顯著性差異。
- AI 應用: 預測分類機率、擴散模型(Diffusion Models)的去噪、大型語言模型的下一個字預測(Token Prediction)。
核心支柱四:最佳化理論 (Optimization Theory) —— 尋找最完美的解答
微積分給了我們工具,最佳化理論則給了我們「尋找最佳解的策略與地圖」。
- 無約束最佳化: 梯度下降法 (Gradient Descent)、隨機梯度下降 (SGD)、Adam 優化器。
- 約束最佳化: 拉格朗日乘數法 (Lagrange Multipliers)、KKT 條件。
- 凸最佳化 (Convex Optimization): 確保能找到全局最佳解(Global Minima)而非局部最佳解(Local Minima)。
- AI 應用: 讓 AI 模型在訓練時,以最快、最有效率的方式將損失函數(誤差)降到最低。
延伸領域五:資訊論 (Information Theory) —— 衡量學習效率
資訊論原本用於通訊,但在 AI 中,它被用來量化資訊量以及模型預測的準確度。
- 核心概念: 資訊熵 (Entropy)、交叉熵 (Cross-Entropy)、KL 散度 (KL Divergence)、互資訊 (Mutual Information)。
- AI 應用: * 交叉熵損失函數: 幾乎所有分類模型(如貓狗辨識、文字分類)的標準評估指標。
- KL 散度: 用於 VAE(變分自編碼器)與 RLHF(人類回饋強化學習)中,防止模型策略偏離太遠。
延伸領域六:離散數學與圖論 (Discrete Mathematics & Graph Theory) —— 結構化關聯
當資料不是整齊的表格,而是複雜的網路或邏輯關係時,就需要離散數學。
- 圖論基礎: 節點 (Nodes)、邊 (Edges)、鄰接矩陣 (Adjacency Matrix)、樹狀結構 (Trees)。
- 數理邏輯與組合數學: 命題邏輯、集合論、排列組合。
- AI 應用: * 圖神經網路 (GNN): 應用於社群網路分析、蛋白質分子結構預測、推薦系統。
- 知識圖譜 (Knowledge Graph): 讓 AI 具備邏輯推理能力。
延伸領域七:數值分析與高級幾何 (Advanced Domains) —— 穩定性與前沿架構
這屬於較為高階或特定前沿領域才會深入涉獵的數學。
- 數值分析 (Numerical Analysis): * 研究浮點數運算的誤差、矩陣運算的數值穩定性(避免梯度爆炸或消失)。
- 微分幾何與拓撲學 (Differential Geometry & Topology):
- 幾何深度學習 (Geometric Deep Learning): 研究非歐幾里得空間(如 3D 點雲、流形空間 Manifold)的資料架構。
- 實分析與測度論 (Real Analysis & Measure Theory):
- 用於嚴格證明機率論與深度學習理論的底層收斂性(偏向學術研究)。
💡 學習建議的優先順序
如果你是 AI 的初學者或應用端工程師,建議的點技能順序為:
線性代數 – 微積分 – 機率與統計 – 最佳化理論(梯度下降) – 資訊論(交叉熵)
Text Embedding
文本嵌入(Text Embedding)技術與應用指南
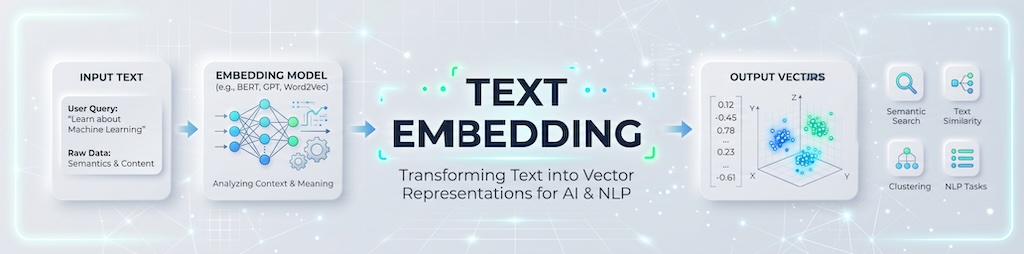
Text Embedding(文本嵌入)是一種自然語言處理技術,用於將文本轉換成數值向量,保留其原始文本的意義和結構。這些向量被稱為 Embeddings,它們可以用於許多 NLP 任務,如文本類似度計算、文本生成、文本分類等。 Text Embedding 的目標是將文本轉換成一種可數學化的形式,使得它們能夠與其他數值向量進行比較和運算。這樣可以讓模型在處理文本時,能夠利用傳統的神經網路技術來進行分析和預測。

常見的 Text Embedding 方法
隨著自然語言處理技術的演進,Text Embedding 的生成方法已從早期的靜態詞向量,發展至如今基於大語言模型的動態上下文向量。以下是目前最常見且主流的方法:
1. 經典靜態向量方法(Static Embeddings)
這類方法為每個單詞生成固定的向量,計算速度快,但無法解決一詞多義的問題。
- Word2Vec:是一種用於將單詞轉換成數值向量的方法,它通過訓練 Word Embeddings 模型來獲得每個單詞的向量表達。
- GloVe:是一種基於矩陣分解的方法,旨在獲取每個單詞的向量表達,並利用文本中單詞之間的關聯信息來進行學習。
- FastText:由 Facebook 開發的 Word2Vec 升級版。它引入了子詞(Subword)的概念,將單詞拆解為 Character n-grams 進行訓練,因此能有效處理未登錄詞(Out-of-Vocabulary, OOV)與錯字問題。
2. 動態上下文編碼方法(Contextualized Embeddings)
這類方法利用預訓練模型,能夠根據單詞在句子中的上下文位置,動態生成不同的向量表達。
- BERT(Bidirectional Encoder Representations from Transformers):是一種基於 transformer 架構的預訓練模型,它通過將文本轉換成向量表達,並且能夠捕捉到文本中的長距離依賴關係。
- BGE(Beijing Academy of Artificial Intelligence):如 bge-large-zh-v1.5,在 MTEB(多任務文本嵌入基準)榜單上名列前茅,對中文的語義相似度計算與檢索任務表現極為優異。
- mE5(Multilingual E5):由微軟開發的嵌入模型,其多語言版本(multilingual-e5-large)在處理中英文混雜的文本時,效果非常精準且穩定。
3. 前沿大模型與長文本嵌入方法(LLM-based & Long-Context Embeddings)
因應大語言模型(LLM)與 RAG(檢索增強生成)的爆發,新一代的 Embedding 具備更強的跨語言能力與龐大的 Token 容納量。
- OpenAI Embeddings(如 text-embedding-3-large):目前商業應用中最普及的方案之一。支援高達 3072 維度的向量,具備極強的跨語言理解能力,並支援縮減維度技術。
- Cohere Embeddings:在企業級搜尋中表現出色,特別針對多語言以及含有雜訊的網頁文本進行了深度優化。
- Jina Embeddings:主打長文本處理能力,傳統的 BERT 模型通常限制在 512 個 Token,而 Jina 支援高達 8k 甚至更長的輸入,適合分析整篇長報告或論文。
Text Embedding 的重要應用
Text Embedding 在自然語言處理領域有著廣泛的應用,主要包括:
- 文本類似度計算(Semantic Similarity):使用 Embeddings 可以比較兩個文本的相似程度。這在問答系統、搜尋引擎以及 RAG(檢索增強生成)的知識庫檢索中是核心技術。
- 文本分類(Text Classification):通過將文本轉換成向量表達,可以進行情感分析、垃圾郵件過濾、新聞標籤分類等 NLP 任務。
- 文本生成(Text Generation): Embeddings 可以用於生成新的文本,輔助大模型理解輸入提示詞(Prompt),進而達成高質量的文本摘要或文本完成。


