Show-Harness:VLM 極簡語意操縱機械臂

Show-Harness 把機械人控制壓縮成一組離散語意動作單位,讓視覺語言模型直接負責物理決策,省去針對特定硬件的預訓練與額外參數。

Show-Harness

機械人領域一直有個尷尬落差:底層視覺語言模型(VLM)識睇識講,但要佢實際控制一隻機械臂,往往要再預訓練、加 VLA 頭或寫一大堆適配層。Show-Harness 嘗試用另一種方式切入──直接把動作壓縮成一組細粒度、離散的語意單位(例如 MV_FWD、GRASP、ROTATE_CW),由 VLM 逐個 token 推理,再交俾硬件專屬嘅 interpreter 去 deterministically 落地成實際機械動作。換句話,VLM 唔再需要理解「毫米」或「關節角度」,只需揀語意單位。

你可以用兩種方式跑:直接接駁前沿閉源 VLM 做 zero-shot 控制,又或者拎幾個 GPU 小時微調小型開源 VLM,產出每秒 12 至 33 Hz 嘅本地執行版本。Franka、AgileX Piper(單臂同雙臂)、ManiSkill、Isaac Lab 都共用同一套詞彙同一個 prompt,唔使逐隻 robot 寫 prompt。項目同時附帶 GUMI:一個瀏覽器內嘅 GUI 操作介面,等你可以用鍵盤滑鼠親身「玩」機械人收 demonstration,完全唔需要專業遙操作硬件。

  • 極薄中介層:VLM 只負責揀語意 token,所有 metric 細節由 interpreter 處理,避免額外模型容量開支
  • 跨硬件共用詞彙:Franka、AgileX、ManiSkill、Isaac Lab 共用同一套動作字典與 prompt
  • 兩種部署路徑:前沿閉源 VLM zero-shot,又或者 LoRA 微調小型開源 VLM,本地即可執行
  • GUMI 無硬件收數據:瀏覽器內 GUI 操作即收 demonstration,省去 teleoperation 設備
  • 插件式消融設計:一個目錄、一個 boolean flag,閂咗就等同冇裝

相對於 π0.5 同 GR00T 呢類 VLA 路線,Show-Harness 嘅取捨偏向「interface 解耦」──唔再要求模型本身內化硬件物理量,而是把 metric 還返俾環境層解讀。對做具身研究、想快速換 embodiment 驗證嘅團隊,或者資源有限、要靠 LoRA 微調部署嘅實驗室都幾實用;研究 embodied agent 同 VLM 接駁嘅開發者都可以直接拎去試 prompt 同詞彙設計。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 模型訓練, VLA, Robotic, Dataset 數據集

MiniMax H3 首尾幀工作流:ComfyUI 一張面板切換三模式、輸出帶聲影片

這個 ComfyUI 工作流把 MiniMax H3 的首尾幀、Turbo LoRA、影片與音訊 VAE 全部封進子流程,外層直接選模型、改步數與時長,最後由 SaveVideo 輸出 24fps 的帶聲短片。

MiniMax H3 总控面板使用指南

想用兩張圖片框住一段六秒帶聲音的影片,再順手在 ComfyUI 面板上換模型、改步數,這個工作流把這件事收得很緊。整套流程把 MiniMax H3 的基礎模型、Qwen3-VL 文本編碼器、影片與音訊 VAE,以及四步 Turbo LoRA 全部塞進一個子流程,常用參數留在外層,內層只負責解析度對齊 32 倍數、計算幀數、把影片與音訊解碼後合成輸出。

跟一般 ComfyUI 影片節點相比,它最直接的差異是「首尾幀可選」:上方節點接首幀、下方節點接尾幀,兩個都填就是首尾幀生成,只填首幀就退回傳統圖生視頻,兩個都跳過則變成純文生視頻,三種模式不用複製工作流,直接在同一張畫布切換。音訊方面也省事,音訊 VAE 跟影片 VAE 分開載入,輸出端靠 SaveVideo 一次寫入 mp4,不用再手動合成聲道。

部署門檻主要在三個地方:ComfyUI 要支援子圖功能、要額外安裝 ComfyUI-MiniMax-H3-Turbo 節點包以取得 MiniMaxH3TurboLoRA,以及 Hugging Face 上的五個權重檔案要放到對應的 diffusion_modelstext_encodersvaeloras 目錄。JSON 內只記錄檔名而非圖片本體,使用前要把首幀、尾幀重新上傳;工作流也沒有附帶顯存或速度數據,必須自己測試本地硬體夠不夠撐得起 int8 基礎模型加 Qwen3-VL 32B 文本編碼器。

對已經在跑 ComfyUI、又想試 MiniMax H3 首尾幀能力的人,這個工作流算是最低摩擦的入口:不用自己接駁一堆節點,也不用研究子流程內部的取樣細節,外部面板就涵蓋了模型選擇、步數、目標時長、種子、寬高比與百萬像素等設定。對只想快速驗證概念或做短影音素材的內容創作者,這種「拉進畫布、換圖、寫 prompt、執行」的流程會比從零搭建省下不少時間。

重點摘要

  • 類型:ComfyUI 工作流 JSON,屬於模型整合與流程封裝類工具,目標是簡化 MiniMax H3 帶聲影片生成。
  • 核心能力:首尾幀、首幀圖生視頻、文生視頻三種模式可切換,並內建音訊解碼與合成。
  • 關鍵依賴:ComfyUI 需支援子圖,另需安裝 ComfyUI-MiniMax-H3-Turbo 節點包與五個 Hugging Face 模型檔案。
  • 輸出規格:24fps,寬高自動對齊 32 倍數,時長與步數可在外層調整。
  • 限制:未提供顯存峰值、速度與相容性測試,需自行驗證本地硬體;JSON 內只存圖檔名,圖片要重新上傳。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, Video, Image, Audio, 工具, Content Creator, MiniMax

PWM(Programmable World Model) 以世界模型驅動影片生成

AlayaLab 開源的 Programmable World Model 把世界狀態與畫面生成拆開管理,讓角色、事件與鏡頭外的物件都能被查詢、修改與驗證,不再只靠潛在影像記憶。

Programmable World Model overview

影片世界模型能夠即時渲染出像真的畫面,但畫面背後其實欠缺一部「世界引擎」——狀態藏在影像序列裡,難以檢查、編輯或驗證,鏡頭一轉,鏡頭外的角色與潛在事實就會被悄悄遺忘。AlayaLab 開源的 Programmable World Model(簡稱 PWM)正正針對這個痛點,把世界狀態的維護與視覺生成徹底解耦,由一個 state executor 負責推進世界狀態,再由 deterministic compiler 把以 state-augmented 3D OBB 描述的狀態投影成 pixel-aligned controls,最後才交給影片模型渲染畫面。

這個框架真正解決的問題,是讓世界「可被編程」。同一份世界狀態可以驅動任意鏡頭、任意視覺風格,角色即使離開畫面依然存在,事件具備不可逆性,亦可由規則觸發;使用者可以用類似 WASD 的方式操控,並預先以語言定義世界規則。一個 VLM-based agent 會讀取參考圖與開放式文字,自動寫出可執行的世界規格。

PWM 屬於框架類項目,定位接近研究原型。與 Genie 3、GameNGen 等同類做法相比,PWM 的取捨在於放棄純端到端的潛在表達,換取可查詢、可驗證、可長時序的狀態;對於遊戲開發者、需要可控互動世界的模擬研究者,以及想用程式化方式生成可控影片內容的團隊,這種顯式狀態設計明顯更貼近「世界引擎」的真正需求。

目前 PWM 已釋出技術報告,推理程式碼與預訓練權重尚未開源,因此暫時只能從紙面層面理解並等待官方補上權重。從架構看,這個方向對於追求可控性與持久性的應用場景會有明顯吸引力。

重點摘要:

  • 狀態與畫面解耦:狀態由 executor 維護,畫面由影片模型渲染,互不綁定
  • 可查詢、可驗證的世界事實:角色、事件與鏡頭外實體都能被檢查與修改
  • 持久世界:鏡頭外的物件與潛在狀態不再被遺忘,長時序互動更可靠
  • VLM agent 自動生成世界規格:以參考圖加文字描述即可寫出可執行的世界規則
  • 尚待補完:推理程式碼與預訓練權重仍未釋出,目前以技術報告形式呈現

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 世界模型, Video, Image, 框架, 3D

RoboSPA 用 280 個難度變體幫你壓力測試

RoboSPA 是浙江大學團隊針對 Vision-Language-Action 模型推出的診斷式基準,透過逐步拉高空間歧義與程序步數,揭開現有機器人策略在精準定位與長程規劃上的短板。

Repository image for fanzhenxuan/RoboSPA

當 VLA(Vision-Language-Action)模型在乾淨、短任務的環境中跑出不錯的成功率,要怎樣才知道它是真正「理解」指令,還是只是剛好蒙對?RoboSPA 給出的答案是:把場景弄得更亂、把步驟拉得更長,然後看模型從第幾關開始崩潰。這是一個基準與數據集項目,建基於 RoboTwin 2.0 模擬框架(SAPIEN + CuRobo),由浙江大學主導,已獲 EMNLP 2026 收錄。

它把 56 個基礎任務各衍生出五個難度級別(L1–L5),共 280 個變體,覆蓋五種機械臂實體(Franka、Piper、UR5、Aloha-AgileX、ARX-X5),總計 527K 條軌跡、約 108M 步數、997 小時互動影片。Spatial 維度持續加入外觀相近的候選物,Procedural 維度則逐步疊加子目標、執行順序、重複次數與記憶需求。

與只看最終二元成敗的傳統做法相比,RoboSPA 額外提供兩個診斷指標:空間任務用 ONTA(Object-Normalized Target Accuracy) 衡量模型能否在「看起來都像」的物件中選對目標,並以 chance-corrected 方式扣掉隨機命中;程序任務則用 Progress Score(PS) 計算實際完成的子目標比例,反映模型在中途卡住或跳步的真實狀況。

適合機器人實驗室、VLA 模型開發者,以及需要評估策略可擴展性的團隊。支援自帶策略接入,數據與代碼均已公開。研究端在多個代表性 VLA 模型上的結果顯示,空間關係、低階精細動作與長程記憶仍然是明顯瓶頸。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, Video, VLA, 框架, 中國, Dataset 數據集

Marigold V2:把擴散 Transformer 改成一步深度估計模型

只要一張普通 RGB 相片,就即時輸出高質素深度圖,連毛髮和髮絲等幼節都保留到。Marigold V2 把預訓練擴散 Transformer 改造為單步密集預測模型的開源項目,一張消費級 GPU 一星期內就能完成微調。

Project website

過去做單目深度估計,要麼靠傳統監督學習,要麼用擴散模型疊好多步去噪,兩者都唔易兼顧細節同效率。華為 Bayer Lab 開源 Marigold V2 走第三條路:直接把預訓練嘅擴散 Transformer(DiT)當成單步密集預測器,重新微調之後輸出深度、透視深度、法線、反照率等多種密集模態,毋須反覆去噪。對從業人員嚟講,呢個改動意味住一張普通 RGB 相可以即時變成帶細節嘅深度圖,毋須等幾秒去疊步驟,毛髮邊緣同髮絲呢類幼節都保留得到,貼近 SOTA 水準。

模型家族同訓練成本:每個 checkpoint 包含一組 rank-128 LoRA 適配器,配合 4-bit 量化嘅 DiT 主體,個別任務仲會附帶微調過嘅 VAE 解碼器。底層凍結嘅基礎模型會另外下載。整個微調流程用單張消費級 GPU 少於一星期就完成到,對個人開發者同細型實驗室都係可觸及嘅範圍。

程式碼結構清晰,方便二次開發:倉庫用 manifest graph 加 transform list 嘅方式定義數據集,網絡組件同損失函數都係讀寫 batch dict 嘅有序步驟,數據集定義、網絡圖、損失圖、優化排程四個層次分得幾開。對想擴展到新任務嘅人嚟講,只要跟住呢個結構加步驟就得,唔使由零砌起。

對比傳統多步擴散深度估計,Marigold V2 犧牲咗迭代式去噪嘅靈活性,但換嚟一步推理嘅速度同細節還原度;對比純監督方法,佢借用咗擴散模型對紋理同邊界嘅先天理解力,再加 LoRA 保持輕量。同一批權重仲可以用喺 metric depth completion 等下游任務,一個模型覆蓋多個密集預測場景。

**適合做 AR/VR、3D 重建、影像合成嘅中小團隊,或者想低成本試驗新密集預測任務嘅研究者,都會覺得呢個 setup 幾啱手。HuggingFace 上有對應嘅 demo 空間可以直接試,權重同訓練推理碼都已開源。

項目主頁 · GitHub · 模型

Categories: 開源, 華為, 模型, 模型訓練, Qwen, Image, 3D, , Dataset 數據集

OpenWAM-α 把世界模型與動作模型拆開重組

來自XPolicyLab等團隊的開源研究棧OpenWAM,把世界–動作模型(World-Action Models)拆解成可替換模組,並以約6,400小時第一人稱與機器人資料訓練出OpenWAM-α,在八個模擬基準與真機實驗均取得頂尖表現。

OpenWAM

如果你是做機器人策略或世界模型研究,大概都有過這種經驗:想換一個視覺編碼器、想試不同動作頭的耦合方式,結果整個訓練流程都要重寫,因為生成骨幹、視覺表示、架構、推論步驟和訓練資料全綁在一起。OpenWAM正是針對這種「綁死」的痛點而來。它是一個開源研究棧,把世界–動作模型(World-Action Models,簡稱WAMs)的設計空間拆成可組合模組,並用統一介面串接訓練、推論、部署與評估。

這個項目分成三層。OpenWAM-Infra提供模組化基礎設施,讓研究者可以像堆積木一樣替換模型、表示、訓練與評估設定;OpenWAM-Study則透過控制變量實驗,回答三個核心問題:應該從什麼預訓練骨幹繼承知識、世界學習與動作學習如何耦合、以及兩者如何隨規模擴展。基於這些結論,作者訓練出OpenWAM-α,一個以約6,400小時(5.185億幀)第一人稱人類與機器人資料預訓練的開放模型,並在涵蓋單臂、雙臂到靈巧手的八個模擬基準,以及真機實驗中維持頂尖水準。

架構由Hydra配置檔驅動,預設採用wan22 ti2v 5B作為影片骨幹,並搭配獨立的動作頭(如ActionDiT或共享動作骨幹),視覺編碼器則可在VAE、DINOv3、V-JEPA 2.1之間切換。基準測試覆蓋RoboTwin、LIBERO、LIBERO-plus、RoboCasa365、RoboCasa GR1、VLABench等主流環境,研究者可以直接用提供的評估客戶端跑對比。

  • 定位:開源研究棧,專門解決世界–動作模型設計選擇難以分離比較的問題
  • 核心貢獻:把生成骨幹、動作頭、視覺表示等模組化,並用控制實驗歸納出三條設計原則
  • 預訓練模型:OpenWAM-α基於約6,400小時第一人稱與機器人資料訓練,在八個模擬基準及真機均表現頂尖
  • 適用對象:機器人策略學習、世界模型研究團隊,以及需要可重現基準對比環境的從業者
  • 配套資源:模型已上傳Hugging Face,並提供完整的訓練、推論、部署腳本

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港大學, 模型, 世界模型, 模型訓練, Video, World-Action Model, , Dataset 數據集

TANGO:人形機器人穿越凌亂房間,全靠語言指令

TANGO 是一個讓人形機器人聽到自然語言指令後,自動調整手腳、軀幹與步態避開雜物的全身控制框架,可以理解成把機械人導航從「會走」升級成「會穿過沙發底下」。

TANGO architecture and data-generation pipeline.

如果叫一部人形機械人從客廳走到廚房,但途中堆滿紙箱、雜物、窄縫,一般導航演算法只懂「規劃路徑」,對它來說幾乎等於廢武功,因為雙腳、雙手、腰部其實要邊行邊配合地形郁動。TANGO(whole-body Vision-Language-Action model)正正為這種場景而設計:收到一句自然語言指令,加上前置與向下望的 RGB 影像後,模型直接輸出 29 個自由度(29-DoF)的全身關節角度,配合 6D 底盤旋轉表示,令機械人能夠一邊行、一邊擺手收腹避開障礙。

訓練數據全部來自模擬器,背後有一套名為 Plan-Edit-Track 的流水線:先用全局路徑規劃,再做全身逆向運動學(Kinematics)動作生成,接住用障礙感知編輯避開擺位,最後用強化學習追蹤確保動作真實做得出嚟。訓練集基於 VLNVerse 與 SAGE-3D 場景,再加入側向、貼地、頂部等多類障礙,務求貼近真實家居亂況。

TANGO💃🏻 Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model

模型結構本身亦幾講究:底層係一個 70 億參數(7B)的視覺語言骨幹,配搭一個用 flow-matching(流匹配)訓練嘅 MM-DiT(Multi-Modal Diffusion Transformer,多模態擴散 Transformer)動作專家,再加一個低階全身追蹤器負責即時執行。部署時 VLA(Vision-Language-Action,視覺語言動作)模型喺伺服器低頻運行,追蹤器喺機械人 onboard 高頻運行,做到實時反應。

實驗結果方面,TANGO 喺模擬與真機測試都提升咗語言導航表現,最重要係零樣本遷移(zero-shot transfer)直接落 Unitree G1(宇樹 G1)人形機械人,唔使額外真實數據再訓練。對研究 VLA、機器人導航或人形機械人部署嘅團隊嚟講,呢套 pipeline 連數據生成到模型結構都幾值得拆解。

重點摘要:
– 語言指令直接對應全身 29-DoF 動作,涵蓋手、軀幹、步態協調
– Plan-Edit-Track 流水線全模擬訓練,配合 VLNVerse 與 SAGE-3D 場景生成
– 採用 7B 視覺語言骨幹 + flow-matching MM-DiT 動作專家雙模組設計
– 伺服器跑 VLA、機械人 onboard 跑追蹤器,支援實時控制
– 零樣本遷移至 Unitree G1,無需真實訓練數據

項目主頁

Categories: 香港大學, 模型, 視覺模型, 多模態模型, 模型訓練, Video, VLA, Robotic, 框架, Dataset 數據集

anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, , 語音, Anthropic, 動畫, Skill 技能

ComfyUI 眼睛方向 LoRA:用紅點指定角色視線

呢個 LoRA 透過畫面上嘅紅點控制眼睛睇邊度,無論寫實、動漫定 CG 角色都適用。

喺生成角色圖像嘅時候,好多人會發現想控制眼睛視線方向係一件好頭痛嘅事:用 prompt 寫「望鏡頭」或「望向左邊」往往效果不穩定。Eric Venti Seeds 推出嘅 Eyes Direction LoRA,以 black-forest-labs/FLUX.2-klein-9B 作為基礎模型,提供咗一個更直接嘅操作方式——只要喺畫面擺放一個紅點,眼睛就會自動望過去。

呢個 LoRA 嘅運作邏輯係參考圖像入面紅點嘅位置嚟決定瞳孔方向。紅點放喺正中間,雙眼就會望鏡頭,無視身體姿勢;紅點貼近畫面邊緣,視線就會偏向畫框外面。訓練時已包含人眼活動嘅物理極限,所以當紅點放喺「唔可能」嘅位置時,模型會將瞳孔隨機處理。LoRA 採用 MIT 授權,總檔案大小約 258 MB。

為了方便擺放紅點,作者額外開發咗 ComfyUI 專用嘅 Eyes Direction Control node,可以直接拖動紅點預覽效果。如果唔用 node,手動用 Photoshop 整張紅點圖都得。LoRA 同時保留咗原本瞳孔形狀同虹膜顏色,所以風格唔會走樣。

重點摘要

  • 基礎模型:black-forest-labs/FLUX.2-klein-9B
  • 控制方式:以畫面紅點位置決定眼睛視線方向
  • 相容風格:寫實、動漫、CG、漫畫、油畫都適用
  • 配套工具:ComfyUI Eyes Direction Control node,可手動拖動紅點
  • 已知限制:動物眼睛效果差,極端頭部角度或異色瞳情況處理唔穩定

項目主頁 · 模型

Categories: 開源, ComfyUI, 模型, Stable Diffusion, Image

CosmoH2G 將人手示範轉成機械夾具軌跡

CosmoH2G 針對旋轉、翻轉等複雜空間動作,把人手示範轉換成機械夾具可執行的軌跡;其資料集包含 6,189 組配對示範。

dataset

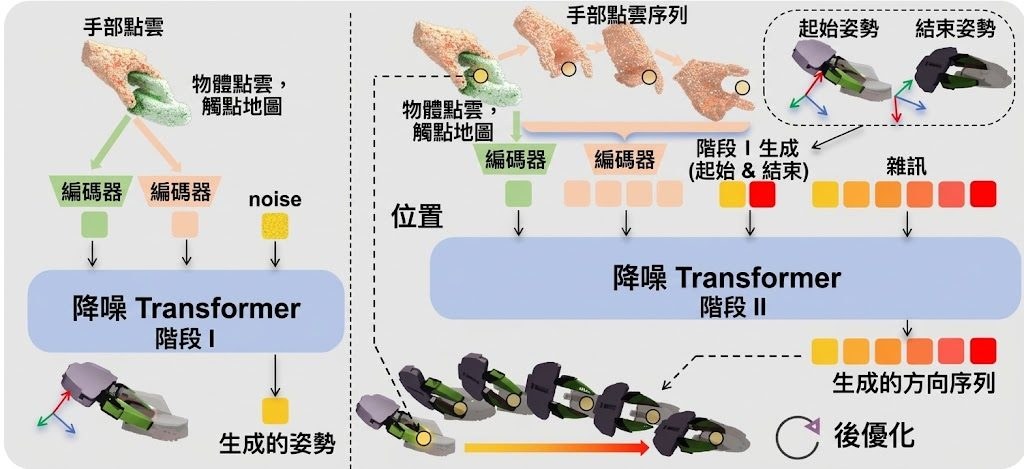
人手示範雖然直觀,但當動作包含旋轉、翻轉或複雜空間路徑時,機械夾具往往難以直接模仿。CosmoH2G 是一套面向機械人操作的資料集與基準方法,專門處理 hand-to-gripper transfer:研究團隊同步記錄人手和手持機械夾具的動作,建立可配對的 RGB-D、3D 物件點雲、手部網格及夾具動作資料。

資料集共有 6,189 個配對示範、涵蓋 1,254 件物件,規模足以支援複雜空間操作的研究。與只適合平面移動的做法相比,CosmoH2G 把重點放在細緻的手部姿勢和空間運動,並以手持夾具示範減少人與機械裝置之間的動作轉換落差。

方法分兩階段處理完整軌跡。Stage I 先預測起點和終點等稀疏關鍵幀,把複雜動作濃縮成較容易學習的目標;Stage II 再以關鍵幀為條件生成連續的夾具姿態序列。系統亦保留夾具姿態的學習結果,再利用抓取啟發式與運動學一致性修正位置,減少旋轉和翻轉過程中的累積偏差。

在模擬及真實機械人實驗中,能穩定轉移旋轉等複雜動作,並明顯勝過傳統基準。適合研究機械人模仿學習、操作資料集、3D 手部追蹤,以及需要處理非平面夾具運動的團隊。程式碼和資料集在項目網站標示為即將推出,現階段較適合先評估方法和收集流程,部署細節仍要等官方發佈。

  • 6,189 組人手與夾具配對示範,涵蓋 1,254 件物件。
  • 專注旋轉、翻轉和其他細緻空間軌跡,而非平面搬運。
  • 兩階段先學關鍵幀,再生成完整連續動作。
  • 以抓取啟發式和運動學一致性降低累積漂移。
  • 適合機械人模仿學習、資料集研究及操作策略開發。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 視覺模型, 模型訓練, Robotic, 3D, Dataset 數據集

Page 4 of 153
1 2 3 4 5 6 153