h3-motion:沿路徑移動照片主體並重生成影片局部

沿路徑移動照片主體,或為影片局部加上遮罩再重新生成;h3-motion 透過自架 ComfyUI 串連影像理解與動畫模型。

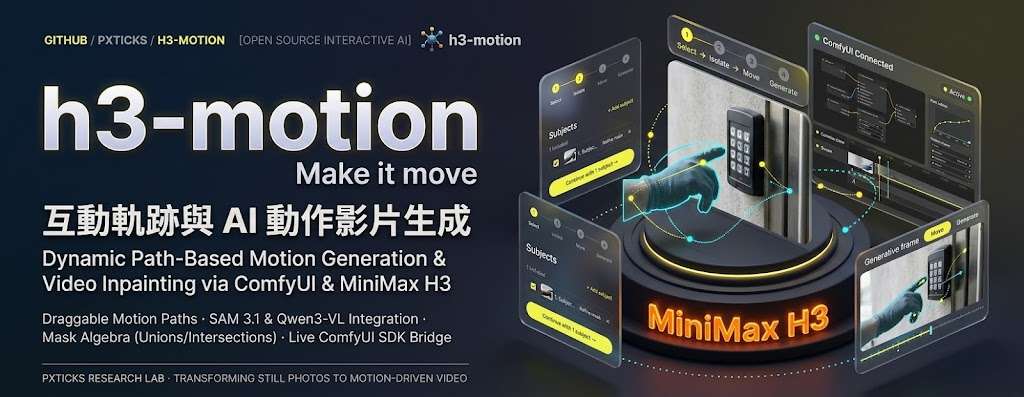
Select step: a gloved hand picked out with SAM 3.1

想沿路徑移動照片主體,或只重做影片局部,h3-motion 把兩種編輯流程整合在獨立 React app,透過 Comfy SDK 操作自架 ComfyUI。流程只用開放權重模型,不依賴 Comfy Router、合作夥伴節點或封閉 API。

照片流程以 SAM 3.1 選取主體,並可用點擊修整遮罩;Qwen3-VL 描述主體,Qwen Image 2.1 清除主體並補回背景。使用者設定路徑、大小或翻轉後,由 MiniMax H3 透過 Time-to-Move 生成動畫與聲音。
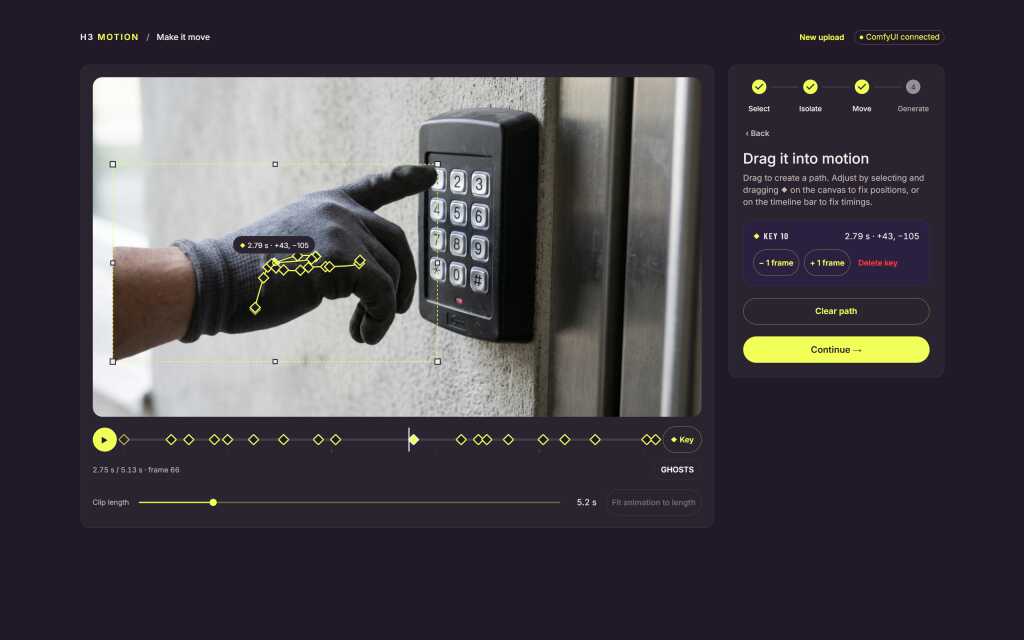
影片可用矩形或橢圓標出範圍,設定 keyframe 路徑或讓遮罩跟隨物件,並加入描述及可選參考圖。H3 重生成遮罩區域後,由 app 合成回原片;原有聲音可保留、參照或替換。

  • 照片:主體分割、背景清除,再沿路徑生成動畫。
  • 影片:局部遮罩、路徑或物件跟隨,並合成回來源影片。
  • 模型串連 SAM 3.1、Qwen3-VL、Qwen Image 2.1 與 MiniMax H3。

需要 NVIDIA 或 AMD GPU、近期 ComfyUI、ComfyUI-vlo 0.3.0 或更新版本,以及 Node.js 22.12 或更新版本;原生 Windows 尚未測試。文件未提供速度或畫質評測,較適合熟悉 ComfyUI、需要精細編輯影像局部的創作者。
GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, NVIDIA, API, Video, Image, Audio, Content Creator, 動畫, MiniMax

HDR mini-skill 讓 AI 片由 SDR 轉為 HDR

纯 ffmpeg + 自己生成的 3D LUT,不依赖 zscale / libplacebo / drawtext(Homebrew 的 ffmpeg 常常没带)。

Repository image for limin112/min-skill

把普通(SDR)視頻或其中一段,轉成 10-bit HEVC / HLG / BT.2020 的 HDR 文件:在 HDR 屏幕上,雲、太陽、水面反光、 金屬高光會“發光”。還能做左右對比:同一個文件里左邊 SDR、右邊 HDR。

  • 輸出 HLG HDR、10-bit HEVC 及 SDR/HDR 對比片。
  • 效果取決於素材。 米色卡片、文字、PPT 這類畫面轉成 HDR 只是把“紙”變亮,不適合。
  • 只有在 HDR 屏(Mac XDR、iPhone)上用 QuickTime 才有效果;普通播放器里會發灰、紅偏橙,這是正常的。
  • 原片已經是 HDR 的,腳本會拒絕(退出碼 2)。
  • 沒在真正的 HDR 屏上做過觀感驗證,也沒驗證過上傳各平台後是否保持 HDR;詳見 SKILL.md 末尾“已驗證 / 沒驗證”。

GitHub

Categories: 開源, 文字轉語音, AI productions, 數字人, 模型, Video, 框架, 工具, Content Creator, 3D, 庫, 語音, Anthropic, MiniMax, Skill 技能, LoRA

CoSTA:壓縮語音生成序列,提升對話模型推理速度

語音對話模型可以先產生較短的語音 token 序列,再還原成原有格式的合成波形。CoSTA 在中英文基準測試中提升生成速度,並保留原有語音 tokenizer 和 decoder。

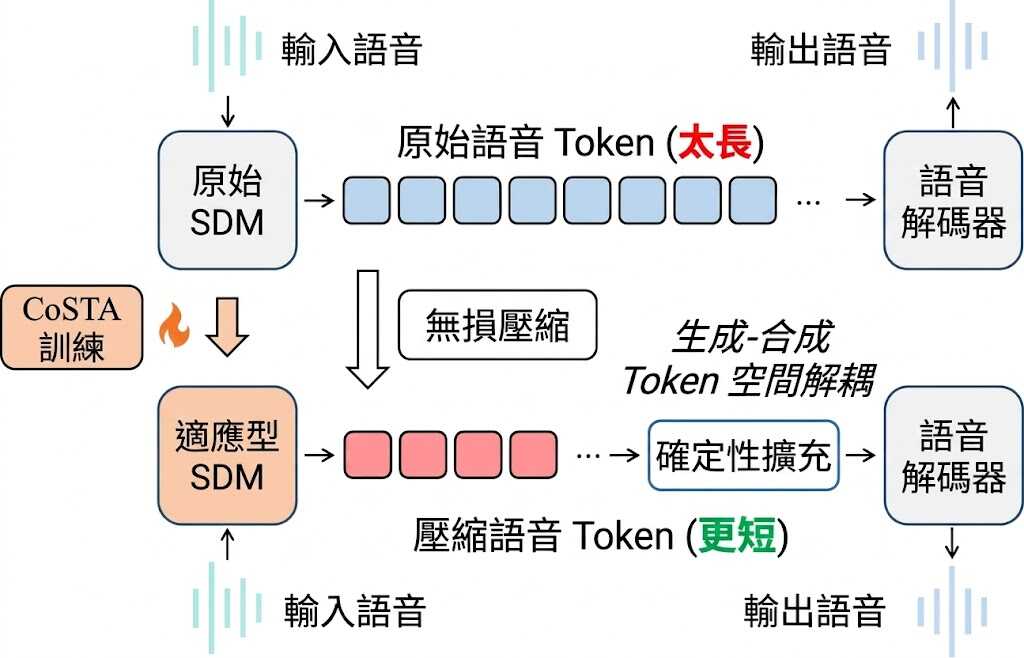
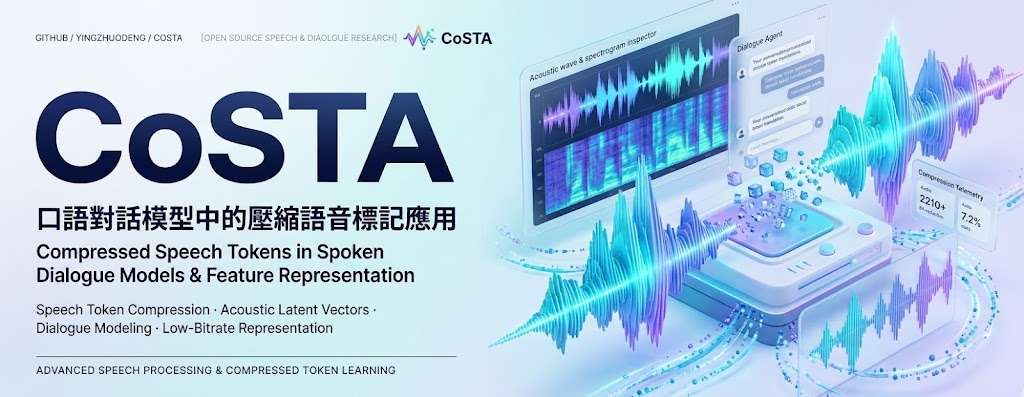
CoSTA separates compressed speech-token generation from original-token synthesis.

語音對話模型要逐個生成語音 token,序列較長時會拖慢回應。CoSTA 是一套語音模型適配方法,透過壓縮生成序列加快推理,同時保留原有語音 tokenizer 和 decoder,讓壓縮後的 token 可在合成波形前還原。

CoSTA 使用 byte-pair encoding(BPE)學習合併語音 token,並以原有 token 的 embedding 和 LM head 權重平均值初始化新增詞彙。適配分階段進行:先訓練發音,再調整語音對話輸出,讓模型生成交錯的文字與語音內容。它改變的是生成時使用的 token 空間,而非取代負責語音合成的原有元件。

在中英文基準結果中,CoSTA-ZH 的壓縮序列保留原 token 數量的 66.81%,擴展後語音 token 生成速度為每秒 101.99 個;CoSTA-EN 分別為 70.17% 和每秒 99.05 個。兩者相對 Step-Audio 2 mini 的速度為 173.63% 和 165.94%;這些結果反映特定基準測試,不能直接當成所有模型或硬件上的延遲保證。

對已有語音對話模型、希望提高回應速度而不重建語音合成流程的研究團隊,CoSTA 提供了一條可評估的適配路徑。GitHub 提供程式碼與論文連結,但模型權重及資料集仍標示為即將推出,現有資訊亦未列出完整安裝及測試流程。

  • 壓縮自回歸生成用的語音 token 序列,再於合成前確定性還原。
  • 保留原有語音 tokenizer 和 speech decoder。
  • 中英文基準測試均報告高於 Step-Audio 2 mini 的生成速度。
  • 權重與資料集尚未提供,現階段難以直接復現完整流程。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Tokenize

AskStream:讓模型主動追問影片的缺失資訊

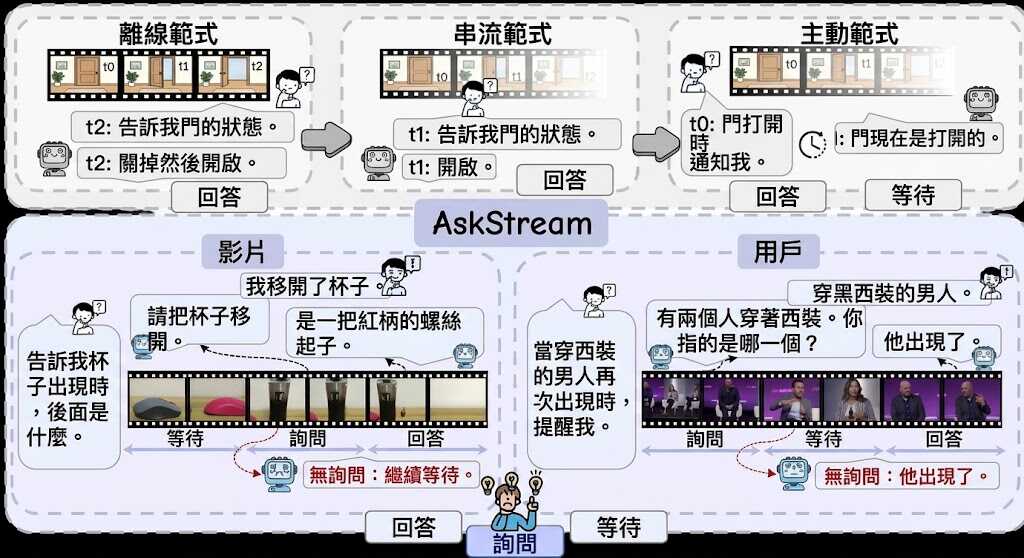
串流影片未必會自然提供完整答案,AskStream 讓模型在等待與回答之外,判斷何時應該主動提問。

AskStream Logo

串流影片問答遇到畫面缺失、問題含糊或個人資料不足時,模型往往只能繼續等待,甚至猜出答案。AskStream 是一個串流影片理解 benchmark 與資料集,把 WAIT、ASK、ANSWER 放進多輪互動流程,實際測試模型能否找出不確定性、問對問題,再在資訊足夠時回答。

它涵蓋 Food & Dining、Sports、Clothing、Daily Life、Film & TV、Repair、Education、Travel 和 Technology 九類影片,共 438 段影片、1,401 條問題,以及 2,714 個人工標註的 frame-level time windows。每段影片平均有 3.2 個互動回合,資料再按 Video Uncertainty 和 User Uncertainty 拆成四類任務、八個 subtasks,適合檢查模型是只懂回答,還是懂得主動索取缺少的證據。

  • 同時評估 When to Ask、What to Ask、When to Answer 和 What to Answer
  • 支援 multiple-choice 及 open-ended 評測
  • Ask-F1 同時反映提問時機、提問內容和回答決策
  • 最強模型目前只有 52.18% Ask-F1,主動尋找資訊仍然困難

使用者可從 GitHub、Hugging Face dataset、論文及 project page 了解資料和評測入口;提供的資料沒有列出完整安裝流程、推理程式或硬件要求,因此不能據此承諾特定 GPU、記憶體配置或本地執行方式。研究團隊、影片理解模型開發者和多模態 agent 評測項目較適合採用它,尤其是需要處理直播、教學、維修或含個人背景問題的場景。它的價值不在單次答案準確度,而在揭示模型何時應該停止等待、向誰問甚麼,以及取得資訊後能否及時作答。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 多模態模型, Video, 教學, 中國, Dataset 數據集

WeVisCut 單一 9B 模型自主剪出多分鐘知識影片

由文章或旁白稿生成多分鐘影片,WeVisCut 讓模型逐步選擇剪輯工具,並可在時間線上修改成片。運行 9B 模型約需 24 GB NVIDIA GPU。

WeVisCut

把知識文章或旁白稿變成多分鐘影片,通常要處理分段、鏡頭、配音、素材、字幕和配樂。WeVisCut 是一個長流程影片剪輯 Agent,由單一 9B 模型讀取剪輯狀態,每次呼叫一項工具,逐步完成製作;它處理的是長篇內容轉成可編輯成片的流程,而非只生成單一畫面或短片段。

模型不依照寫死的階段流程前進,而是按當前狀態決定下一步;防護規則只會拒絕不合法的操作,不會代替模型選擇。每次任務通常約有 12 次工具呼叫,涵蓋文章分段、鏡頭規劃、語音合成、素材檢索、動畫模板、配樂、檢查、修正及合成。檢查與反思本身也是工具,模型可按檢查結果修補未達要求的部分。

Studio 提供八條同步時間軌,成片完成後仍可手動編輯,也支援暫停與續做、聊天修改、單鏡頭重製及版本回退。這讓內容團隊能把它用作長篇解說影片的初剪與修改工作台;成片仍需要人手確認素材、旁白和敘事是否合適。要運行 bf16 9B 模型,項目列出的硬件需求約為 24 GB NVIDIA GPU;只開啟介面、不執行模型則不需 GPU。資料未提供完整安裝及素材服務設定流程,不能只憑這些資訊判定部署所需的全部硬件與外部服務。

評估使用 100 項保留任務,整體分數為 90.5;項目亦報告,每分鐘成功輸出的生成 token 數約比 Claude Opus 5 少 33 倍。這些數字反映項目設定下的測試結果,不足以單獨證明不同影片類型或工作環境都能得到同樣成效。訓練資料則由 3,750 個完成影片項目還原剪輯意圖,再經驗證重播整理出 134,771 個訓練例子;開放的資料建構流程可供研究長流程工具操作的團隊參考。

  • 輸入知識文章或旁白稿,輸出多分鐘剪輯影片。
  • 單一 9B policy 每次呼叫一項工具,按編輯狀態自行規劃後續動作。
  • Studio 保留可編輯時間線,支援逐鏡修改與版本回退。
  • bf16 9B 模型約需 24 GB NVIDIA GPU;純介面模式毋須 GPU。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, 工具, 語音, Anthropic, 動畫

WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

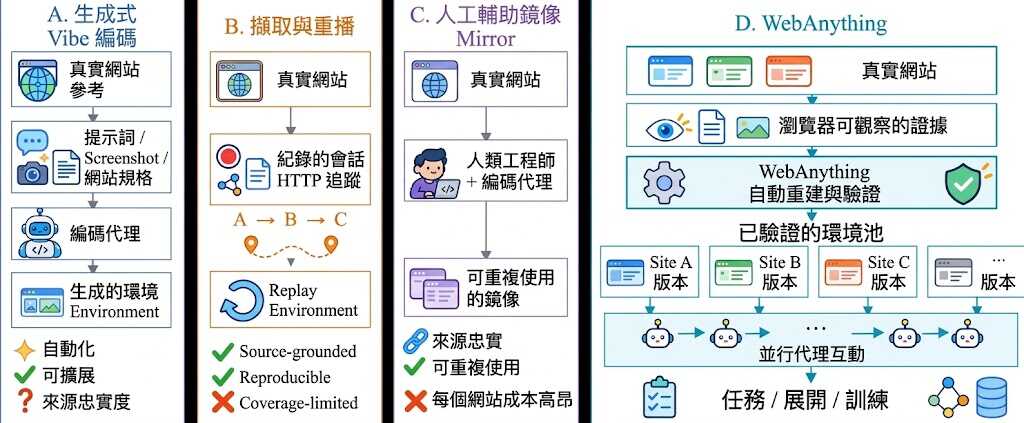
要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

VibeGame:把文字變成可試玩的遊戲

輸入遊戲構想後,VibeGame 會協調代理製作、審查及試玩,亦可按後續要求修改;目前聚焦 2D 網頁遊戲。

VibeGame system teaser

把文字構想變成可玩的 2D 網頁遊戲,再逐步修改玩法,是 VibeGame 這套多代理開發系統的工作。它適合遊戲原型製作,並非獨立模型;已開源的實作以 Phaser 為基礎。

Adversarial Agent Team 由統籌代理協調分工,將生成與審查分開,透過靜態審查及端到端執行驗證檢查成果。AI-native game engine 把項目表示為結構化文字,讓代理直接編輯,並以 frame-synchronous control 按自己的節奏逐幀試玩。

  • 支援 Claude Code 或 Codex,至少需要一款代理命令列介面(Command-Line Interface,CLI)。
  • Python 需要 3.12 或以上;未提供完整安裝流程。
  • 未列出處理器、記憶體、顯示卡或顯示記憶體需求,不能據此判定硬件門檻。

training-free self-evolution 會從成功項目提煉可重用骨架、模組及協作約定,累積開發知識而毋須重新訓練模型。示範涵蓋格鬥與地牢遊戲,但未提供量化成功率或效能比較;端到端 3D 製作仍屬待完成項目。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, 3D, Python, Anthropic

L3G-World 可以連續生成長達數分鐘影片

L3G-World 把單張影像、文字提示和鏡頭路徑接成可持續探索的 3D 世界,重點在長片段一致性與生成速度。

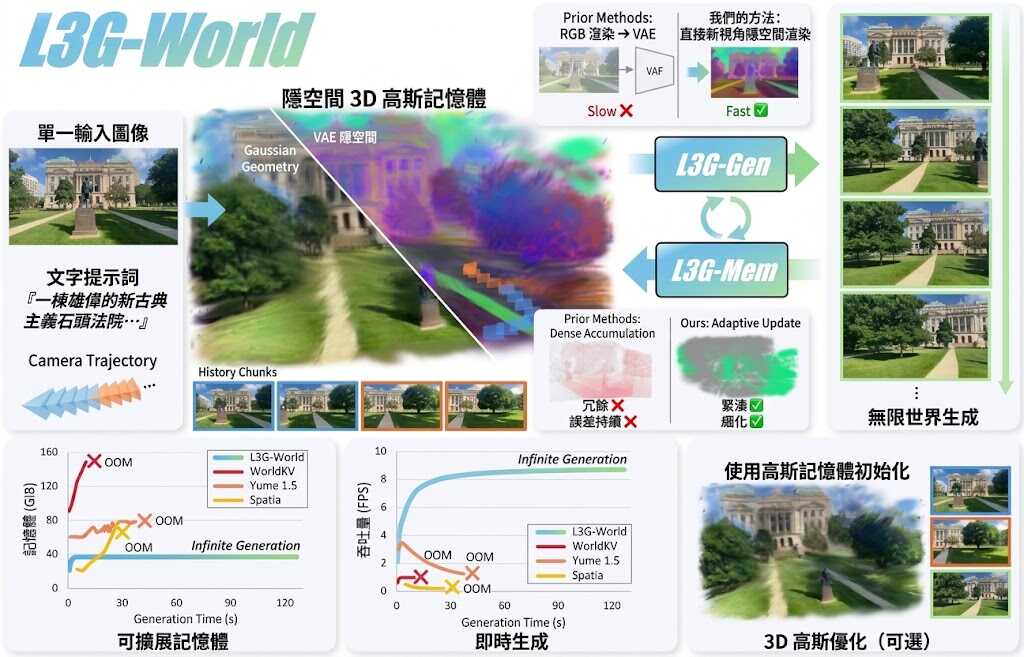
L3G-World overview: input images, text and cameras initialize latent 3D Gaussian memory; L3G-Mem updates the memory whil

由單張影像、文字提示和鏡頭路徑開始,L3G-World 可以連續生成長達數分鐘、視角一致的影片。它屬於世界模型及視頻生成模型項目,針對長時間生成容易失去場景結構、記憶不斷膨脹的問題,加入可持續更新的 3D 記憶。

L3G-Mem 會在新探索區域建立 Gaussian,重訪舊區域時則修正原有幾何資料;L3G-Gen 再利用更新後的記憶,自回歸生成下一段影片。每個 Gaussian 儲存 VAE latent,直接渲染到 diffusion 的 latent space,省去先渲染 RGB、再重新編碼的步驟,配合 few-step video model,目標是支援即時生成。

  • 長時一致性:影片片段會共享持續更新的 3D memory。
  • 記憶增長受控:記憶量跟隨探索範圍,而不是單純跟隨影片幀數增加。
  • 多視角探索:支援單張影像或少量多視角輸入,沿不同 camera trajectory 延伸場景。
  • 速度取捨:直接 latent rendering 減少重建成本,但項目仍屬研究原型。

對需要從影像建立可探索場景的研究團隊、世界模型開發者、機械人和虛擬環境項目較有參考價值。相比每段影片獨立生成的做法,它把場景記憶放入閉環流程;代價是需要同時處理 3D Gaussian 記憶、latent rendering 和擴散模型,工程整合較複雜。

項目首頁展示了 minute-long generation、不同鏡頭路徑和多視角場景延伸,但未提供明確的 FPS、GPU 型號或 VRAM 要求。儲存庫列出的 L3G-Mem、L3G-Gen、推理程式及 Fast checkpoints 仍在發布計劃中,因此目前只能按公開展示理解能力,未能據此確認安裝流程、所需硬件或可直接部署程度。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Video, Image, World-Action Model, 3D, 庫

OpenCode V2:程式碼探索與修改兩種模式

新功能加入 /goal,能持續目標驅動循環(自主執行直至目標完成)。接手陌生程式碼時,OpenCode 會先協助分析,再切換至開發模式;但模型配置與硬件門檻仍未交代。

OpenCode logo

V2 連續 3 日更新!OpenCode 能在接手陌生程式碼時,先讓 OpenCode 分析結構及規劃修改,再交由開發模式處理。這個開源 AI 編程代理工具以不同權限配合工作階段,並非獨立模型。

很多時,開發技術差異在於代理模式:預設 build 具完整存取權,負責開發;plan 則以唯讀方式探索程式碼,執行 bash 指令前會要求批准。兩者是操作模式,不是兩款模型。

  • build 適合需要修改程式碼的開發工作。
  • plan 適合熟悉陌生儲存庫及規劃變更。
  • 可透過 npm、Homebrew 等套件管理器安裝。
  • 另有桌面應用程式測試版,可於 opencode.ai/download 下載。

需要先審視再修改程式碼的開發者,可考慮這套分工方式;選用前仍須確認模型配置與運算需求。安裝前亦應移除早於 0.1.x 的版本。

GitHub

Categories: 開源, 模型, 工具, 庫, 編程

XR Blocks:把構想變成可互動空間

先在電腦試玩,甚至可戴上頭戴裝置驗證互動,空間應用原型不必一開始就靠硬件測試。

Og image

想製作可伸手操作的立體教材或遊戲原型,XR Blocks 可配合 Gemini,把文字描述轉成延展實境(Extended Reality,XR)應用;它是開源框架,不是獨立模型。

框架以 WebXR、three.js 及 LiteRT.js 為基礎,整合環境感知、手部互動與物理效果。配套工作流把程式範本和專用系統提示交給 Gemini,減少模型自行猜測介面。

Build XR without code: XR Blocks is now in Google AI Studio
  • 教學:製作可操作的幾何模型與物理實驗。
  • 設計:快速測試空間介面及手勢互動。
  • 遊戲:驗證物件與雙手、環境碰撞的玩法。

Google AI Studio 支援在瀏覽器內建立及預覽應用,毋須先安裝本地開發工具。電腦可用 Chrome 執行模擬器;沉浸式測試則需要 Android XR 頭戴裝置,例如 Samsung Galaxy XR,以及支援 WebXR 的 Chrome 136 或以上版本。

原連結未能讀取完整內文,本文以官方文件補充;文件沒有列出最低記憶體或顯示卡要求,不能據此保證所有電腦都能流暢運行。

項目主頁

Categories: 開源, 模型, Google, Gemini, 框架, 教學, 工具

Page 4 of 118
1 2 3 4 5 6 … 118