OpenCode V2:程式碼探索與修改兩種模式 2026 年 10 月 30 日 Share to X Facebook Copy link 新功能加入 /goal,能持續目標驅動循環(自主執行直至目標完成)。接手陌生程式碼時,OpenCode 會先協助分析,再切換至開發模式;但模型配置與硬件門檻仍未交代。 V2 連續 3 日更新!OpenCode 能在接手陌生程式碼時,先讓 OpenCode 分析結構及規劃修改,再交由開發模式處理。這個開源 AI 編程代理工具以不同權限配合工作階段,並非獨立模型。 很多時,開發技術差異在於代理模式:預設 build 具完整存取權,負責開發;plan 則以唯讀方式探索程式碼,執行 bash 指令前會要求批准。兩者是操作模式,不是兩款模型。 build 適合需要修改程式碼的開發工作。 plan 適合熟悉陌生儲存庫及規劃變更。 可透過 npm、Homebrew 等套件管理器安裝。 另有桌面應用程式測試版,可於 opencode.ai/download 下載。 需要先審視再修改程式碼的開發者,可考慮這套分工方式;選用前仍須確認模型配置與運算需求。安裝前亦應移除早於 0.1.x 的版本。 GitHub Categories: 開源, 模型, 工具, 庫, 編程
XR Blocks:把構想變成可互動空間 2026 年 10 月 30 日 Share to X Facebook Copy link 先在電腦試玩,甚至可戴上頭戴裝置驗證互動,空間應用原型不必一開始就靠硬件測試。 想製作可伸手操作的立體教材或遊戲原型,XR Blocks 可配合 Gemini,把文字描述轉成延展實境(Extended Reality,XR)應用;它是開源框架,不是獨立模型。 框架以 WebXR、three.js 及 LiteRT.js 為基礎,整合環境感知、手部互動與物理效果。配套工作流把程式範本和專用系統提示交給 Gemini,減少模型自行猜測介面。 Build XR without code: XR Blocks is now in Google AI StudioWatch this video on YouTube 教學:製作可操作的幾何模型與物理實驗。 設計:快速測試空間介面及手勢互動。 遊戲:驗證物件與雙手、環境碰撞的玩法。 Google AI Studio 支援在瀏覽器內建立及預覽應用,毋須先安裝本地開發工具。電腦可用 Chrome 執行模擬器;沉浸式測試則需要 Android XR 頭戴裝置,例如 Samsung Galaxy XR,以及支援 WebXR 的 Chrome 136 或以上版本。 原連結未能讀取完整內文,本文以官方文件補充;文件沒有列出最低記憶體或顯示卡要求,不能據此保證所有電腦都能流暢運行。 項目主頁 Categories: 開源, 模型, Google, Gemini, 框架, 教學, 工具
oMLX:高效能推論伺服器 2026 年 10 月 30 日 Share to X Facebook Copy link 當搭配如 Claude Code、OpenClaw、Hermes Agent 這類每輪都發送巨大 Context / Tool Transcript 的 Coding Agent 時,oMLX 能直接命中快取,大幅縮短每輪等待時間。 在 Mac 跑編程助手,oMLX 可讓常用模型常駐記憶體,並從選單列管理服務。能使用 Mac 原生 MLX 的吞吐與批次處理。 它以連續批次處理(Continuous batching)配合分層鍵值快取(Key-Value cache,KV cache):常用區塊留在記憶體,冷資料以 safetensors 格式存入固態硬碟(SSD)。後續請求的前綴吻合便可重用,伺服器重啟後亦能恢復,但不代表任意改寫上下文都能免除重算。 可設定上下文長度限制。 記憶體不足時,按最近最少使用(Least Recently Used,LRU)策略移出模型。 管理介面支援手動載入及卸載模型。 硬件需 Apple Silicon Mac,並為模型及快取預留記憶體與 SSD 空間;來源未列最低容量、模型清單或具體測速,不能據此保證大型模型的速度。 安裝可從 Releases 下載 .dmg,拖入 Applications,並支援程式內更新。需要反覆處理相同上下文的編程工作較能受惠;SSD 快取節省重算,卻不能取代模型推理所需的記憶體。 GitHub Categories: 開源, 模型, 工具, Mac, 編程, Anthropic, 蘋果
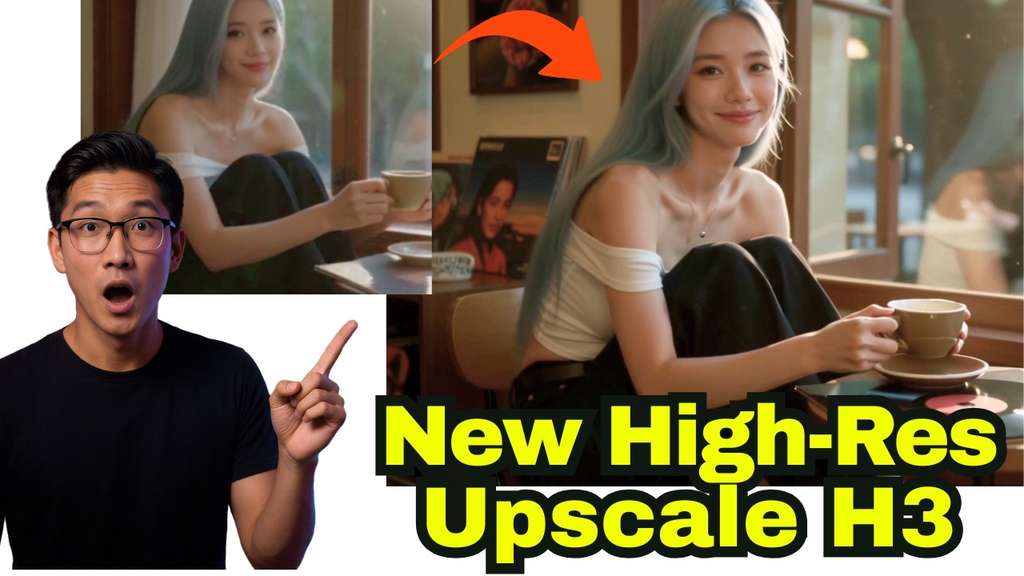
Open-H3-Regenerate-2K:把 MiniMax H3 影片提升至原生 2K 2026 年 10 月 30 日 Share to X Facebook Copy link [YouTube 影片]NVIDIA 的 Open-H3-Regenerate-2K 可在 ComfyUI 將 480p MiniMax H3 草稿提升至 2K,並提供兩種測試方法。 將 480p 影片提升至 2K,往往要在畫面細節、運算成本與輸出穩定性之間取捨。NVIDIA Open-H3-Regenerate-2K 把這項流程帶入 ComfyUI,針對 MiniMax H3 產生的影片草稿進行高解像度重建,適合需要改善輸出尺寸而又想保留原有動態內容的影像工作流程。 影片示範以三個步驟完成處理,並測試兩種方法,相關檔案亦附有連結。不過,提供的原始資料沒有列出具體工作流程、模型檔案名稱、安裝方式或硬件要求,使用者仍需按影片內容及項目檔案確認 ComfyUI 節點、顯示卡記憶體和運算時間。 將 480p MiniMax H3 草稿提升至原生 2K 影片 以 ComfyUI 組合 NVIDIA Open-H3-Regenerate-2K 流程 示範三步處理方式及兩種測試方法 適合影片生成後的放大、修復及高解像度輸出 硬件規格與安裝細節未在原始資料中提供 對內容創作者而言,這個項目可用於先以較低解像度製作草稿,再把選定結果交由高解像度流程處理,減少一開始便以 2K 生成所帶來的資源壓力。它較適合已經使用 ComfyUI、MiniMax H3 或 NVIDIA 影片模型工作流的使用者。 YouTube 影片介紹 Categories: ComfyUI, AI productions, 模型, NVIDIA, Video, Image, Content Creator, 安全, MiniMax
OmniShowcase:維持物件形態生成 360°影片運鏡 2026 年 10 月 29 日 Share to X Facebook Copy link 幾張多角度參考圖,就能引導 Wan2.1 生成沿不同鏡頭路徑移動的物件影片,並盡量保持外觀與立體結構一致。現階段程式碼與資料集尚未公開,硬件需求亦未交代。 想把一件商品或角色放進不同場景,再沿環繞鏡頭拍成影片,難處是視角轉到參考圖以外時,物件外形容易走樣。OmniShowcase 是一個影片生成模型項目,利用少量多視角圖片生成同一物件的影片,鏡頭路徑涵蓋完整 360° 環繞,目標是維持物件身份與 3D 結構。 它以 Wan2.1 image-to-video 模型為基礎,透過輕量 LoRA 調整生成模型。流程會由四張參考圖重建物件,再渲染成一組表面法線圖作為條件;生成影片時,鏡頭不必逐格對齊這組法線圖,提示詞可指定其他運鏡路徑。這令模型能沿指定路徑生成影片,而不只是重播固定的旋轉角度。 Showcase-4K 是合成訓練資料集,涵蓋 12 種鏡頭運動及 88 種路徑配置。 ShowcaseBench 是評測資料集,提供影片對應的來源網格與鏡頭參數,方便檢查生成結果。 項目展示環繞、螺旋下降、弧線移動、推近及拉遠等運鏡;目前提供的資訊未列出量化評測分數。 訓練資料、評測集、推理程式碼及訓練程式碼均尚待公開,暫時未能按文件安裝或執行。 這種方法適合商品展示、角色視覺化及需要多角度鏡頭素材的內容製作,也可供研究多視角條件影片生成的團隊參考。代價是生成品質依賴參考圖的 3D 重建與表面法線條件。 項目主頁 · GitHub Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 提示詞, 3D, Dataset 數據集, LoRA
Ming-3.0-tts:0.5B 優化講東話語音合成、語氣控制! 2026 年 10 月 28 日 Share to X Facebook Copy link 需要複製聲線、調整情緒,或按劇本生成多角色對話時,Ming-3.0-tts 提供多種控制方式,並支援多種語言與方言。 要為短片配旁白、製作有情緒起伏的角色對白,或生成多角色 Podcast,Ming-3.0-tts 都提供相應能力。這個開源語音生成模型項目支援中文、英文等七種語言,以及廣東話和四川話兩種方言;使用者可克隆參考聲線、用文字描述設計音色,亦可用自然語言指示演繹方式。 支持中文、英文、德文、西班牙文、法文、韓文和日文語音,亦可選擇四川話或廣東話;語速、音高和音量也可以調整。項目提供兩個模型:0.5b 是 dense model,tiny 則是建基於 Ling V3 的 MoE model,總參數量為 7.9B、每次啟用 1.3B。只有 tiny 支援按劇本和參考聲線生成多說話者對話。 兩個模型各有取捨。0.5b 在廣東話 Base CER、ACC,以及部分情緒和屬性控制指標取得領先;tiny 在多項多語言、聲線相似度和播客測試中排名靠前。不過,部分歷史紀錄仍由 Ming-omni-tts 保持,例如播客 CER;tiny 的韓語準確度、音高控制和角色扮演指令遵循能力,亦列為後續改善方向。 模型支持聲線複製、自然語言控制及多角色對話。適合需要製作多語言旁白、有聲內容或角色語音的創作者和開發團隊;若工作依賴特定方言的聲線相似度,或要求穩定遵循複雜角色指令,仍應先用目標語料自行驗證。 可用文字設計語氣聲線或選用內置中英文聲線。 支援 14 種中文或英文語氣標籤,以及情緒、語速、音高和音量控制。 tiny 可按劇本生成多說話者對話;0.5b 不具備這項功能。 公開測試涵蓋方言、多語言、情緒、屬性控制和播客,兩個模型的領先項目各有不同。 ComfyUI 整合 項目主頁 · GitHub · 模型 Categories: 開源, 文字轉語音, 模型, Content Creator, 語音, 廣東話
Google Genie 4:即時探索與互動世界模型 2026 年 10 月 28 日 Share to X Facebook Copy link Genie 4 可按文字或圖像提示生成可探索的 3D 世界,讓研究人員測試 AI 如何在變化中的環境裡理解場景和採取行動。 輸入一段描述或一張圖像,AI 便能生成可探索的 3D 世界,並隨玩家的操作即時改變場景。Google DeepMind 推出的 Genie 4 是一個世界模型研究項目,目標是建立能模擬環境、回應互動場景,為訓練和研究具身 AI 提供測試空間。 Genie 4: A new generation of world simulationWatch this video on YouTube 這類場景並非預先錄製的影片:玩家可以移動和探索,模型則持續生成後續畫面。研究人員可藉此觀察 AI 能否掌握環境的空間關係,並在多種情境中持續採取合適行動;不過,生成結果能否長時間保持一致,仍是世界模型需要面對的挑戰。 Genie 4 延續 Google DeepMind 的 Genie 系列研究。官方介紹聚焦於模型生成互動世界的能力,但未提供足以比較不同模型的完整量化評測,因此不宜單憑展示內容推斷它已能穩定支援所有模擬或訓練工作。 可由文字或圖像提示生成可探索的 3D 世界。 場景會隨玩家輸入即時變化,而非只播放固定影片。 可用於研究 AI 的場景理解與行動能力。 長時間維持世界一致性的能力及量化表現,仍需更多資料評估。 對具身 AI、遊戲環境生成和世界模型研究者而言,Genie 4 提供一種建立互動測試場景的方向;一般使用者則可透過生成世界,直觀感受模型如何把提示轉化為可操作的環境。 項目主頁 Categories: AI productions, 模型, 世界模型, 模型訓練, Google, Video, Image, 3D
Work Agents 將數碼工作拆成可驗證成果 2026 年 10 月 28 日 Share to X Facebook Copy link 跨應用程式完成工作,不能只看模型答得對不對;Work Agents 把代理流程、能力與可驗證成果放進同一研究脈絡。 當 AI 要跨應用程式完成多步工作,交付可核實、能供後續使用的成果,比單次答對更重要。Work Agents 是配合調查研究整理的開源閱讀清單,收錄數碼工作代理的系統、訓練、環境、記憶、基準與官方資源,並非可直接安裝的代理軟件。 研究以工作持續性(work persistence)和工作開放性(work openness)描述工作條件,並分成對話(Conversation)、單一步驟(Atomic Action)、多步(Multi-step)、工作流程(Workflow)及工作區(Workspace)五類。它也梳理 foundation models(基礎模型)與 runtime harnesses(執行時框架)的單獨或協同優化,評估則聚焦成果能否符合要求並供下游使用。 你可由 GitHub 清單挑選論文、基準和工具;暫未有可直接執行的代理或統一安裝、測試流程,不能當成部署指南。 整理代理系統、訓練方法、環境與記憶研究 涵蓋五類數碼工作及相關評測資源 比較模型、執行框架及兩者的協同優化 以可驗證、能供下游使用的成果作評估焦點 產品團隊和自動化流程負責人可用它整理能力缺口與評測方法。清單沒有同一環境下的性能數字,具體效果仍要回到各研究與工具核實。 項目主頁 · GitHub Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, 框架, 香港, 軟件, 工具, 庫
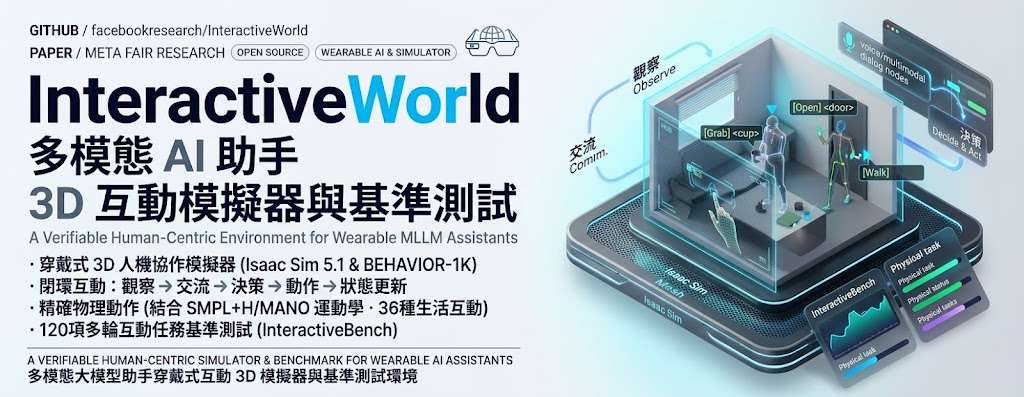
InteractiveWorld:把穿戴式 AI 助理放進可驗證的互動世界 2026 年 10 月 28 日 Share to X Facebook Copy link 穿戴式助理要看見甚麼、怎樣給建議,最後能否幫人完成任務,InteractiveWorld 把整段互動放進可持續變化的 3D 場景中測試。 穿戴式 AI 助理不只要辨認眼前物件,還要理解人的要求、給出可執行的指引,並跟進行動後的變化。InteractiveWorld 是一套以人為中心的 3D 模擬器,用第一人稱視角呈現環境,讓助理與模擬人物多輪互動;同一個儲存庫亦提供 InteractiveBench,用來比較多模態大型語言模型(MLLM)在這類任務中的表現。 場景涵蓋 44 個 BEHAVIOR-1K 家居及活動空間。助理以對話提供建議,模擬人物則根據所見自行決定行動;研究者可用簡短指令描述抓取、開門、倒液體等操作,由模擬器處理移動、避障、操作物件及更新場景。世界狀態會延續到下一輪,因此助理要根據新視角調整回答,而非只生成一次性的文字答案。 InteractiveBench 收錄 120 個固定的多輪任務,分為六類,每類 20 個。評分會檢查場景中的狀態是否達成目標,而不是單憑回答文字判斷;基準亦提供評估流程、報告及影片。首頁資料提到曾以 12 個前沿 MLLM 進行評估,但所提供的內容沒有列出各模型分數,無法據此比較排名或判斷差距。 • 模擬器可用 Python API 開啟場景、執行動作、取得觀察結果及原生分數。 • 場景與人物行動涵蓋物件操作、室內移動及第一人稱畫面更新。 • 基準任務固定,適合研究團隊比較模型在多輪助理情境下的完成能力。 • 安裝指南列明資產準備與環境需求;執行需要處理 Isaac Sim 場景及相關資產,並非只呼叫一個輕量 API。 這個項目適合研究穿戴式助理、多模態模型及具身互動的團隊,尤其是需要可重複測試、以環境狀態核實結果的工作。模擬場景能補足純文字評測看不到的行動後果,但仍不能完全代表真實佩戴裝置時的感測誤差、人的習慣差異或實體操作風險;評測結果應視為模擬環境中的能力證據。 項目主頁 · GitHub Categories: 開源, AI productions, 模型, 多模態模型, API, Video, 3D, Python, 庫, Meta, 蘋果
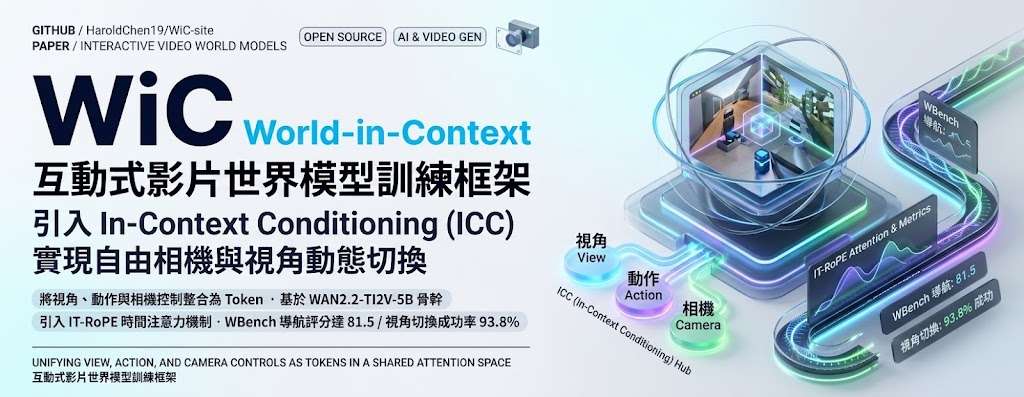
World-in-Context 讓世界模型即時切換視角 2026 年 10 月 28 日 Share to X Facebook Copy link 操控生成影片時,切換第一人稱、第三人稱與自由鏡頭,畫面仍要延續同一個世界。World-in-Context 以共享控制機制處理這項挑戰。 想在生成影片中移動鏡頭、改變觀看角度,甚至在第一人稱與第三人稱之間切換,畫面仍須保持連貫。World-in-Context(WiC)是為互動影片世界模型而設的訓練框架,目標是讓視角、動作和鏡頭控制在同一段影片中協同運作,而不是各自處理。 WiC 以 Wan2.2-TI2V-5B 作為基礎模型,透過 In-Context Conditioning(ICC)把視角、動作與鏡頭控制轉成共享注意力空間中的 tokens;Interaction-Transport RoPE(IT-RoPE)則把累積的控制變化納入時間注意力。這讓系統可支援自由鏡頭、第一人稱及第三人稱視角,也能在影片進行中切換,適合研究互動式場景生成、遊戲環境及長時間因果推演。 在 WBench 評測中,WiC 的導航平均分為 81.5,視角切換成功率為 93.8%。這些結果反映它能處理導航與鏡頭切換,但不能單憑分數判斷生成影片在所有場景都同樣穩定;GPU 記憶體需求亦會隨影片尺寸和設定改變。 目前程式碼、訓練程式及 WiC 權重仍在審核,尚未公開,因此現階段無法自行安裝並重現推理結果。計劃中的版本要求 Linux、Python 3.10,以及支援 BF16 的 NVIDIA GPU;預設生成設定為 832×480、81 幀、16 FPS 和 50 個採樣步驟,並預計提供 11 個包含起始圖片、提示詞與控制資料的範例。 以 Wan2.2-TI2V-5B 為基礎,加入 WiC adapter。 同一影片支援自由鏡頭、第一人稱與第三人稱視角。 WBench 導航平均分 81.5,視角切換成功率 93.8%。 程式碼與權重尚未公開,現時未能重現結果。 對研究影片生成、虛擬環境導航或互動遊戲場景的團隊而言,WiC 提供一條把鏡頭與動作控制合併訓練的路線;但在公開程式碼和權重推出前,這些能力仍主要停留在研究成果與展示範例,還不能直接納入工作流程測試。 項目主頁 · GitHub Categories: 開源, 阿里巴巴, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 提示詞, 框架, 3D, Linux, Python