Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

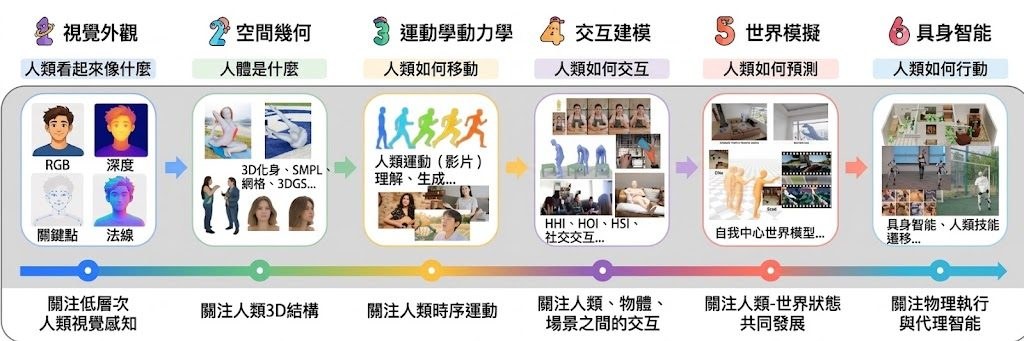
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者。
項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

資源庫並非可直接下載執行的模型或軟件,使用方式是瀏覽 GitHub 內容及項目首頁,按 Academic Knowledge、Research Infrastructure 和 Community Learning Hubs 等部分尋找材料。研究者亦可透過社群渠道提交或維護資源,因此內容會隨社群整理持續更新,但完整度和一致性仍取決於後續貢獻。

伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者,GitHub 資源庫和 survey 應該一併閱讀;只想立即執行模型或測試 API 的使用者,則需要另找具體實作項目。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

ClawGym:為 Claw 類代理搭建可訓練環境

ClawGym 讓本地、帶狀態的工作空間可用來合成資料、訓練代理同評估表現。你可以把它理解成一套面向 Claw-style personal agents 的研究與實驗框架。

Og image

ClawGym 把原本分散的代理開發流程收攏到同一個工作框架內,重點是處理本地、帶狀態工作空間中的任務生成、訓練同評測。對做 agent 研究或想驗證 Claw-style personal agents 的人來講,佢解決嘅唔係單一模型能力,而係點樣有系統咁建立可重複的實驗流程。

它嘅做法唔係只提供一個執行環境,而係同時涵蓋資料合成、agent 訓練同 benchmark 評估。令研究者可以用同一套基礎去跑不同任務,再睇代理喺有狀態工作空間入面表現有幾穩定。

幾個重點值得留意:
– 針對 local、stateful workspace,適合需要保留上下文同操作痕跡的任務
– 同時涵蓋 synthesized data、training 同 evaluation,減少流程分散
– 聚焦 Claw-style personal agents,而唔係泛用式聊天代理
– 已釋出 ClawGym-Bench 同 ClawGym-SynData,方便做對照測試同資料實驗

從公開資訊睇,ClawGym 亦一路延伸到更大範圍的 RL on general agent tasks,甚至可以透過 OpenClaw、Claude Code 呢類較複雜的 black-box agent harness 去做統一訓練。對想比較不同 agent 工作流、或者研究黑箱代理強化學習的人,佢提供咗一個較完整的基座。

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, 軟件, Medical醫學, 安全, OpenClaw, 中國, Dataset 數據集, Skill 技能

DeepSeek Harness 把 Agent 變成插件

DeepSeek Harness 想解決的唔係單一 Agent 功能,而係點樣把模型、工具同工作流拆開重組。對想長期調整 Agent 流程的團隊,呢個方向比單次 demo 更有參考價值。

Repository image for deepseek-ai/deepseek-harness

DeepSeek Harness 把 dsh 做成一個面向開發者的 Agent harness,重點不在於再包一層聊天介面,而是把模型、工具、技能、會話、沙箱、存儲、循環、調度同 UI 全部拆成插件,讓團隊用配置去換件、重組,同時保留可追蹤的執行過程。它處理的是 Agent 進入真實工作流後,經常要改工具鏈、換模式、查執行軌跡的維護問題。

你可以直接用 npx @deepseek-ai/dsh web 啟動 Web UI,也可以從原始碼安裝;兩種方式都指向同一件事:DeepSeek 並非只想交付一個可試玩的介面,而是提供一個可延伸的開發底座。現階段它仍屬 developer preview,兼容性破壞會持續出現,較適合願意跟住 API 與插件生態一齊迭代的團隊。

跟不少把能力寫死在框架內的做法相比,DeepSeek Harness 把 Cordis 放在核心位置,內核只負責插件載入、卸載與依賴關係,Agent 能力則交由插件之間透過服務與事件協作。好處是替換模型、工具或 preset 時毋須大改源碼;代價是系統理解成本較高,穩定性亦未到可安心鎖版的階段。

它提供標準模式、PTC 模式、極簡模式同創造模式,反映出同一套底層同時照顧編碼 Agent、基準測試同自訂 preset。當中較值得留意的是 Trajectory 視圖與僅追加式會話日誌,系統會記錄提示詞、工具調用、結果、子 Agent 調度與上下文注入,對除錯、回放、分叉同檢索都幾有用,但官方未提供明確基準分數,現時較難直接用量化結果同其他 Agent 框架比較。

  • 用 Cordis 作核心,將 Agent 各層能力拆成可替換插件
  • 可經 Web UI 快速測試,亦可由原始碼部署到自訂環境
  • Trajectory 與事件流日誌有助追查每一步決策與工具操作
  • developer preview 階段變動頻密,較適合開發者與研究型團隊
  • 重點價值在可組合工作流,而唔係單一模型能力展示

項目主頁 · GitHub

Categories: 開源, Agentic, DeepSeek, API, 工具, Skill 技能, UI/UX

S2R 用物理模擬解決影片反光

隔住玻璃拍片常見嘅反光,會令畫面難睇又影響後續辨識。S2R 把合成、去反光同評測串成一條流程,重點是先補足可信訓練資料。

Og image

隔住玻璃拍攝時,反光往往唔只影響觀感,仲會干擾偵測、辨識同追蹤等後續視覺工作。S2R 屬於影片去反光項目,重點唔係單靠清理單幀畫面,而是同時處理資料不足、時間連貫性同評測基準缺位三個卡位。

呢個項目用一個閉環流程連接 S2R-Synthesis、S2R-Removal 同 S2R-Benchmark。前段先以 Physics-Grounded Augmentation 與影片擴散生成方法合成成對影片,控制玻璃粗糙度、反射率、厚度等性質;後段再把 pretrained video diffusion prior 調整成適合去反光的模型,加入 reflection-aware latent adaptation 同 one-step pixel-geometric refinement,減少殘影並維持時序一致。

它跟常見做法最大分別,在於先把反光結構同外觀拆開處理。S2R-Synthesis 會從 FLUX-generated pseudo videos 學習較真實的反光外觀,再把兩段乾淨影片經 Physics-Grounded Augmentation 融合,生成可配對訓練資料,避免只靠傳統合成或少量真實資料,令模型較難學到穩定的影片反光模式。

  • 用物理約束方式合成反光影片,補足 paired video data 不足
  • 以 diffusion-based video dereflection 處理影片,強調跨幀一致性
  • 提供 S2R-Benchmark,兼顧 full-reference 評估同真實場景人類感知評估
  • 在 OpenRR-1k 的結果中,加入完整 PGA 後,PSNR 與 SSIM 都比基線再提升

現有資料顯示,S2R 特別適合需要穿玻璃拍攝的內容整理、監控視覺流程,或者任何重視畫面可讀性與後續分析品質的工作流。項目亦反映一個明確取捨:先花力氣建立可信的反光合成與評測系統,再用 diffusion-based 方法做移除,換來較完整的訓練閉環,但最終表現仍會受真實場景複雜反射型態影響。

項目主頁

Categories: Stable Diffusion, Video, Image, 框架, Dataset 數據集, 小米-Xiaomi

Grok Bot 登場:xAI 推出常駐 AI 同事,能自主操作電腦完成任務

Grok Bot 就像一隊永不登出的 AI 隊友,能登入你的軟件代勞長時間任務,從銷售外聯到支援工單都接力完成。

Og image

xAI 最新推出的 Grok Bot,把「Computer-use agents(CUAs)」這個概念包裝成一支可以分工的虛擬團隊。它擁有自己獨立運行的電腦環境,能像真人般登入 Zendesk 等 SaaS 工具、瀏覽網頁、操作軟件介面,並在背景 24 小時不中斷地接力完成任務。對需要處理大量例行工序的小團隊或一人公司來說,這類 agent 最直接的價值是把「等人按掣」的等待時間壓縮到接近零。

Grok Bot 強調幾個工作流設計:你可以同時叫多個 Bot 進入同一個對話串,分頭負責研究、公關、差旅等不同環節,Bot 之間會自行交接工作;只要你親自示範一次流程,它就能把步驟記成「routine」自動重複執行,並隨時間累積記憶,例如記下某客戶只簽年約、誰是決策人。對需要批量生成銷售名單、處理支援工單或長期追蹤項目進度的使用者而言,這種「邊做邊學」的能力比單純的 prompt 工具更貼近實際工作節奏。

定價方面,Grok Bot 綁定在 Cursor Ultra 月費 200 美元的方案內,包含其專屬電腦環境、跨裝置使用與排程執行;團隊版則額外提供 SSO 與共享用量分析。xAI 將其定位為企業 SaaS 的入口代理,但實際上能否取代 ClickUp、HubSpot 等內建自動化,仍要視乎它對接工具的覆蓋率與執行成功率。

重點摘要

  • 擁有獨立電腦,能像人類登入並操作 SaaS 工具完成長時間任務
  • 支援多 Bot 協作,在同一對話串內自行分工與交接
  • 用戶示範一次流程後,Bot 可記為 routine 自動重複執行
  • 隨時間累積記憶,保留客戶偏好、決策人等脈絡
  • 透過 Cursor Ultra(200 美元/月)方案提供,團隊版含 SSO 與共享分析

項目主頁

Categories: Agentic, API, 工具, 線上服務, IDE, Mac, 免費試用

NVIDIA Nemotron 3.5 Lightning:專為長期運行 Agent 而生的輕量 MoE 模型

AI Agent 大部分時間都在做工具呼叫、結果驗證等高頻次執行,而非高階推理。Nemotron 3.5 Lightning 以 30B MoE 架構瞄準這個執行層,速度比同級模型快 4 倍。

Og image

長期運行的 AI Agent 真正花時間的地方,往往不是規劃,而是工具呼叫、結果驗證、子代理分派這些高頻次的執行步驟。每一個小動作都用頂級推理模型去跑,會帶來明顯的成本與延遲壓力。NVIDIA 推出的 Nemotron 3.5 Lightning 就是針對這個「執行層」設計的開放模型,採用 30B 參數的 Mixture-of-Experts(MoE)架構,但每次只啟動 3B 參數,在維持效率的同時兼顧準確度。

與坊間常見做法不同,Nemotron 3.5 Lightning 並非要取代大型推理模型,而是與之分工——前者處理高頻執行,後者專注規劃與複雜推理。模型本身針對 agent harness(如 OpenClaw、Hermes Agent)做了訓練優化,並提供 speculative decoding、NVFP4 與 BF16 量化版本,宣稱輸出速度比同級模型快 4 倍。這對需要長時間在線、隨時待命的 Agent 來說,省下的不只是金錢,還有回應時間。

Nemotron Lightning - NVIDIA's Super Fast Agent MoE

NVIDIA 同時推出 NeMo Switchyard,一個負責任務分派的路由函式庫,能根據任務類型自動挑選最合適的模型。整個 Nemotron 系列定位有點像「模型版的軟件庫」,每次發佈都在累積可組合的元件。對於需要自己掌控成本與效能的開發團隊,這套組合提供了相當完整的權重、數據與訓練配方,加上寬鬆的開源授權,方便做深度客製化。

  • 專注 Agent 執行層:30B MoE 架構、3B 活躍參數,設計目標是高頻低延遲的工具呼叫與驗證。
  • 速度與成本取捨:相比同級模型,輸出速度提升達 4 倍,搭配 NVFP4 量化可在本地硬件運行。
  • 分層協作模式:與 Nemotron 3 Ultra 等大型推理模型分工,由 NeMo Switchyard 負責智能路由。
  • 完整開源:權重、訓練數據與配方一併釋出,授權寬鬆,方便客製與整合。
  • 生態整合:對應 NemoClaw 安全管理開源方案,支援 OpenClaw、Hermes Agent 等長期運行框架。

項目主頁

Categories: 開源, Agentic, 模型, NVIDIA, 軟件, , 安全, OpenClaw

free-claude-code:一個代理層打通 Claude Code 與 Codex

想保留原生開發代理體驗,又想自由換模型與供應商,free-claude-code 正正補上這個缺口。它把 Claude Code、Codex 同 Pi 接到同一個可管理入口。

用開 Claude Code 或 Codex 的人,最在意通常唔係再裝多一個聊天介面,而係可否繼續用原生 model picker、串流回應、tool use 同 image input,同時改用自己揀的模型供應商。free-claude-code 就係一個 proxy 工具,把 Claude Code、Codex、Pi 及其 IDE 擴充功能接到自管入口,處理多供應商切換同路由分發。

它的價值在於工作流幾乎唔使重學。你可以照用 fcc-claudefcc-codexfcc-pi 啟動對應代理,Windows 同 macOS 亦可放在背景執行,再到本地 Admin UI 揀選並驗證供應商。可在 31 個 cloud 與本地 providers 之間切換,亦可把 Fable、Opus、Sonnet、Haiku 同 fallback 流量分別導向不同模型,這點對想控制成本、速度同能力分工的團隊幾實用。

跟直接綁死單一 API 的做法相比,這個項目押注在「保留原生客戶端體驗,再用 proxy 抽換後端」。代價是相容性要靠代理層維持,所以它明確強調只會在兼容模型上保留 streaming、tool use、reasoning 同 image input;換句話說,模型可揀得更自由,但不是每個後端都保證功能完全一致。

  • 支援 Claude Code、Codex、Pi,同時保留各自原生 model picker
  • 透過本地 Admin UI 管理與驗證 31 個 cloud/本地 providers
  • 可把不同流量類型分流到不同模型,方便平衡成本與能力
  • 適合想用本地模型、付費模型或免費模型混搭的開發團隊

安裝與測試方式偏向開發者工具鏈:項目以 Python 3.14、uv、Pytest、Ruff、Ty 組成,部署重點不是雲端託管,而是先在本機跑起 proxy,再讓代理客戶端經它連線。現階段最適合已經在用 Claude Code 或 Codex、又想統一管理模型入口的人;追求零設定即用的讀者,會覺得它比較像一層需要自己維護的基建。

GitHub

Categories: 開源, NVIDIA, API, Image, 工具, IDE, Mac, Python, 編程, Anthropic, UI/UX

DeepSeek-V4-Flash 公測版重點更新

DeepSeek 把 V4-Flash 推上正式版 API 公測,焦點唔止係模型名稱更新,而係 Agent 工作流明顯變得更能打。對寫碼、自動化同工具調用有需求的人,呢次變更值得留意。

Og image

想用同一個 API 入口處理寫碼、自動化操作同工具調用,2026-07-31 呢次更新最值得留意。DeepSeek-V4-Flash 正式版已經開放 API 公測,調用方式維持不變,只要把模型名稱設為 deepseek-v4-flash,就可以切換到最新版本,對現有接入項目來講改動相對少。

今次更新的重點唔係介面改版,而係 Agent 能力明顯加強。官方列出的 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon verified 同 Automation Bench (Public) 等基準分數,都指向同一件事:V4-Flash 針對 Coding Agent、終端操作、工具使用同全棧開發場景做咗強化,而且公開測試成績已經高過 V4-Pro-Preview。

技術上,DeepSeek-V4-Flash-0731 的模型結構、尺寸都同 DeepSeek-V4-Flash-Preview 一致,更新集中在後訓練,意味住提升主要來自調整模型行為,而唔係換咗一個更大架構。它同時原生支援 Responses API 格式,亦有針對 Codex 做適配,對已經圍繞 API 建立 Agent 工作流的團隊會更易接入。

幾個重點可以直接整理如下:
deepseek-v4-flash 已可直接使用正式版 API 公測
– API 調用方式不變,現有項目遷移成本較低
– Agent 能力是今次更新核心,涵蓋 coding、terminal 同 tool use
– Responses API 已原生支援,並針對 Codex 做咗適配
– 今次只更新 V4-Flash API,DeepSeek-V4-Pro API 以及 APP/WEB 端模型未有改動

使用上亦要留意邊界。現有資料有提供模型名、相容格式同基準測試結果,但未見更完整的安裝步驟、下載方式或者端到端接入流程;另外,官方亦講明今次並未更新 DeepSeek-V4-Pro API。對想盡快把 Agent 能力接入現有產品的人,V4-Flash 呢次公測比較像一次低改動、偏向工作流升級的更新。

項目主頁

Categories: Agentic, 模型, DeepSeek, API, Vibe Coding, 工具, 編程

Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

Page 4 of 21
1 2 3 4 5 6 21