BILBY-MD:把蛋白質結構放入動力學驗證

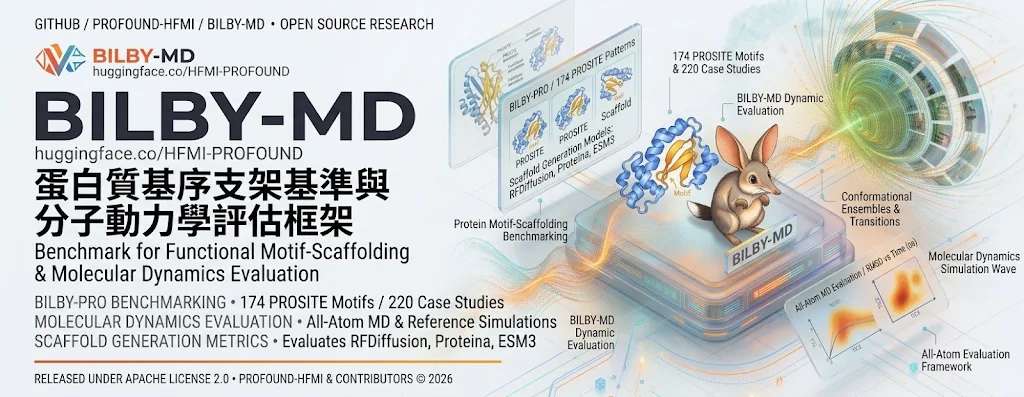
蛋白質設計模型交出穩定結構,未必代表 motif 在運動中仍然可靠。BILBY-MD 以分子動力學補上這一步。

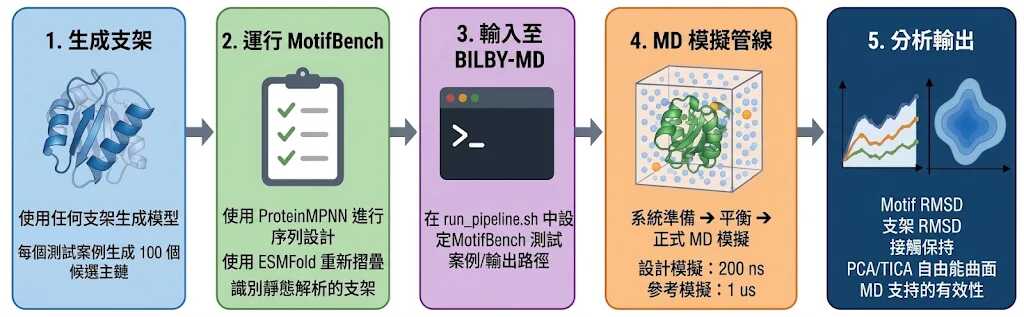
BILBY-md workflow

蛋白質是由一串氨基酸摺疊而成的微型機器。其中真正負責「幹活」(比如咬住病毒、催化化學反應)的關鍵核心區域,叫做「基序」

過去 AI 的兩大痛點,題目又少又偏心:以前大家都只拿少數幾題、人工精心挑選過的基序來考 AI,根本看不出 AI 的真實全面實力。為了徹底解決上面兩個盲點,作者直接推出了兩套工具:

BILBY-PRO(超大規模的標準試卷庫):
不再人工挑偏門題目,直接從權威資料庫(PROSITE)系統性撈出 174 類、共 220 道真實有功能的結構基序大考題,全面普查各家 AI。結果令 RFDiffusion 和 Proteina 變成「答題王」:能解開的題目最多、覆蓋率最高。

BILBY-MD(動態全原子模擬裁判):
這就是前面提到的 BILBY-MD!它是一套「全原子分子動力學(MD)模擬考評框架」。

它不再只看靜態模型,而是把 AI 設計出來的蛋白質直接丟進模擬水溶液中「實測運轉一陣子」,看它在分子震盪動態下,那個關鍵基序是不是還能穩穩固定、結構會不會垮掉,用最嚴苛的動態標準給 AI 打分數。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, DeepSeek, 框架, 軟件, Dataset 數據集

SplatAnything:用 3DGS 重建不同尺度場景

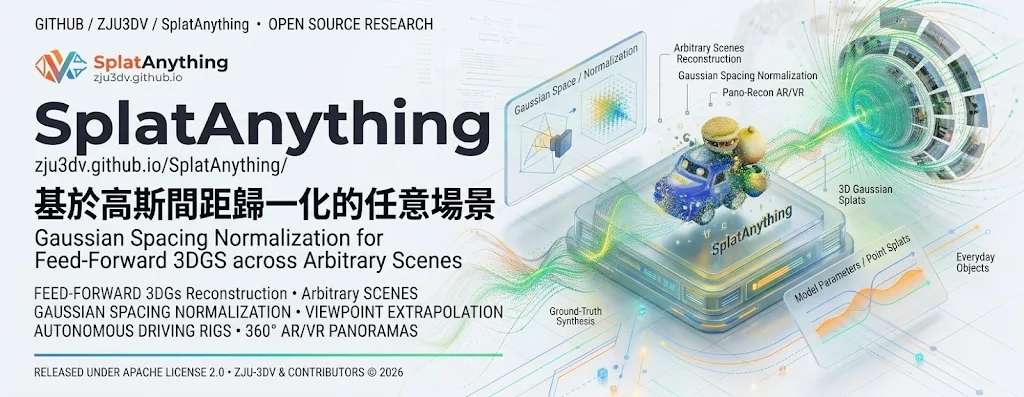
從日常物件到航拍景觀,SplatAnything 嘗試用同一模型重建不同尺度的場景,並以 Gaussian 間距正規化改善尺度變化帶來的監督歧義。

Animated SplatAnything reconstructions of objects, indoor rooms, street scenes, and aerial views

由細小物件轉到街景或航拍畫面,場景尺度和相機位置一變,3D Gaussian Splatting(3DGS)的高斯大小就較難用一致方式預測。SplatAnything 是 InfiniSplat 系列第三版的前饋式 3D Gaussian 重建模型,目標是讓單一模型處理不同類型與尺度的場景,面向自動駕駛、機械人導航、AR/VR 及遊戲開發等用途。

它的關鍵改動,是不再只按高斯到參考相機的平均徑向距離設定尺度基準,而是把場景轉換到以高斯間距正規化的空間。這讓不同場景中相似影像區域的尺度目標較一致,減少監督訊號含糊造成的覆蓋不足或高斯過度重疊。對需要跨場景重建的團隊而言,這比逐個場景調整尺度更有機會帶來穩定結果;但提供的資料未列出量化比較數字,改善幅度仍難以判斷。

模型接收多張輸入影像,亦可選擇提供相機參數;接著由凍結的幾何基礎模型估算多視角幾何,再轉換正規化空間,最後透過 Gaussian backbone 和輕量 GShead 預測每個像素的高斯屬性。這套流程結合預訓練幾何能力與專門的尺度處理,適合研究跨場景重建的人員,以及自動駕駛、導航或沉浸式內容團隊評估。

  • 一個模型涵蓋物件、人像、室內、街景及航拍場景。
  • 以高斯間距正規化,改善不同場景的尺度監督一致性。

想先檢視重建效果,可以使用 Hugging Face 示範或在項目網站瀏覽互動場景;網站亦提供下載場景 HTML 檢視器的方式。若要在本機執行推理,雖然模型權重已公開,現有文件內容不足以確認完整安裝流程、硬件需求及推理指令,宜先核對項目文件再安排測試。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Image, 3D, 自動駕駛

Video-Coder:用 AI 幫 Blender 補足影片生成的物理控制

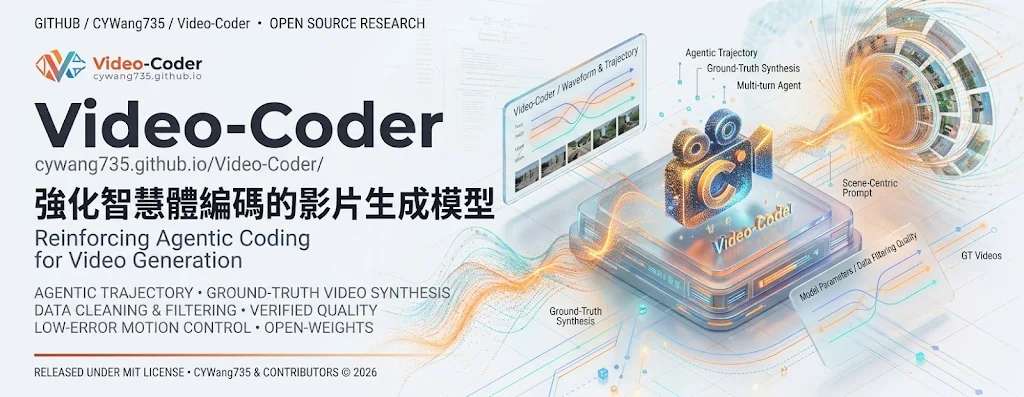
Video-Coder 先用 Blender Python 建立具結構與動態的 Draft Video,再交給影片生成器完成畫面,改善物理合理性與控制能力。

Video-Coder overview

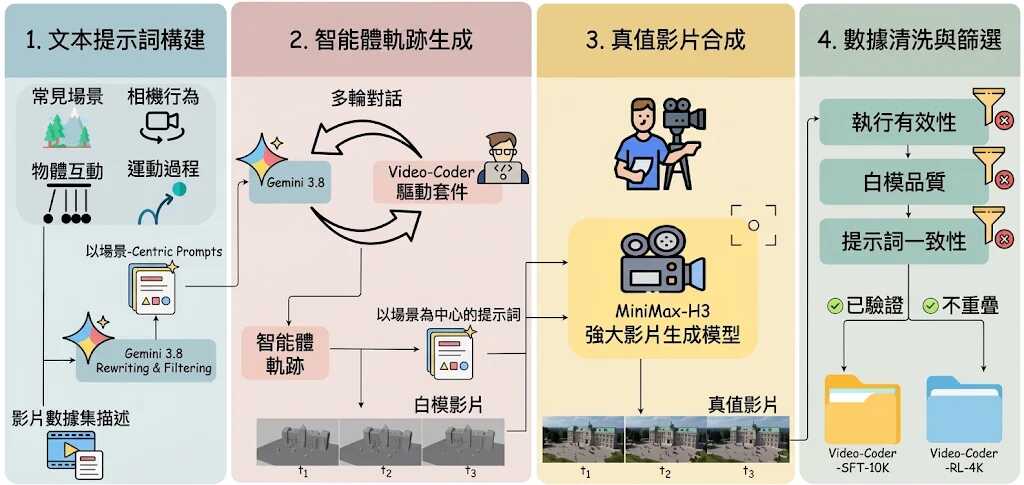
影片生成遇到物件互動、鏡頭運動或物理效果時,單靠文字直接生成往往難以穩定控制。Video-Coder 以 coding agent 身份編寫並執行 Blender Python,建立 3D 場景及 Draft Video,再把物件位置、動作和鏡頭資訊交給下游影片生成器;項目屬於影片生成代理項目,處理的是生成結果缺乏明確結構與物理約束的問題。

核心流程放在 Video-Coder Harness:代理會寫程式、執行、檢查結果,再按回饋修改程式。模型先以 supervised fine-tuning(SFT)訓練,之後接受 harness-native agentic reinforcement learning(RL);執行獎勵會逐步轉向影片獎勵,令程式能夠產生可用的場景草稿。Video-Coder-9B 建基於 Qwen3.5-9B,並可配合不同 Video generators。

  • 以可執行 3D 程式補強直接文字生成
  • Draft Video 提供結構、動作與鏡頭訊號
  • 同時提供 SFT、RL 訓練流程及訓練資料
  • Video-Coder-9B 配合 MiniMax-H3 可提升物理相關評分

評測結果顯示,Video-Coder-9B + MiniMax-H3 在 PhyGenBench 平均取得 0.67,高於 MiniMax-H3 的 0.61;VBench-2.0 平均為 78.19%,較單獨使用 MiniMax-H3 的 54.58% 高 23.61 個百分點。Mechanics 分數達 88.67%,但這些結果依賴特定模型組合,未必能直接代表所有影片生成器的效果。

項目提供 Video-Coder-9B、Video-Coder-SFT-9B 模型及 Video-Coder-train-data,並列出 SFT 和 RL 的 Python 3.12 環境設定方向;提供的資料未包含完整推理流程,訓練指令亦在輸入內容中截斷。研究團隊、影片模型開發者及需要精確控制物件互動的創作者,較容易從這套程式驅動流程受益,但使用者需要準備 Blender、模型推理及訓練所需的運算資源。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 模型訓練, Qwen, 微軟, Video, Vibe Coding, Content Creator, 3D, Python, 編程, Dataset 數據集, MiniMax, 強化學習

Confucius4-R2T2:即時語音辨識

開源串流 ASR 模型以 160 毫秒更新文字,並把未確認部分留在內部,減少字幕閃動與後續重寫。

Confucius4-R2T2

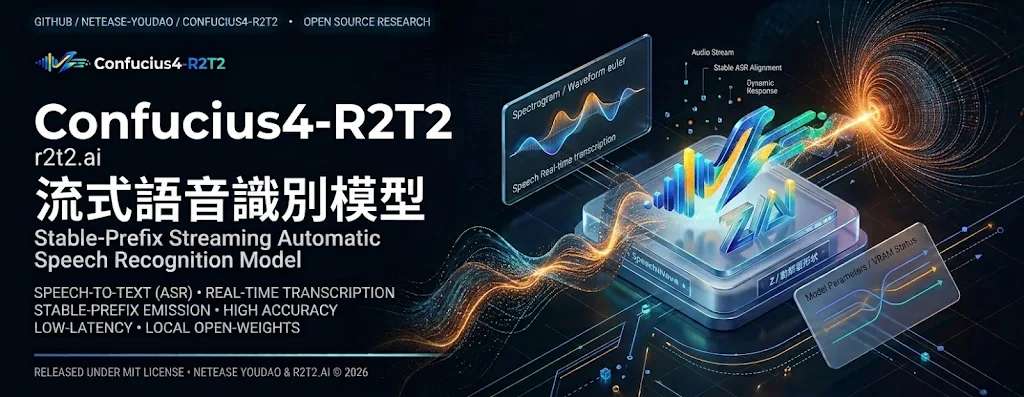
即時字幕最惱人的問題,不只是慢,而是文字一邊出、一邊改。Confucius4-R2T2 針對這個矛盾,採用只追加、不回頭修訂的穩定前綴(Stable Prefix)串流設計,已確認的文字永久提交,未確認內容則留在模型內部,適合直播字幕、即時傳譯及接入 Large Language Model(LLM)的語音流程。

這是一個開源的低延遲自動語音辨識(Automatic Speech Recognition,ASR)模型,源自 Qwen3-ASR-1.7B,透過 Longest Stable Prefix(LSP)學習及 1,500 小時中英文音訊訓練。解碼區塊可設為 80 毫秒至 2 秒,權重優先與延遲優先模式均只輸出已提交內容,並可加入主題及詞彙提示。

  • 160 毫秒(10 分之一秒)解碼、每次保留一個暫存 token 時,辨識錯誤率為 5.76%。
  • 相同串流設定下,基礎模型錯誤率為 21.01%。
  • 完整上下文參考結果的錯誤率是 5.15%,差距已相當接近。
  • 同一個 checkpoint 支援完整上下文及串流辨識,涵蓋 13 組中英文測試集。
  • 項目提供 vLLM、Hugging Face transformers 離線路徑,亦可選擇 llama.cpp 解碼。

它並非把所有即時輸出都交給下游處理,而是以 Longest Stable Prefix(LSP)學習配合 Wait 動作,訓練模型分辨哪些內容可以提交、何時需要更多音訊。訓練分為 SFT 與 GRPO 兩階段,只更新語言解碼器,音訊編碼器及 projector 保持凍結,亦沒有改變原有架構。

取捨主要落在準確度與輸出延遲之間:調整解碼區塊和暫存 token 預算即可改變兩者關係,毋須重新訓練。專注即時字幕、會議紀錄、同聲傳譯或需要即時觸發動作的 LLM Agent 團隊會較容易受惠;代價是已提交文字不能修訂,而且所報延遲未包括服務及網絡時間。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Audio, LLaMa, 語音

EvoWorld:讓鏡頭外世界持續演化並保留因果變化

EvoWorld 將 VLM 推理與視覺渲染結合,處理影片中離開視野的物件如何繼續變化,並在鏡頭返回時保留合理反應。

EvoWorld logo

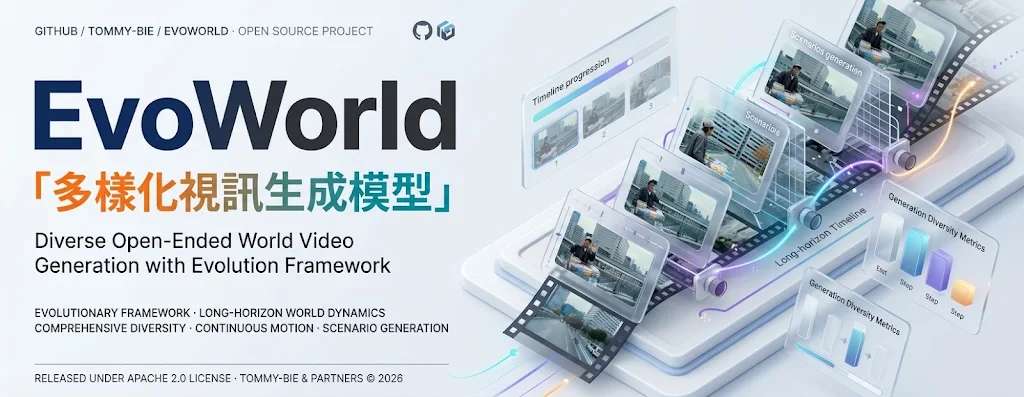
鏡頭轉開後,世界唔應該停唔轉。EvoWorld 是一套生成式影片系統,專門處理「Out-of-Sight World Evolution」(鏡頭外世界演化):物件離開畫面後仍會參與事件,等鏡頭再次回到同一人物或場景,變化亦要延續落去。

LTX-2.5 負責輸出影片:EvoWorld 作為 visual renderer,將條件轉成 896 × 512、24 fps 影片。

EvoWorld 負責「鏡頭外發生咗乜」:透過視覺語言模型做推理,再配合影片生成器,令鏡頭移開後嘅事件仍然可以發展;鏡頭返轉頭時,呈現合理嘅事件結果,而唔係只還原之前見到嘅畫面。

  • 支援事件觸發的世界演化,可由用戶指定中途發生的事件。
  • 重現原本的人物與場景,維持身份及整體連續性。
  • 渲染鏡頭外動態與因果反應,而不只是重播舊有畫面。
  • EvoWorld-Data 提供約 12,000 段影片,涵蓋 65 種事件、63 種場景及 14 種反應類型。
  • EvoWorld-Bench 設有 120 個測試案例,評估事件、重訪與反應的完整流程。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, Gemini, Video, 提示詞, 框架, Linux, Python, LTX, Dataset 數據集

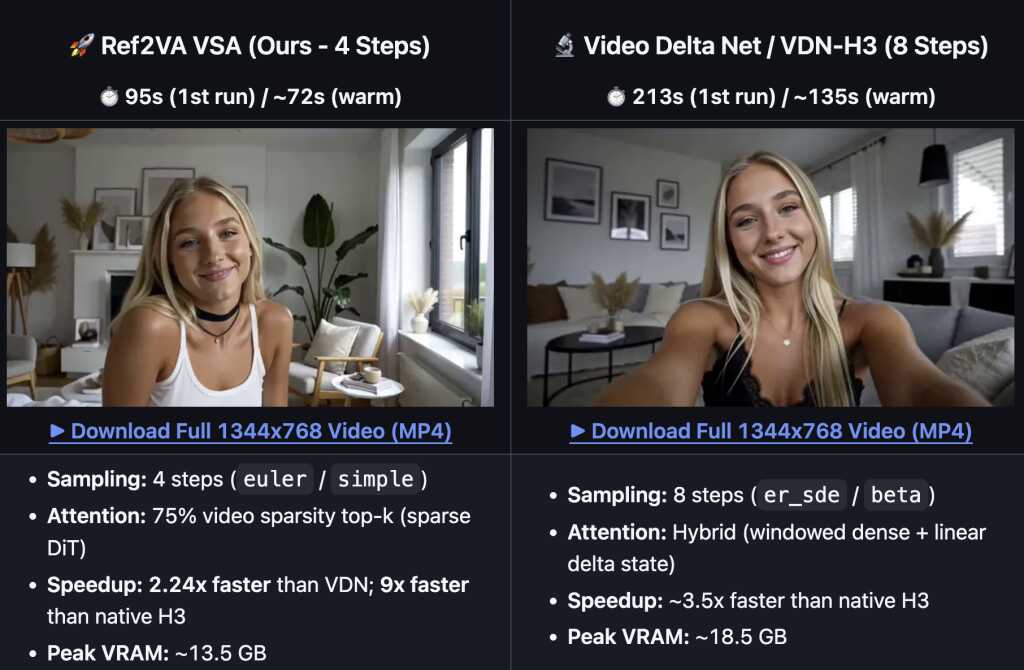
ComfyUI-Ref2VA-VSA:把角色影片生成壓至 72 秒

單張 RTX 4090 生成 5 秒角色影片只需約 72 秒,VSA 以稀疏注意力和四步取樣降低等待與記憶體需求。

Input Reference Character

角色一致性影片往往要等上一分鐘以上,迭代鏡頭時尤其影響節奏。ComfyUI-Ref2VA-VSA 是一組針對 MiniMax H3 Reference-to-Video(Ref2VA / R2VA)的 ComfyUI 自訂節點與推理優化,讓單張消費級 NVIDIA GPU 也能處理參考角色影片。

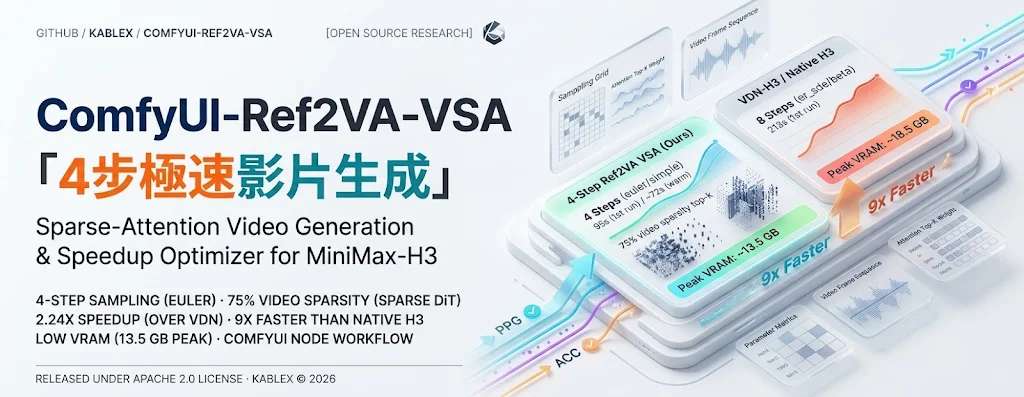
核心改動是 Video Sparse Attention(VSA):把影片注意力限制在 75% 的 top-k 稀疏範圍,配合 4 步 euler/simple 取樣。測試使用 RTX 4090 24GB,在 1344×768、24 fps、124 帧及 5.16 秒條件下,首次生成約 95 秒,預熱後約 72 秒,峰值記憶體約 13.5GB。

同一提示詞、角色參考圖、seed 與輸出規格下,VSA 比 Video Delta Net(VDN-H3)的 8 步流程快 2.24 倍,後者預熱後需約 135 秒。項目亦報告 VSA 比原生 MiniMax H3 快 9 倍,優點主要來自更少取樣步數與稀疏 Video Sparse Attention,而非單純換用另一個模型。

要開始使用,需要支援原生 MiniMax H3 的新版 ComfyUI、已安裝 comfy-kitchen 並啟用 CUDA sol attn,以及至少 24GB VRAM 的 NVIDIA GPU,例如 RTX 3090、RTX 4090、A5000 或 L40S。項目文件未列出完整安裝與操作步驟、下載連結或工作流程設定。

  • 4 步取樣,預熱後生成時間約 72 秒
  • 75% 影片稀疏 top-k attention
  • RTX 4090 測試峰值記憶體約 13.5GB
  • 支援 MiniMax H3 角色參考影片生成
  • 適合需要頻繁調整角色影片的創作者與小型團隊

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, NVIDIA, Video, 提示詞, Content Creator, 庫, MiniMax

H3 Character Sheet Designer:一次生成 13 視角角色設定表

把人物與部位參考圖直接交給 MiniMax H3,生成頭部、全身、衣物及手腳等多視角設定表。

Repository image for ukr8b3g-cmyk/H3-Character-Sheet-Designer

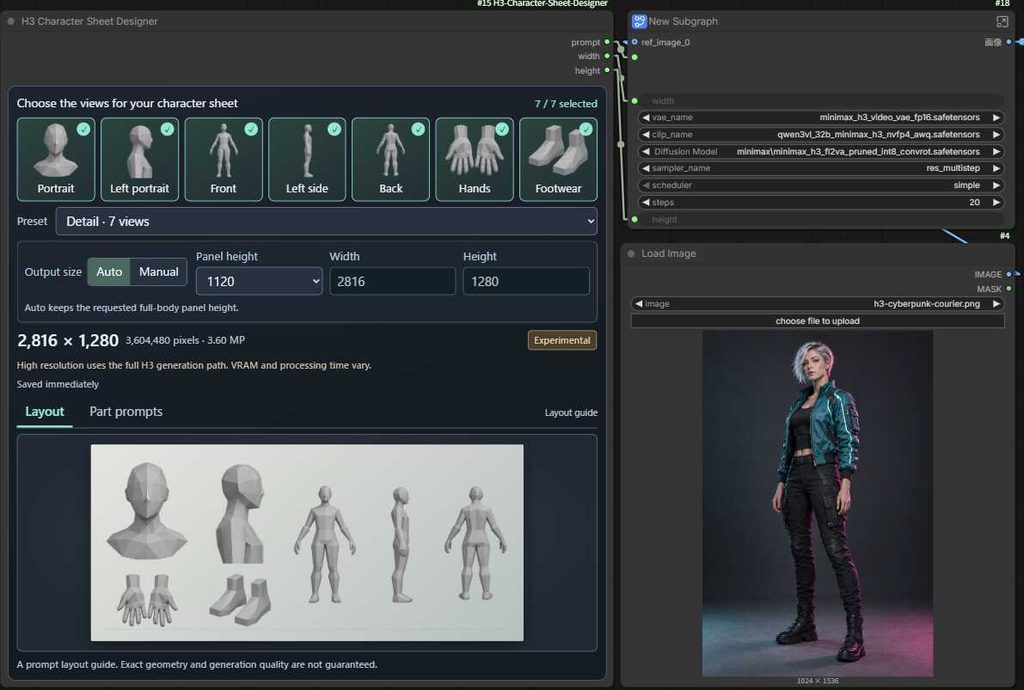
角色設定表要保持正面、側面、全身、衣物與手腳一致,最容易卡在「同一張參考圖重畫多次」這個步驟。H3 Character Sheet Designer 是一個 ComfyUI 節點包,利用 MiniMax H3 的原生圖像參考功能,接收一張人物圖及最多三張部位參考圖,再生成最多 13 個視角。

v1.3.0 加入 MOSS 風格排列與「7 views · hands and feet」預設,並保留 v1.2.2 節點,方便比較改版前後效果。ON 與 OFF 現在共用同一版面配置,Use Layout Image 只決定是否把輔助版面圖傳給 H3,關閉時仍會輸出 None。

安裝節點包後,需要重新啟動 ComfyUI、重新載入瀏覽器,再開啟 v1.3 workflow。每個 Load Image 節點都要選擇已安裝模型及有效圖片,未使用的可選輸入則應中斷連接;模型與圖片不會隨項目提供。測試比較時宜固定 seed,先關閉 Use Layout Image,再按需要切換視角、部位角色與衣物形狀。

這套流程重點是讓參考圖像直接參與 H3 conditioning。代價是 Auto 全尺寸模式可能增加輸出寬度、像素量、處理時間及 VRAM 用量;Manual 則保留指定畫布大小。

  • 最多輸出 6 個頭部視角、3 個全身視角、正背衣物、成對手部及成對腳部/鞋履
  • 一張人物圖配合最多三張部位參考圖
  • 支援 Auto、Pants、Skirt 或 robe 衣物形狀
  • 提供 7 視角 MOSS 風格版面及完整 13 視角選項

適合需要反覆整理角色視覺設定的美術、遊戲角色策劃與 3D 製作團隊。項目文件同時提醒,衣物及 13 視角結果未證明有全面提升,人物殘留、視角缺失或重複,以及衣物與全身混淆仍可能出現;正式採用前應以固定 seed 逐項核對。

GitHub

Categories: 開源, ComfyUI, 模型, Image, 3D, MiniMax

HyperFlow H3 Flash:高速生成同步影片與立體聲音

HyperFlow H3 Flash 把影片和同步立體聲音效一併生成,並以較少採樣步數及量化版本,讓消費級 RTX 顯示卡也能執行短片生成。

Repository image for Video-Rebirth/hyperflow-h3-flash

由文字提示生成影片時,HyperFlow H3 Flash 可同時產生同步的 32 kHz 立體聲音效;輸出長度為 5.2 至 15 秒,預設解像度 1344×768、每秒 24 格。它是 Video Rebirth 將 MiniMax-H3 壓縮並改為少步採樣的影片生成模型,適合快速製作帶聲短片。

模型支援三類任務:t2va 由文字生成影片;fl2va 可配合首格,或首尾兩格畫面生成;ref2va 則可參考最多 12 個素材。ref2va 在 GGUF 版本只支援圖片,Python INT8 convrot 版本則支援圖片、影片和音訊,兩種執行方式的素材範圍並不相同。

系統記憶體不多於 64 GB 的個人電腦適合使用 GGUF,並可透過 ComfyUI、Unsloth Studio 或 stable-diffusion.cpp 執行;資料中心 GPU,或配備至少 69 GiB 系統記憶體的 24 GB 以上 RTX 顯示卡,則可選 Python INT8 convrot。項目亦提供 ComfyUI 範本及 GGUF 設定指南。

模型有 4、6 或 8 步採樣,預設 6 步,而且不使用 classifier-free guidance(CFG)。在生成 5.2 秒影片的測試中,4 張 B200 用時 8.7 秒,單張 H200 用時 36 秒,單張 RTX 5090 用時 92 秒;NVIDIA SOL-H3 則支援在 4 張 B 系列 GPU 上即時執行。

模型約有 13.7B 至 13.9B 參數,不到 MiniMax-H3 約 31B 參數的一半;GGUF 的 Q4_K_M 約佔 9.1 GB,可在 24 GB 或 32 GB GPU、搭配 16 GB 系統記憶體的電腦執行,但尚未測試 16 GB GPU。使用時可按任務選擇文字、首尾畫面或參考素材,再依記憶體和 GPU 選 GGUF 或 INT8;追求較快生成則需考慮多卡配置。

  • 同步生成影片與立體聲音效,片長為 5.2 至 15 秒。
  • GGUF 較適合系統記憶體不多於 64 GB 的個人電腦。
  • INT8 convrot 支援更多 ref2va 素材類型,但記憶體需求較高。
  • 生成速度受 GPU 數量和型號影響;16 GB GPU 尚未測試。

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, 模型, NVIDIA, Video, Image, Audio, Content Creator, MiniMax

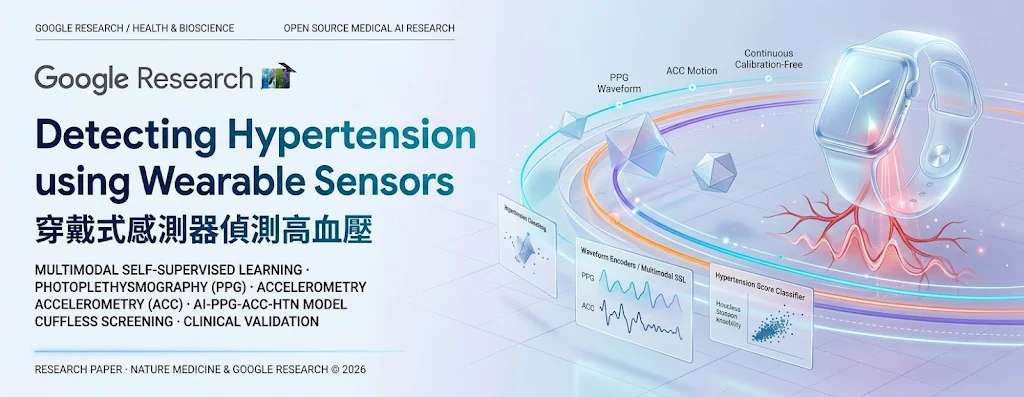
Google Research:用穿戴式感測器辨識高血壓跡象

Google Research 探索從穿戴式裝置的感測數據辨識高血壓跡象,讓日常健康監測有機會補足傳統量度以外的資訊。

Og image

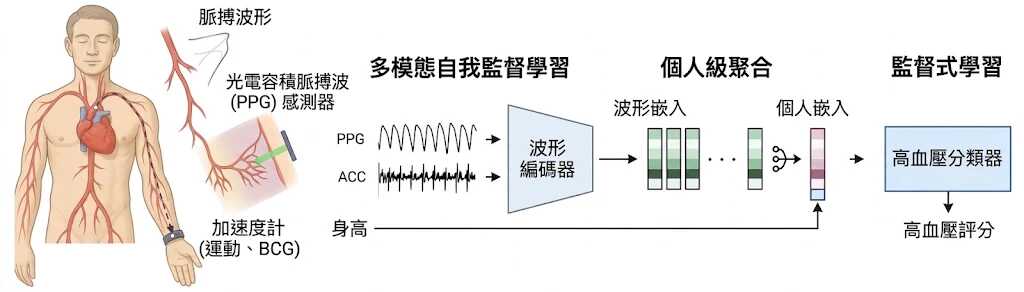
由 Google Research 團隊推動的 Health AI 研究,聚焦利用穿戴式感測器捕捉與高血壓相關的身體訊號,處理日常監測不容易持續進行的問題。穿戴式裝置能長時間收集數據,研究方向因此不只依賴單次量度,而是嘗試從連續訊號中尋找風險線索。

這類方法的應用價值,在於把健康觀察融入日常生活。使用者毋須頻繁停下來進行檢查,裝置便可在佩戴期間累積資料,再由模型分析可能與血壓異常有關的模式;不過,辨識跡象不等同於確診,結果仍需要配合正式醫療檢查及專業判斷。

項目內容反映出穿戴式感測器在醫療 AI 中的另一種用途:由被動記錄活動,進一步支援早期風險提示。對研究健康監測、穿戴式裝置或多模態生理訊號分析的人,這個方向可作為了解 Health AI 如何連接消費電子與臨床需求的例子。

  • 以穿戴式感測器收集連續健康訊號
  • 嘗試辨識與高血壓相關的風險跡象
  • 減少單次量度無法反映長期變化的限制
  • 偵測結果不能取代正式診斷

項目主頁

Categories: 模型, 多模態模型, Google, 軟件, Medical醫學

Arete-27B:後訓練調整政治敏感議題

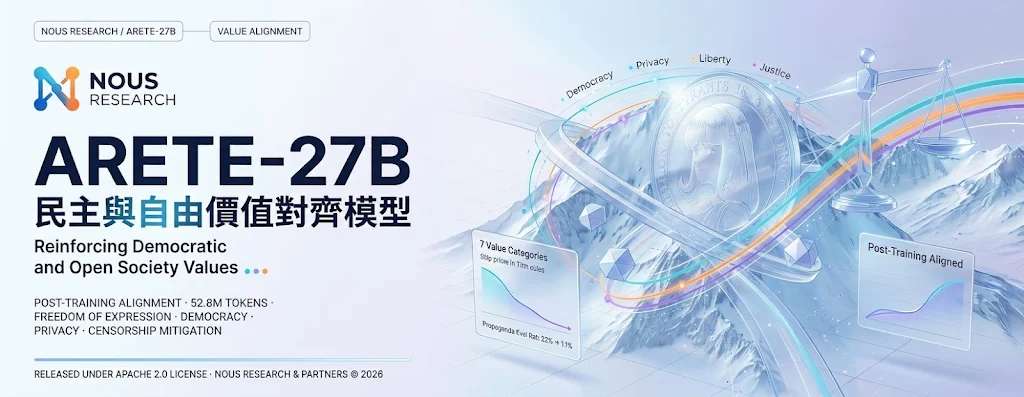
模型怎樣回答政治問題,也可以透過訓練改變。Nous Research 嘗試強化西方價值觀,但未證明偏差已消除。

Og image

Nous Research (Hermes Agent 開發團隊) 針對模型回答政治敏感問題時的拒答、迴避與敘事立場,推出 Arete-27B。這個模型以阿里巴巴的 Qwen3.8-27B 為基礎,透過後訓練強化團隊所稱的「西方價值觀」。

團隊表示,曾觀察到原模型以中國共產黨(Chinese Communist Party,CCP)的框架作答。其做法是調整模型權重中的行為,而非只在對話中加入提示詞;這代表改變價值取向,不等於令模型變得中立。

  • 以 803 條提示詞、七個價值類別量度變化。
  • 列出模型權重 Arete-27B。
  • 列出評測 Propaganda_Eval 與訓練數據 arete-data-pairs。

「中國開源模型的意識形態偏見層,其實非常薄,而且是在最後階段才被強行貼上去的(The bias layer is shallow. It is applied late, it is applied thin)。」

只要 5,000 萬 tokens 的精準數據,就能把原廠花大代價做的政治對齊剝離得一乾二淨。

這對整個開源世界來說是個極具象徵意義的信號:只要權重是開源的(Open-weight),價值觀的主導權就永遠在使用者手裡。

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 提示詞, 框架, 中國, Dataset 數據集

Page 1 of 188
1 2 3 … 188